Le 7 octobre 2026, Microsoft a publié sous la plume de Pavan Davuluri, vice-président exécutif Windows + Devices, un billet qui sert de colonne vertébrale à toute sa keynote : Building Windows for Hybrid Intelligence.
Sa thèse tient en une phrase : les agents IA vont s’installer sur le PC, ils tourneront en local quand c’est possible, passeront par le cloud quand c’est nécessaire, et Windows veut être l’endroit où l’on contrôle tout cela.
L’annonce est dense : un cadre de sécurité déclaré « disponible », trois modèles « frontière » exécutables sur la machine, un routeur, des machines à plusieurs milliers de dollars, un Copilot qui travaille sur vos fichiers. Nous ne nous sommes pas arrêtés au billet. Nous avons ouvert la documentation et le dépôt de code de la brique de sécurité, relu les fiches techniques des modèles, croisé les prix publiés par la presse et refait les calculs que Microsoft ne montre pas.
Le résultat est plus nuancé que le communiqué : plusieurs chiffres tiennent, d’autres ne disent pas tout, et au moins trois affirmations ne concordent pas d’une source à l’autre.
Le pari : faire de Windows la « maison » des agents
Le billet pose son postulat dès les premières lignes : les agents créent un changement fondamental dans la façon dont les gens travaillent. De là découle la formule centrale : Windows serait « la maison de l’intelligence hybride », un endroit où un agent s’exécute en local quand cela a du sens, rejoint le cloud quand il en a besoin, et le fait avec la sécurité et la gestion qu’attendent les organisations.
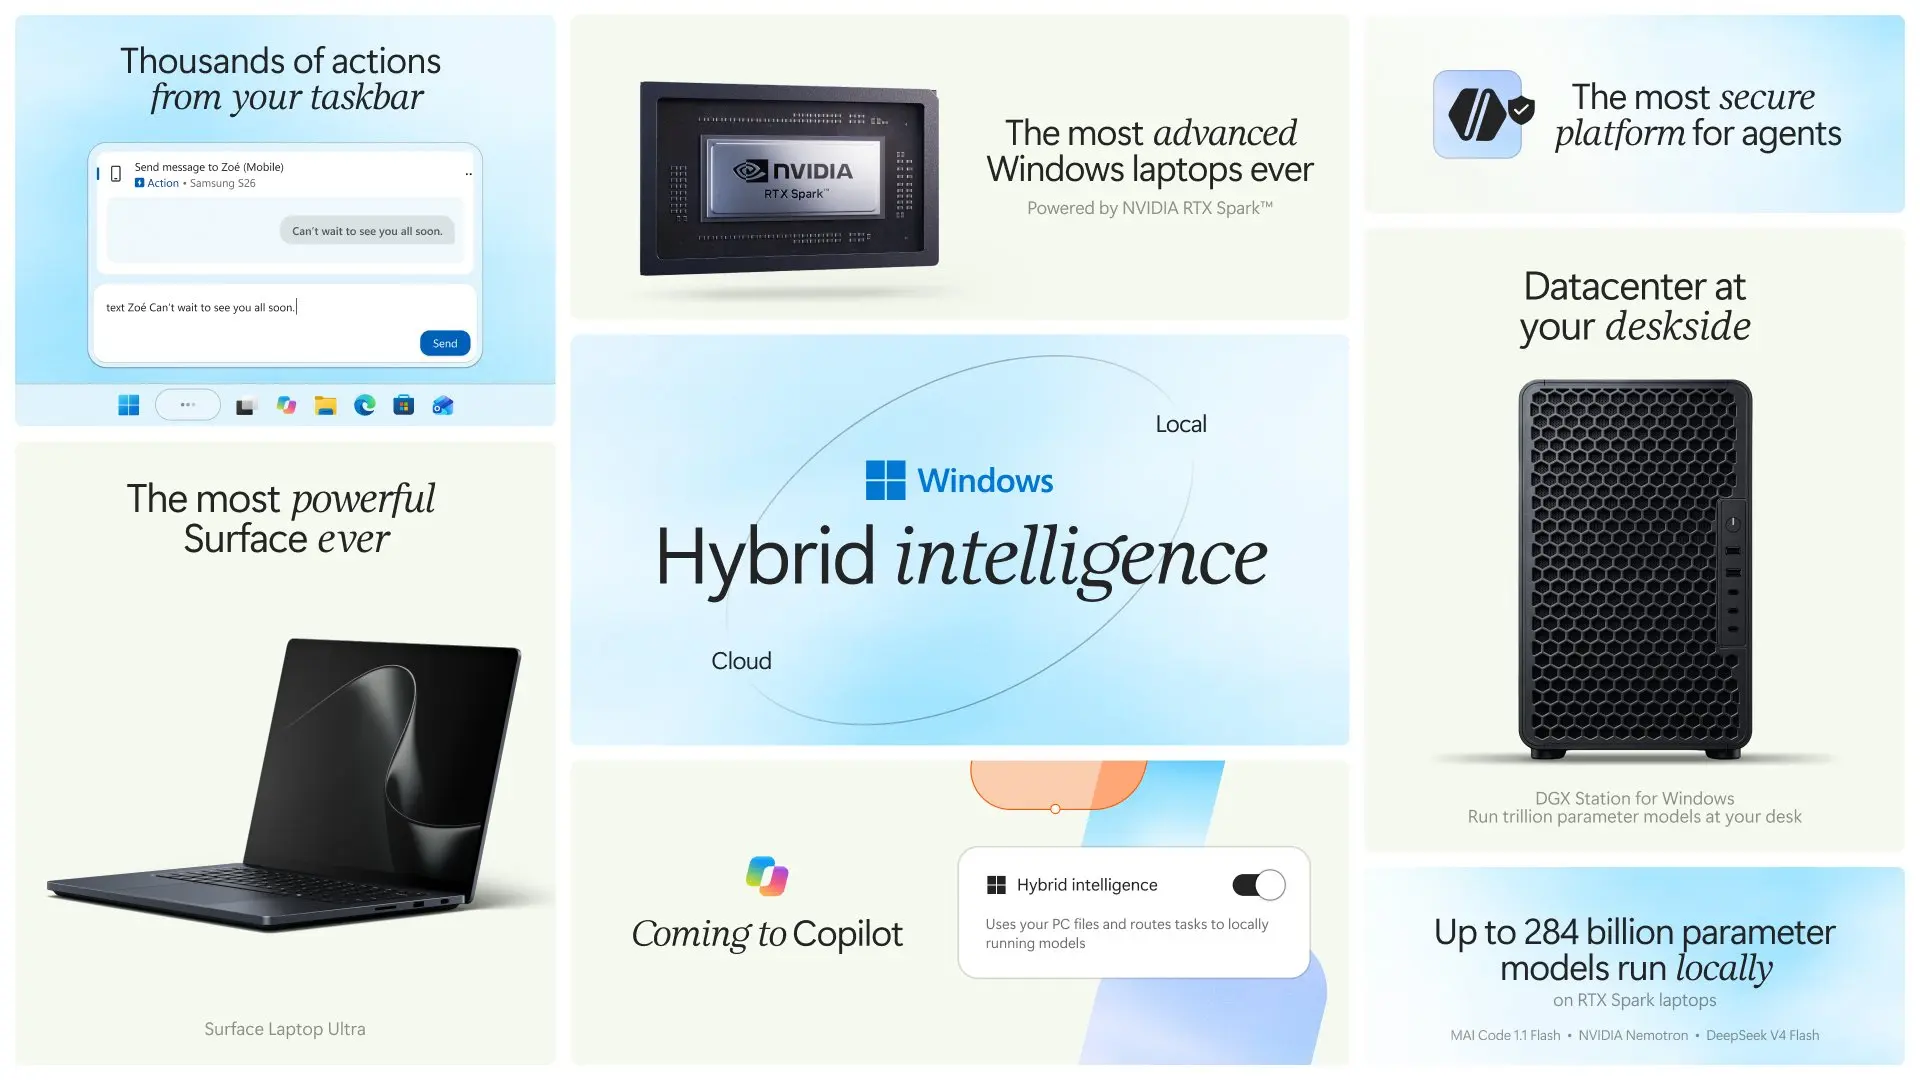
La stratégie n’est pas née ce 7 octobre. Dès Build, Microsoft expliquait vouloir reconquérir les développeurs et préparait avec Scout, héritier d’OpenClaw, un assistant autonome. Les conteneurs d’exécution de Microsoft avaient eux aussi été présentés à Build, en préversion pour développeurs, selon VentureBeat. Ce qui change aujourd’hui, c’est le périmètre : sécurité, modèles, matériel et interface sont présentés comme un seul système, vendu sous un seul mot, « hybride ».
« Windows est la maison de l'intelligence hybride »
Sécurité : ce que MXC garantit, et ce que sa documentation avoue
Premier pilier, et premier élément déclaré « en disponibilité générale » : les Microsoft Execution Containers (MXC). Le billet du Windows Developer Blog décrit un système de politiques : le développeur ou l’administrateur déclare les fichiers, les destinations réseau et les ressources d’interface qu’un agent peut utiliser, et Windows choisit le conteneur chargé de faire respecter ces règles. Principe affiché : une politique reste extérieure à l’agent, qui ne peut donc pas s’accorder des droits supplémentaires.
Quatre niveaux d’isolation sont proposés : un conteneur de processus (AppContainer sur Windows, aussi disponible sur macOS et Linux), un conteneur de session (compte et bureau distincts de l’utilisateur, Windows 11 uniquement), WSLc pour les chaînes d’outils Linux, et une micro-machine virtuelle. Trois modes d’exploitation facilitent l’écriture des règles : « application » (tout accès non accordé est bloqué), « apprentissage » (bloqué et consigné dans un rapport JSON) et « permissif » (autorisé mais consigné). Le code est publié sous licence MIT, avec des kits pour Rust, .NET et Node. C’est une vraie base de travail.
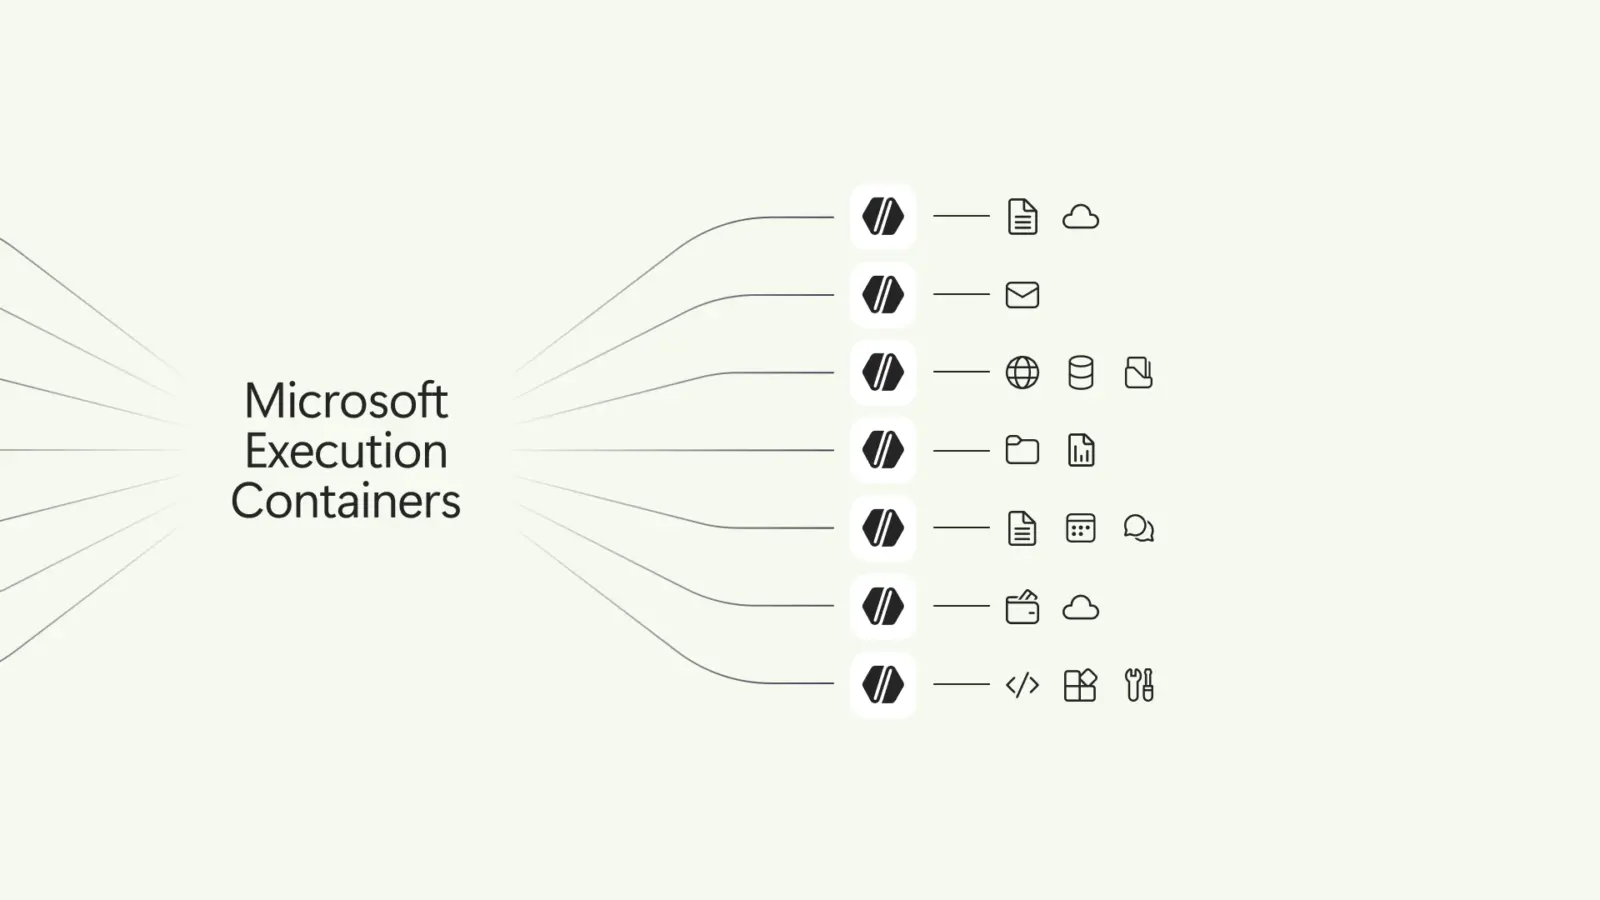
Les agents déjà compatibles sont Codex d’OpenAI, GitHub Copilot, OpenClaw, Replit, LM Studio, OpenShell de NVIDIA et Unsloth AI. Suivront Claude Code, Box, Egnyte, Heidi Health, Hermes Agent, Manus, Perplexity, Raycast et Simular. Meta prépare aussi une application native, Muse pour Windows.
Ce que le dépôt de code révèle sur la maturité. Nous avons consulté le dépôt GitHub de MXC et son historique. Jusqu’au 6 octobre, son README portait un avertissement : le code était une préversion, certaines politiques générées étaient « trop permissives » et, en substance, aucun profil MXC ne devait être traité comme une frontière de sécurité. Un commit intitulé « Remove preview disclaimer from README » a supprimé cet avertissement le 6 octobre, la veille de l’annonce de disponibilité générale. Les backends Windows Sandbox, micro-VM et Hyperlight restent étiquetés expérimentaux ; WSLc est devenu stable avec la version 0.9, publiée le 21 septembre. Le projet a donc mûri vite, ce que souligne l’analyste Rajesh Beri : de la préversion de Build en juin à la disponibilité générale d’octobre, quatre mois.
Que dit la documentation sur les limites ? Pour la session isolée, la documentation d’architecture indique que le réseau ne peut pas être filtré (la politique doit déclarer une posture « tout autorisé ») et que la session isole l’interface de l’hôte sans refuser au code contenu ses propres capacités d’interface. Pour Windows Sandbox, le refus de chemins de fichiers n’est qu’un rejet « au mieux » à la création, explicitement « pas une frontière de sécurité renforcée ». Dans une analyse du code datée de juin, Origin relevait aussi des trous dans le filtrage des chemins (noms courts 8.3, liens symboliques, jonctions) et des filtres réseau « coopératifs » que des connexions brutes contournent. Nous n’avons pas pu vérifier lesquels subsistent. Rien de scandaleux pour un projet jeune et documenté ouvertement, mais le billet de lancement n’en dit rien.
Reste le plus important pour une entreprise : les contrôles de flotte. D’après le billet développeur, la gestion par Intune des conteneurs de processus, la distinction par Entra entre l’activité de l’agent et celle de l’utilisateur, et les contrôles Agent 365 sur les agents locaux sont « à venir », sans date. Pour Rajesh Beri, MXC est donc d’abord un bac à sable côté développeur à piloter, non un contrôle géré : le développeur de l’agent écrit la politique, le mode « application » bloque sans journaliser, l’option --audit désactive toute la sécurité (à ne pas confondre avec le mode « apprentissage », qui garde l’application active) et le bac à sable du Copilot local autorise Internet en sortie par défaut.
C’est une lecture d’analyste, pas un fait établi, mais elle rejoint VentureBeat : le plus difficile n’est pas de bâtir le bac à sable, c’est d’écrire les politiques qu’on y met. Côté configuration minimale, le dépôt exige la build 26100.9278 de Windows 11 24H2 (mise à jour d’août 2026) pour le conteneur de processus et la 26100.9550 (septembre) pour la session. Une note de bas de page du billet principal le dit à sa façon : la gouvernance à grande échelle « peut nécessiter des services supplémentaires ».
Local contre cloud : le calcul de la mémoire, vérifié
C’est la partie la plus spectaculaire : trois modèles de code présentés comme « frontière » deviennent exécutables sur un PC Windows.
- MAI Code 1.1 Flash : 137 milliards de paramètres au total, dont 6,8 milliards actifs, en précision 3 bits, avec une fenêtre de contexte de 256 000 jetons ;
- NVIDIA Nemotron : plus de 70 milliards de paramètres, quantifié en 2 bits, pour environ 20 Go de mémoire ;
- DeepSeek V4 Flash : 284 milliards de paramètres, annoncé dans 60 Go de mémoire lors de la keynote, ce qui correspond à une quantification vers 1,6 bit.
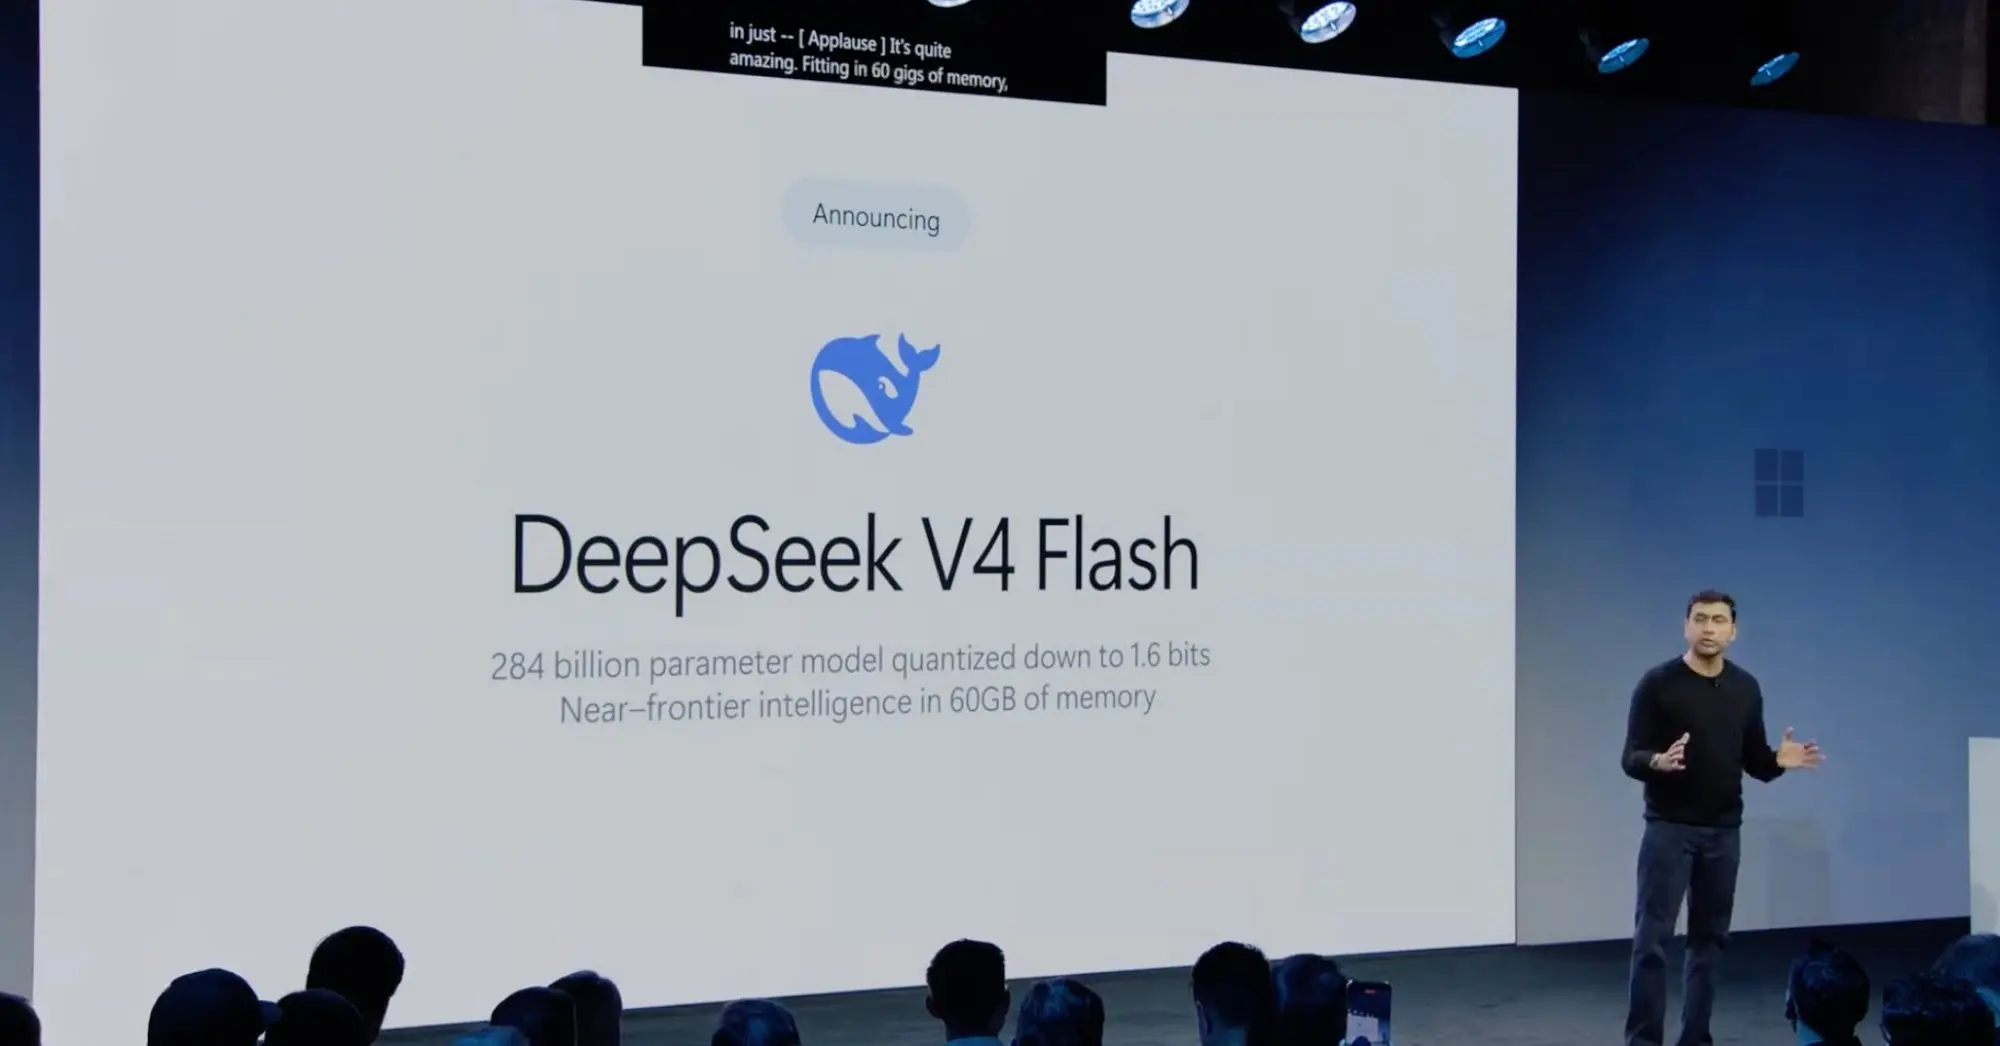
Premier test : l’arithmétique de base, paramètres × bits ÷ 8. Pour MAI Code, 137 milliards × 3 bits donnent environ 51 Go. Pour Nemotron, 70 milliards × 2 bits donnent environ 17,5 Go, cohérent avec les 20 Go annoncés. Les « 80 % » de réduction de MAI Code correspondent au passage de 16 à 3 bits. Sur le papier, tout tient.
Deuxième test, beaucoup moins confortable : DeepSeek V4 Flash. Les 284 milliards × 1,6 bit ÷ 8 donnent bien environ 57 Go, soit le chiffre de Microsoft. Pourtant, la documentation d’Unsloth, qui publie les quantifications de référence de ce modèle, indique une mémoire totale recommandée de 92 Go pour sa version la plus compressée (« 1 bit »), 102 Go en 2 bits, 162 Go en 4 bits et 169 Go sans perte. La raison est connue : DeepSeek V4 Flash est entraîné nativement avec 96 % de ses poids (les « experts ») en MXFP4, un format d’environ 4 bits, et le reste en FP8 ou BF16. Les quantifications sérieuses protègent ces parties sensibles au lieu de tout écraser à la même précision, ce qui alourdit le fichier.
L’écart de 60 Go à 92 Go ne prouve pas que Microsoft se trompe : sa version est peut-être plus agressive, ou mesurée autrement (hors cache et hors système). Mais il montre que le raccourci « paramètres × bits » minimise la réalité, et que le résultat annoncé, une « intelligence proche de la frontière » dans 60 Go, repose sur une compression que personne n’a encore évaluée publiquement. À titre de repère, Unsloth mesure pour sa quantification 4 bits une divergence faible avec le modèle d’origine (96,3 % d’accord sur le jeton le plus probable) ; nous n’avons trouvé aucune mesure équivalente pour une version à 1,6 bit.
Vitesse : la bande passante, le chiffre qui manque
Tenir en mémoire ne suffit pas, il faut aussi répondre vite. Pour un modèle de langage, le débit en génération est largement limité par la quantité de données que la puce peut lire par seconde. Microsoft ne publie pas la bande passante mémoire du Surface Laptop Ultra. HotHardware l’estimait en juin à environ 273 Go/s pour la puce RTX Spark, d’après la puce voisine DGX Spark, contre 307 Go/s pour l’Apple M5 Pro. Cette valeur est une estimation à confirmer, pas une mesure sur la machine commerciale.
Une mesure tierce donne un repère, sur une puce de la même famille. L’auteur de ComputingForGeeks relaie le relevé d’un utilisateur du forum NVIDIA pour DeepSeek V4 Flash en 2 bits (90,9 Go) sur un DGX Spark de 128 Go : environ 19 jetons par seconde en génération et environ 460 en traitement du prompt, soit une vingtaine de secondes avant le premier jeton pour un prompt de 10 000 jetons (calcul de l’auteur). Ce n’est ni la machine de Microsoft ni la même quantification, et l’auteur précise n’avoir pas mesuré la qualité. Mais cela situe l’ordre de grandeur : lisible pour converser, plus lent pour un agent qui enchaîne des dizaines d’appels.
Cela relativise aussi les comparaisons du billet face au MacBook Pro M5 Pro 64 Go : 2,1 fois plus rapide jusqu’au premier jeton, 4,3 fois en génération d’images, 6,2 fois en génération vidéo. Ces chiffres viennent de tests commandités par Microsoft en septembre 2026, et ceux sur l’image et la vidéo de tests NVIDIA, sur des machines de préproduction selon la page produit. Aucun test indépendant n’existe à ce stade, et lors de sa prise en main, Engadget indique ne pas avoir vu la machine effectuer de travail d’IA significatif. Sur le seul processeur, HotHardware relève que la puce DGX Spark, de même famille, se classe derrière l’M5 Pro dans les mesures de Phoronix : l’avantage revendiqué se joue sur le GPU et les gros modèles, pas partout.
HydraFusion : l’argument du budget
Pour décider quelle tâche part en local et laquelle part au cloud, Microsoft étend à Windows GitHub HydraFusion, un routeur de modèles annoncé en préversion expérimentale dans l’application Copilot, la ligne de commande et Visual Studio Code. L’outil existe déjà : GitHub l’a lancé en recherche préliminaire dans Copilot CLI.
D’après la discussion publique de GitHub, il choisit pour chaque demande un flux de travail (un modèle seul, une cascade où un modèle économique rédige avant escalade, ou une critique croisée) et revendique, sur le banc TerminalBench 2.1, 4,9 points de qualité en plus et un coût estimé inférieur de 67 % à celui de Claude Opus 5.
Ce sont des chiffres de GitHub, et la préversion ne fait pas l’unanimité sur la transparence. Le même fil signale que la liste des modèles utilisés n’est pas publiée, que les brouillons intermédiaires sont masqués et que l’outil ne respecterait pas les modèles désactivés par une entreprise. Les premiers retours d’utilisateurs y rapportent des économies souvent très marquées. À sa publication, la discussion ne mentionnait pas de modèles locaux : l’apport de Windows serait donc précisément de relier ce routage au PC. C’est probablement l’argument le plus fort de l’annonce, à l’heure où le prix des agents de code pèse.
L’été a vu DeepSeek durcir ses tarifs et Meta lancer Muse Code comme alternative moins chère. Côté exécution, Windows ML prend en charge llama.cpp pour les modèles ouverts, sur GPU, NPU et CPU.
Le matériel : prix, mémoire et supercalculateur
La page produit française affiche le Surface Laptop Ultra à partir de 2 899 euros, en précommande, avec une disponibilité au 16 octobre dans le Microsoft Store. Ce prix d’appel correspond à la version d’entrée : puce à 18 cœurs et GPU de 5 120 cœurs, 24 Go de mémoire unifiée, SSD de 512 Go, Windows 11 Famille. La page annonce « jusqu’à 20 cœurs », « jusqu’à 128 Go de mémoire unifiée » et jusqu’à 2 To de stockage.
Le constat qui compte pour l’IA locale : la mémoire est la variable qui coûte. À puce identique, passer de 32 à 64 Go ajoute 720 euros (soit 22,50 euros le gigaoctet), et de 64 à 128 Go ajoute 1 920 euros (30 euros le gigaoctet). La version à 128 Go, la seule qui conditionne les modèles de 120 milliards de paramètres vantés par Microsoft, coûte 6 879 euros, soit 2,4 fois le prix d’appel. Elle n’existe qu’avec la puce à 20 cœurs et Windows 11 Professionnel.
Les notes de bas de page précisent que les mesures d’autonomie et de performances viennent d’unités de préproduction testées en septembre, équipées de 64 Go et de 1 To, et que le GPU ne peut pas adresser toute la mémoire. Aucune mesure ne porte donc sur la version à 128 Go. Autres détails : l’écran tactile n’accepte pas les stylets Surface, et Engadget précise qu’un câble USB-C standard fonctionne aussi sur le port prévu pour le câble magnétique.
| Appareil | Ce que l’on sait | Disponibilité |
|---|---|---|
| Surface Laptop Ultra | À partir de 2 899 € en France (2 599 $ aux États-Unis) ; jusqu’à 128 Go de mémoire unifiée ; prix de la version 128 Go non affiché par Microsoft | Précommande ; expédition le 16 octobre selon le billet |
| Surface RTX Spark Dev Box | Environ 6 000 $ (5 999 $ selon The Gadgeteer) ; 128 Go ; vendu par Microsoft aux États-Unis | Précommande, expédition en novembre |
| ASUS ProArt P16 / P14 | Dalle OLED, machines fines pour créateurs ; prix non précisé | Précommande, 16 octobre |
| Dell XPS 16 Creator Edition | Premier XPS à puce RTX Spark ; prix non précisé | Précommande, 16 octobre |
| HP OmniBook Ultra 16 | Châssis ultrafin, refroidissement revu ; prix non précisé | Précommande, 16 octobre |
| Lenovo Yoga 9n 2-en-1 | Charnière 360°, stylet sur les deux faces ; prix non précisé | Précommande, 16 octobre |
| MSI Prestige N16 Flip AI+ | 2-en-1 16 pouces, OLED Tandem UHD+, batterie de 99,9 Wh ; prix non précisé | Précommande, 16 octobre |
Notre dossier sur les prix annoncés par NVIDIA et notre article sur les premiers portables IA donnent le contexte des machines RTX Spark.
Un supercalculateur qui n’est pas une nouveauté. Au sommet de la gamme, le DGX Station pour Windows : puce NVIDIA GB300 Grace Blackwell Ultra, jusqu’à 748 Go de mémoire cohérente, 20 pétaflops en FP4, des modèles jusqu’à 1 000 milliards de paramètres. Le billet de Microsoft le présente dans la foulée des autres annonces, mais NVIDIA l’avait dévoilé dès le 31 mai. Le communiqué annonce une disponibilité au quatrième trimestre 2026 chez six constructeurs (ASUS, Dell, GIGABYTE, HP, MSI et Supermicro), là où le billet de Microsoft ne cite que Dell et HP. Aucun prix n’est publié.
Côté parc installé, Microsoft avance deux chiffres : plus de 2 000 milliards d’inférences locales par mois sur les PC Copilot+, et 40 % des portables d’entreprise désormais équipés comme tels. Ni l’un ni l’autre n’est accompagné d’une base de comparaison ou d’une méthode de mesure.
Copilot, Recherche, jeu : ce que le local change au quotidien
Sur les PC Copilot+, Copilot gagne trois capacités locales : le contexte local (accès, avec autorisation, aux fichiers et à l’activité récente), les actions locales (organiser des fichiers, diagnostiquer, coder) et les modèles locaux. Elles se déclinent dans Home, Code (création d’applications Windows natives à partir d’une description) et Autopilot, un agent personnel persistant et proactif. Le déploiement doit commencer « dans les prochains mois », selon l’appareil, le marché et le silicium. C’est la suite de la fusion des Copilot en une seule application.
La recherche de la barre des tâches apprend à agir : passer en mode sombre, activer Ne pas déranger ou le mode avion, atténuer l’écran, couper le son, organiser les fenêtres, envoyer un SMS à un contact. Des réponses Copilot en ligne, facultatives, arriveront plus tard en 2026 sur certains marchés. Le tout est testable dès aujourd’hui dans le canal expérimental de Windows Insider.
Enfin, le jeu : Windows sur Arm progresse avec Prism, la compatibilité des anti-triche et l’application Xbox PC. Fortnite, Alan Wake 2 et World of Warcraft: Forever sont déjà cités ; League of Legends, Valorant, PUBG: Battlegrounds et Genshin Impact doivent suivre, et Call of Duty est annoncé pour RTX Spark en 2027. Gears of War: E-Day sert de vitrine à l’Advanced Shader Delivery, qui ramène la compilation des shaders de quelques minutes à quelques secondes.
Windows Central, qui a pris la machine en main, titre pourtant que son GPU a de quoi jouer mais qu’il ne la recommande pas aux joueurs PC.
Ce qu’il faut retenir, et ce qu’il reste à vérifier
Réellement utilisable aujourd’hui : le conteneur de processus MXC et ses modes d’apprentissage, les précommandes, la recherche enrichie pour les Insiders. Bientôt : HydraFusion en préversion en octobre, les premières livraisons le 16 octobre, le Dev Box en novembre, les DGX Station au quatrième trimestre.
À confirmer : le niveau de maturité réel de MXC, l’identité par agent, la gestion Intune, Copilot local « dans les prochains mois ».
Cinq points méritent d’être suivis : le statut réel de MXC (disponibilité générale annoncée, avertissement de sécurité retiré la veille, contrôles de flotte à venir) ; les 60 Go de DeepSeek face aux 92 Go de la quantification de référence ; le prix des configurations à grande mémoire, absent de la page de Microsoft ; la vitesse réelle des modèles locaux, qu’aucun test indépendant n’a encore mesurée sur la machine ; le caractère « nouveau » du DGX Station. Le cadre est posé et le calendrier est précis. Sa solidité se mesurera à l’usage.