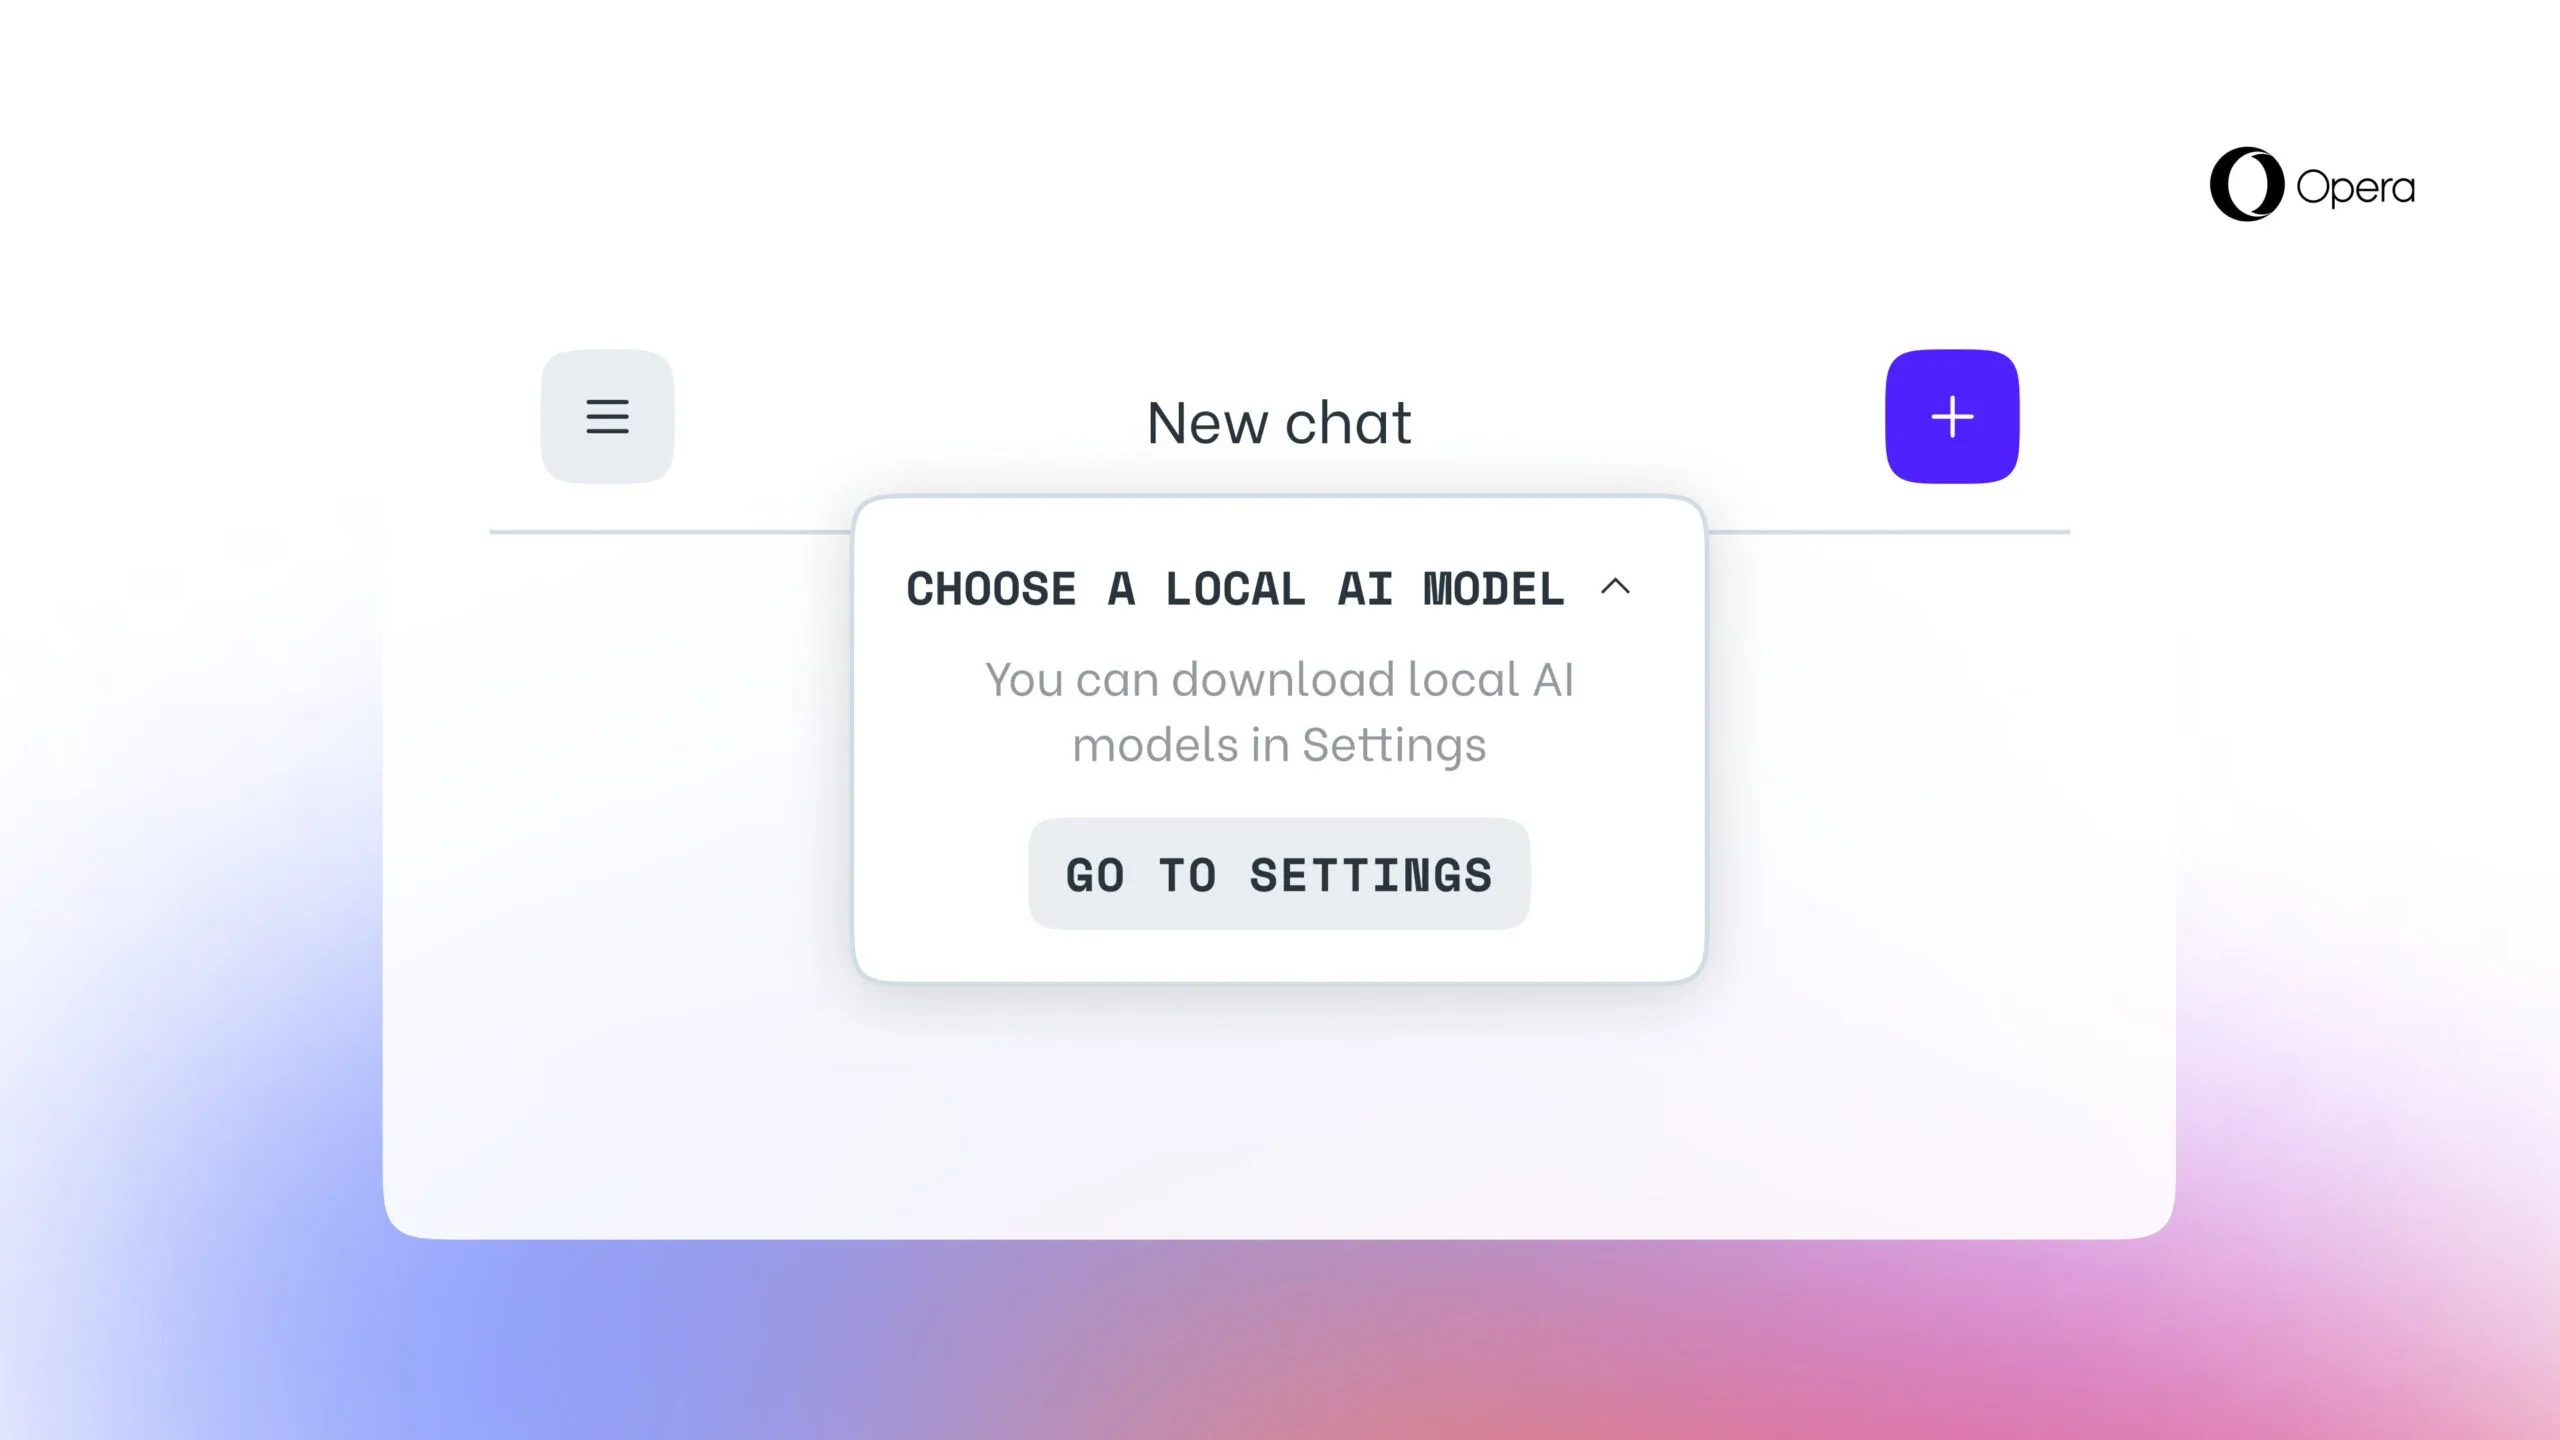

Opera continue d’innover dans le domaine de l’intelligence artificielle, et a récemment annoncé une fonctionnalité unique parmi les navigateurs : l’accès aux modèles IA locaux.
Cette nouvelle avancée permet aux utilisateurs d’exploiter et de gérer directement des modèles de Large Language Model (LLMUn LLM (grand modèle de langage) est une IA entraînée sur d'immenses volumes de textes pour prédire le mot suivant, et ainsi comprendre et rédiger du langage. Lire la fiche) locaux à partir du navigateur, une première dans l’industrie.
L’ajout de cette fonctionnalité expérimentale inclut le support de 150 variantes de LLM locaux issus d’environ 50 familles de modèles, rendant possible l’utilisation de modèles tels que Llama (de Meta), Vicuna, Gemma (de Google), Mixtral (de Mistral AIMistral AI est la startup française d'IA fondée en 2023, championne européenne de l'open source, des modèles de langage et du chatbot Le Chat (renommé Vibe), avec un fort accent sur la souveraineté. Lire la fiche), et bien d’autres encore. Cette initiative complète le service Aria AI en ligne d’Opera, qui reste accessible depuis les navigateurs Opera sur iOS et Android. Ce dernier était conçu comme un chatbot dans la même veine que CopilotMicrosoft Copilot est la marque regroupant les assistants IA de Microsoft, devenue en 2026 une plateforme d'agents capables d'exécuter des tâches, intégrée à Windows et Microsoft 365. Lire la fiche de Microsoft et ChatGPTChatGPT est l'assistant IA d'OpenAI : devenu en 2026 une plateforme multimodale et agentique, il écoute, parle, voit, navigue sur le web et exécute des tâches à votre place. Lire la fiche d’OpenAI.
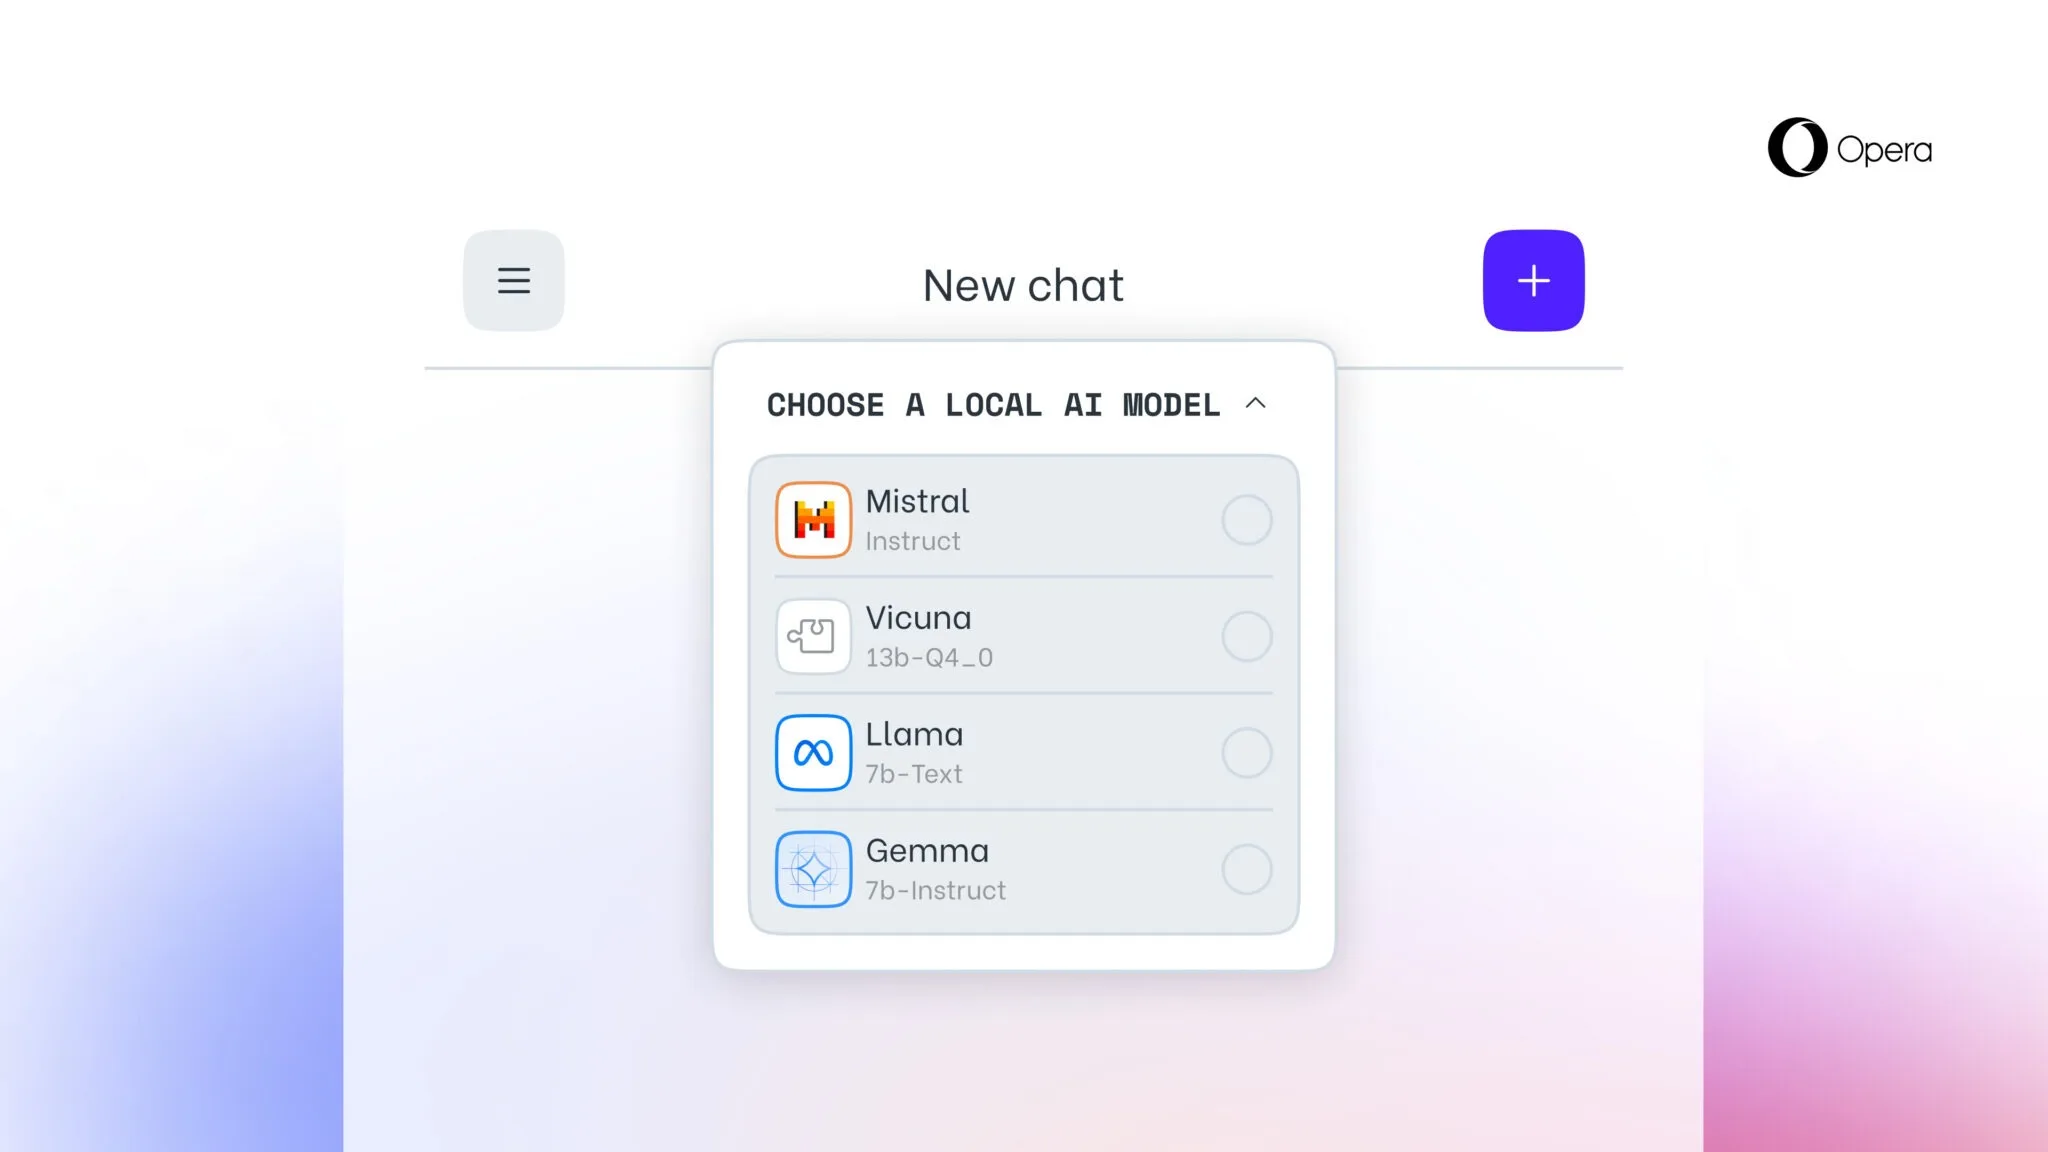
Cependant, la principale différence entre Aria, Copilot (qui n’aspire qu’à fonctionner localement à l’avenir) et les chatbots IA analogues est qu’ils dépendent d’une connexion Internet à un serveur dédié. Opera affirme qu’avec les LLM exécutés localement qu’il a ajoutés à Opera One Developer, les données restent locales sur les PC des utilisateurs et ne nécessitent pas de connexion Internet, sauf pour télécharger le LLM au départ.
En effet, l’intérêt majeur de cette innovation réside dans la confidentialité qu’elle offre aux utilisateurs. La possibilité d’accéder à des LLM locaux signifie que les données des utilisateurs sont conservées sur leur propre appareil. Cela permet d’utiliser l’IA générativeL'IA générative est une intelligence artificielle qui crée du texte, des images, des vidéos, du son ou du code à partir d'une simple demande écrite. Lire la fiche sans nécessiter l’envoi d’informations vers un serveur externe, préservant ainsi la vie privée des utilisateurs.
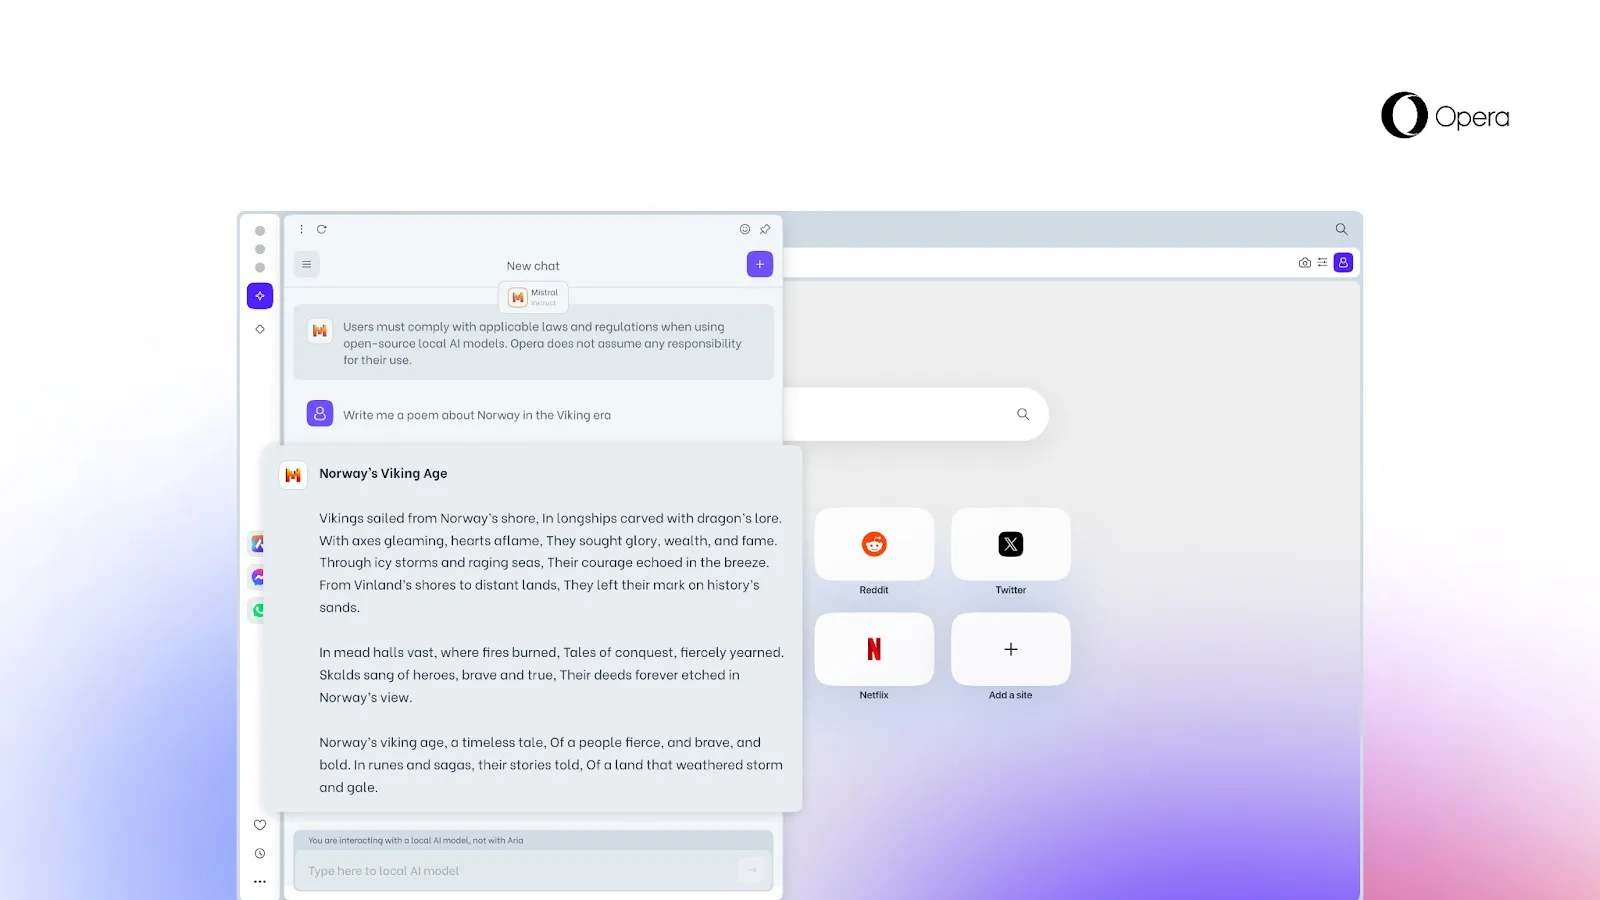
Opera va devoir télécharger un LLM localement
Opera a également émis l’hypothèse d’un cas d’utilisation potentiel pour sa nouvelle fonction LLM locale. « Et si le navigateur du futur pouvait s’appuyer sur des solutions d’intelligence artificielle basées sur l’historique de vos saisies tout en contenant toutes les données sur votre appareil ? ». Si les adeptes de la protection de la vie privée apprécient probablement l’idée que leurs données soient conservées sur leur PC et nulle part ailleurs, un LLM basé sur un navigateur qui se souvient d’autant de choses n’est peut-être pas aussi attrayant.
Cette fonctionnalité est désormais disponible pour les utilisateurs d’Opera One Developer, nécessitant toutefois la mise à jour vers la version la plus récente de Opera One Developer et le suivi d’un guide pas à pas pour son activation.
Une exécution nécessairement plus lente qu’en ligne
Il est important de noter que la sélection d’un LLM spécifique entraînera son téléchargement sur l’appareil de l’utilisateur, nécessitant entre 2 et 10 Go d’espace de stockage par variante. Une fois téléchargé, le nouveau LLM remplacera Aria, l’IA native du navigateur Opera.
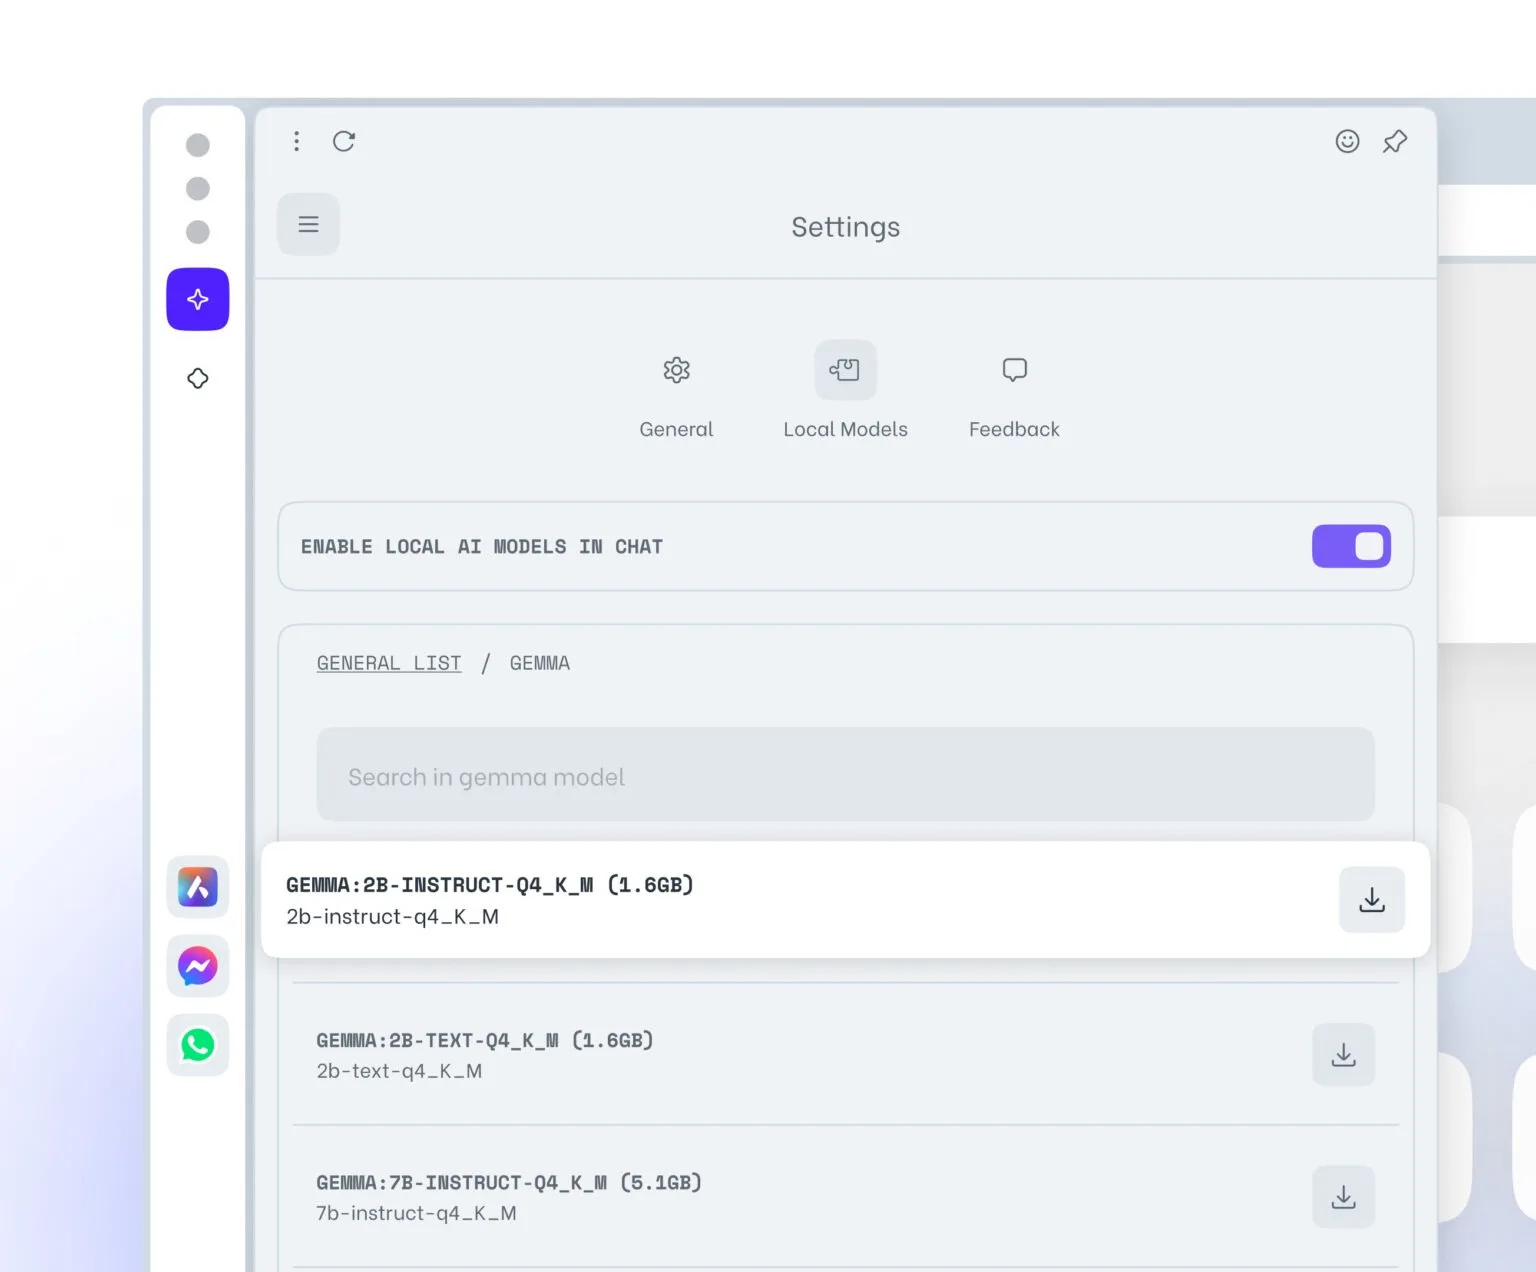
Étant donné qu’il peut être difficile de rivaliser avec de gros serveurs équipés de GPU haut de gamme de sociétés telles que Nvidia, Opera affirme que le fait d’opter pour une solution locale sera probablement « considérablement plus lent » que l’utilisation d’un LLM en ligne. Il n’y a pas à dire.