
Google poursuit sa stratégie autour des modèles d’IA ouverts avec EmbeddingGemma 2, un modèle de 740 millions de paramètres capable de transformer du texte, du code, des images, de l’audio et de la vidéo dans un même espace numérique.
Surtout, il peut fonctionner entièrement en local sur un smartphone ou une petite carte informatique, sans envoyer les données vers le cloud.
Le modèle utilise environ 191 Mo de mémoire pour les tâches textuelles sur un Pixel 11 Pro, et environ 567 Mo lorsqu’il exploite l’ensemble de ses capacités multimodales. Pour certaines applications, cela ouvre la voie à des systèmes de recherche et de récupération sémantique capables de fonctionner hors ligne.
Une seule représentation pour cinq types de données
EmbeddingGemma 2 transforme les différents contenus en vecteurs numériques partageant un espace commun de 768 dimensions. Un logiciel peut ainsi rechercher du contenu en fonction de sa signification plutôt que de simplement comparer les mots utilisés.
C’est le principe d’un modèle d’embedding. Un texte, une image, un fichier audio ou une vidéo peuvent être convertis en représentations numériques permettant ensuite à une application de retrouver les contenus les plus proches sémantiquement.
La particularité d’EmbeddingGemma 2 est de réunir ces différentes modalités dans un seul modèle.
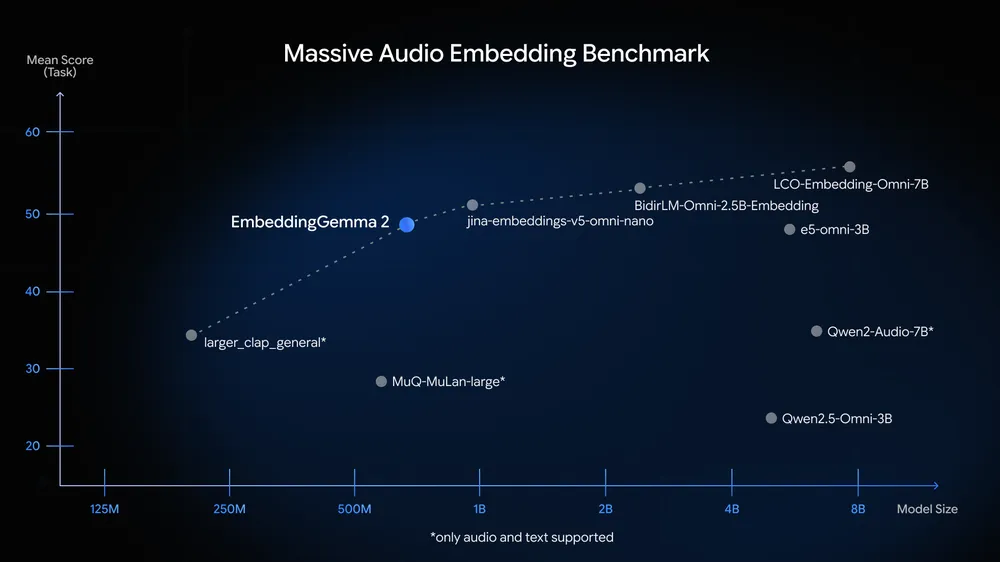
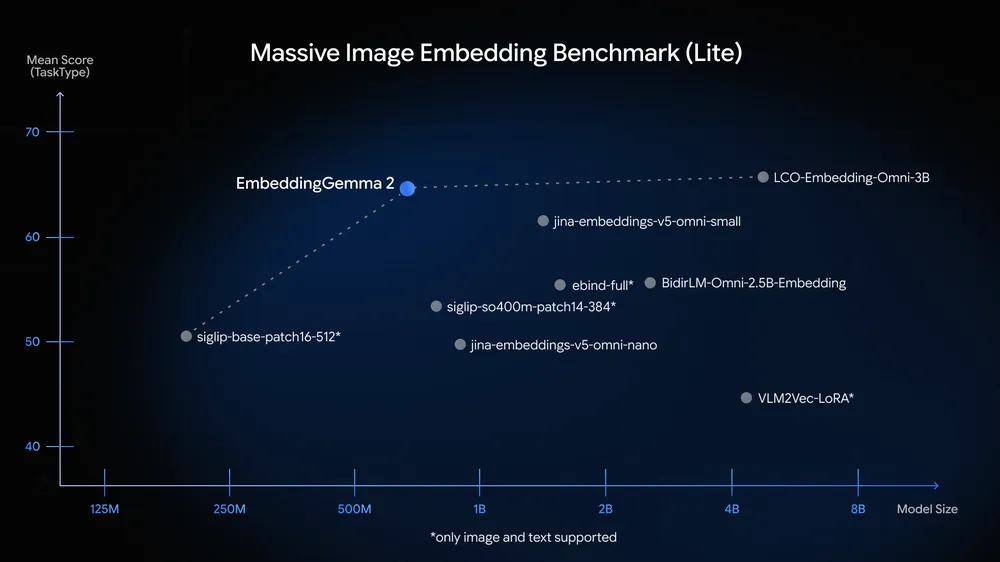
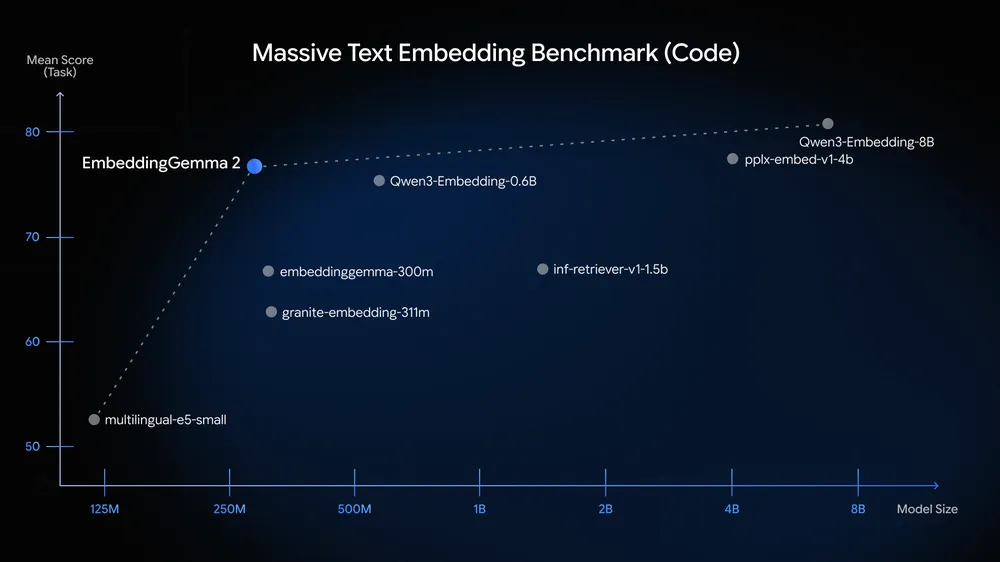
740 millions de paramètres, mais une architecture modulable
Google annonce 740 millions de paramètres, avec une architecture pensée pour éviter de charger systématiquement l’intégralité du modèle. La partie dédiée au texte représente environ 270 millions de paramètres. Un encodeur visuel de 170 millions de paramètres et un encodeur audio de 300 millions peuvent ensuite être chargés lorsque les applications en ont besoin.
Cette modularité explique en partie pourquoi le modèle peut fonctionner sur des appareils aux ressources limitées. Pour une utilisation uniquement textuelle, la mémoire nécessaire reste particulièrement réduite.
Google indique également que le modèle peut traiter jusqu’à 8 192 tokens, toutes modalités confondues. C’est quatre fois plus que la première version d’EmbeddingGemma, avec une capacité annoncée correspondant notamment à environ 29 images, 58 images vidéo ou cinq minutes et demie d’audio.
Une IA qui ne nécessite pas le cloud
L’intérêt le plus concret d’EmbeddingGemma 2 est probablement son fonctionnement entièrement sur l’appareil. Une application peut ainsi construire un système de recherche sémantique sans transmettre les contenus à un serveur distant. Pour des documents personnels, des conversations ou des données sensibles, cette approche permet de conserver l’information sur le smartphone ou l’ordinateur utilisé.
Google avait déjà défendu cette approche avec un traducteur fonctionnant hors ligne sur un Raspberry PiLe Raspberry Pi est un ordinateur monocarte britannique, né en 2012 pour rendre la programmation accessible à tous : aujourd'hui de 4 à 305 dollars selon le modèle, il sert aussi bien à apprendre le code qu'à faire tourner un serveur personnel, une borne industrielle ou, depuis peu, de petits modèles d'IA entièrement hors ligne. Lire la fiche. L’entreprise cherche désormais à rendre ce type de traitement suffisamment léger pour fonctionner directement sur des appareils grand public.
Pour les entreprises européennes, cette approche est également intéressante dans le contexte de la protection des données : les informations n’ont pas besoin de quitter l’appareil pour être indexées ou recherchées.
Des vecteurs beaucoup moins lourds à stocker
Google propose également de réduire la taille des représentations générées par le modèle. Les vecteurs peuvent passer de 768 à seulement 128 dimensions, ce qui permettrait selon l’entreprise de réduire jusqu’à six fois l’espace de stockage nécessaire. Cette possibilité est particulièrement pertinente pour les applications qui doivent indexer de grandes quantités de contenus localement. Une bibliothèque de documents, de photos ou de fichiers multimédias peut ainsi être représentée par des vecteurs relativement compacts.
Le résultat est une architecture de recherche qui peut fonctionner sans connexion réseau : le contenu est analysé localement, transformé en vecteurs, puis retrouvé par similarité sémantique.
EmbeddingGemma 2 s’inscrit dans la stratégie Gemma
Google ne lance pas ce modèle seul. EmbeddingGemma 2 reprend l’architecture de la famille Gemma et partage notamment son tokenizer texte et son encodeur audio avec Gemma 4.
Google affirme que la famille Gemma a désormais dépassé un milliard de téléchargements, dont environ 20 millions pour le premier EmbeddingGemma. Cette adoption donne à Google un écosystème important autour de modèles ouverts pouvant fonctionner sur du matériel grand public.
EmbeddingGemma 2 est distribué sous licence Apache 2.0, ce qui permet son utilisation et son intégration dans de nombreux projets.
Un modèle ouvert, mais pas sans limites
Google précise néanmoins plusieurs limites importantes. EmbeddingGemma 2 n’a pas bénéficié d’un entraînement spécifique à la sécurité ni d’une modération des sorties. Les mesures d’atténuation ont été appliquées au niveau des données d’entraînement.
Le modèle prend par ailleurs en charge plus de 100 langues, mais Google avertit que ses performances ne sont pas nécessairement équivalentes dans toutes ces langues.
Ce point mérite une attention particulière en Europe, où l’Union européenne compte 24 langues officielles. La prise en charge annoncée de plus d’une centaine de langues est prometteuse, mais elle ne signifie donc pas que la qualité sera homogène entre toutes.
Google veut faire du local le nouveau standard
Avec EmbeddingGemma 2, Google ne cherche pas seulement à proposer un modèle plus petit. L’entreprise défend une vision dans laquelle certaines briques essentielles de l’IA peuvent fonctionner directement sur le matériel que possède déjà l’utilisateur.
Le modèle peut transformer différents types de données, les indexer et permettre leur recherche sémantique sans connexion à un serveur. Cette combinaison est particulièrement intéressante pour les assistants locaux, les moteurs de recherche personnels, les applications multimédias et les outils travaillant sur des données confidentielles.
Le paradoxe est finalement assez révélateur : l’une des technologies les plus intéressantes pour la souveraineté numérique européenne vient actuellement d’un groupe américain. Google fournit le modèle, la licence ouverte et l’architecture capable de fonctionner localement, mais son adoption dépendra ensuite des développeurs et des fabricants qui décideront de l’intégrer.