
Google dévoile LiteRT Tensor API, une nouvelle couche C++ destinée au développement de modèles d’intelligence artificielle exécutés directement sur les appareils. Présentée le 19 octobre 2026, cette interface permet de construire manuellement le graphe de calcul d’un réseau neuronal, opération par opération, sans devoir nécessairement convertir un modèle préalablement entraîné avec un autre framework.
Cette approche ne remplace toutefois pas la méthode traditionnelle. Google continue de recommander la conversion de modèles existants pour la majorité des projets, une voie généralement plus rapide et plus fiable pour passer en production. La Tensor API s’adresse surtout aux développeurs qui veulent contrôler finement l’architecture de leurs réseaux, expérimenter de nouvelles opérations ou optimiser leur exécution sur différents processeurs.
Construire un modèle directement en C++
La plupart des projets d’IA reposent sur des modèles entraînés dans des frameworks comme PyTorch, puis convertis dans un format adapté à leur environnement d’exécution. Google propose notamment LiteRT Torch pour faciliter ce processus. Pour les équipes qui souhaitent développer un modèle inédit ou modifier profondément son architecture, cette conversion peut cependant devenir une étape contraignante.
LiteRT Tensor API offre une autre possibilité : écrire le graphe de calcul directement en C++. Les développeurs peuvent ainsi définir les opérations qui composent le réseau neuronal, organiser ses différentes étapes et travailler sur son optimisation sans dépendre systématiquement des évolutions d’un framework externe.
Google ne présente pas cette méthode comme le choix à privilégier dans tous les cas. Dans son annonce, l’entreprise souligne que la conversion d’un modèle entraîné reste la solution recommandée pour la plupart des projets. La création native avec Tensor API vise plutôt les besoins spécifiques, lorsque le contrôle du calcul et de son implémentation devient une priorité.
Un même graphe pour plusieurs plateformes matérielles
L’un des principaux intérêts de la Tensor API réside dans sa capacité à dissocier la définition du modèle du matériel sur lequel il s’exécute. Selon Google, un même graphe peut être utilisé avec différents moteurs d’exécution compatibles avec LiteRT, notamment le CPU, le GPU et les unités de traitement neuronal, ou NPU.
Le projet prend également en charge XNNPACK pour l’exécution sur CPU et permet d’exporter un modèle au format standard. tflite. Cette flexibilité pourrait limiter le besoin de réécrire intégralement les composants d’inférence lorsque le matériel cible change.
Google oppose cette approche à certaines implémentations C++ conçues spécifiquement pour un environnement matériel, comme celles reposant directement sur Metal, OpenCL ou Vulkan. Ces solutions peuvent nécessiter des adaptations importantes lorsqu’il faut prendre en charge une autre plateforme. Avec Tensor API, l’objectif est de conserver un graphe commun tout en laissant LiteRT gérer les possibilités offertes par les différents moteurs.
Le dépôt du projet répertorie plus de 90 opérations, couvrant notamment les calculs élément par élément, les multiplications de matrices, les convolutions, la normalisation et la quantification. Les poids peuvent aussi être chargés directement depuis certains fichiers de points de contrôle, dont les fichiers. safetensors utilisés dans l’écosystème Hugging Face, sans devoir écrire systématiquement des scripts de conversion intermédiaires.
Moins de transferts de données entre le GPU et le CPU
L’architecture mise en avant par Google vise également à réduire les transferts de données entre les composants. Le prétraitement, les différentes étapes du modèle et le post-traitement peuvent partager des tampons mémoire associés à l’accélérateur, de façon à conserver certaines données intermédiaires sur le GPU plutôt que de les recopier vers le CPU.
Cette organisation peut être importante pour les applications qui enchaînent plusieurs opérations sur une image ou un flux vidéo. Les copies inutiles entre processeur et accélérateur peuvent ajouter de la latence et limiter les performances, même lorsque les opérations de calcul elles-mêmes sont rapides.
La Tensor API pourrait aussi faciliter le travail des agents de programmation reposant sur l’IA. Puisqu’un modèle est décrit en C++, un agent peut générer du code, le comparer à une implémentation de référence et mesurer ses performances sur différents appareils. Google y voit une base adaptée à une démarche d’optimisation automatisée, sans que cela garantisse pour autant qu’un agent produira systématiquement un modèle correct ou plus rapide.
La démonstration SAM 2 : plus de 30 images par seconde
Pour illustrer les possibilités de l’API, Google a développé une application web exécutant entièrement sur l’appareil le modèle de segmentation d’images SAM 2 de Meta, via WebGPU. Des instructions en langage naturel sont prises en charge par Gemma 4 E2B.
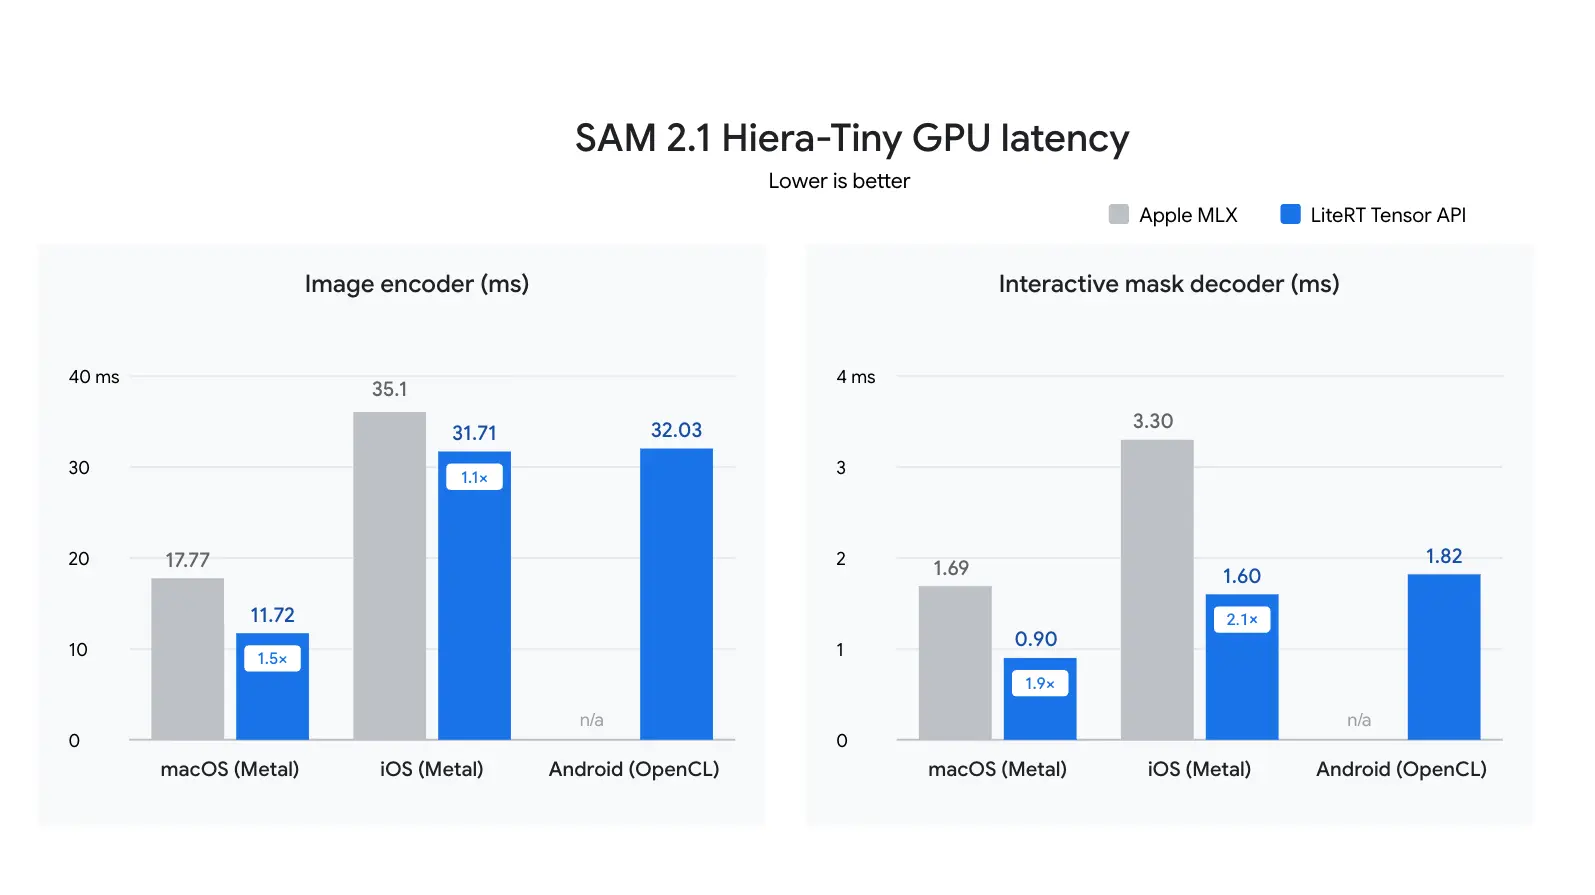
Le modèle SAM 2 a été implémenté en C++ avec Tensor API. Selon Google, un agent de programmation a optimisé le code pour faire passer les performances de moins de 10 à plus de 30 images par seconde en résolution 512 × 512. Les 522 opérations de l’encodeur et les 269 opérations du décodeur sont exécutées sur le GPU, tandis que le prétraitement et le post-traitement ajoutent environ 0,34 milliseconde par image.
Google affirme également que le même code s’est exécuté environ 1,5 fois plus vite sur un MacBook Pro que la version utilisant Apple MLX. Cette comparaison provient des tests de l’entreprise : elle ne constitue pas une évaluation indépendante et ne permet pas de conclure que Tensor API sera systématiquement plus rapide que MLX sur tous les modèles et toutes les machines.
Le code de démonstration est disponible dans le dépôt open source LiteRT Samples. Il permet aux développeurs intéressés d’examiner une implémentation concrète plutôt que de s’appuyer uniquement sur les performances annoncées.
Les prochaines étapes de LiteRT Tensor API
Google prévoit plusieurs évolutions pour étendre les possibilités de son interface. L’entreprise travaille notamment sur des moteurs GPU directs basés sur ML Drift, des opérations mieux adaptées aux NPU et la quantification automatique de l’ensemble du graphe.
D’autres développements sont annoncés, dont la création de modèles en Python avec export au format. tflite, ainsi qu’une prise en charge plus large des dimensions dynamiques. Ces dernières permettraient notamment de mieux gérer les variations de taille des images, de taille des lots ou de longueur des séquences.
LiteRT Tensor API ne cherche donc pas à remplacer tous les outils d’entraînement et de conversion de modèles. Google propose plutôt une voie supplémentaire pour les développeurs qui souhaitent bâtir des réseaux neuronaux directement en C++, contrôler leur représentation et les faire fonctionner sur plusieurs types d’accélérateurs. Si les optimisations annoncées se confirment dans des usages variés, cette approche pourrait faciliter le développement d’applications d’IA locales, où les performances et la maîtrise du matériel sont déterminantes.