
OpenAI affirme avoir franchi un cap dans la modernisation des logiciels historiques. Selon les résultats publiés le 19 octobre, GPT-6.1 Sol atteint 97,9 % de précision sur un test de fidélité comportementale destiné à la migration du COBOL, contre seulement 5,4 % pour son prédécesseur dans les mêmes conditions. Cette progression spectaculaire pourrait faciliter la conversion de certains programmes historiques vers des langages plus modernes.
L’enjeu est considérable. Le COBOL reste présent dans les infrastructures financières et administratives, avec environ 250 milliards de lignes de code encore utilisées en production dans le monde. IBM estime notamment que ce langage intervient dans 95 % des transactions mondiales aux distributeurs automatiques de billets et dans 80 % des transactions de paiement par carte en face à face.
Mais, ces résultats ne signifient pas que l’intelligence artificielle peut désormais moderniser seule un système informatique bancaire complet. Les tests évaluent la capacité à reproduire le comportement d’un programme dans un environnement contrôlé, et non toutes les dépendances techniques, les règles métier accumulées au fil des décennies ou les contraintes d’exploitation d’un grand système informatique.
Le COBOL, un patrimoine informatique difficile à remplacer
Standardisé pour la première fois en 1960, le COBOL a été conçu pour le traitement des données de gestion. Sa syntaxe proche du langage naturel et ses mécanismes de représentation des données répondent à des besoins historiques toujours présents dans les systèmes de paiement, la banque et les grandes organisations.
Sa difficulté ne tient pas uniquement à son ancienneté. Les programmes COBOL peuvent dépendre de règles de calcul précises, de conversions numériques implicites et de conventions de gestion des données qui doivent être reproduites sans variation. Une différence d’arrondi, même minime, peut devenir significative lorsqu’elle se répète sur des millions de transactions.
C’est précisément ce que cherche à mesurer l’évaluation de fidélité comportementale d’OpenAI. Le code traduit doit réussir les tests appliqués à l’implémentation de référence, y compris ceux qui ciblent les cas limites, les enregistrements manquants et les particularités des calculs numériques du COBOL.
La pression est également humaine. Une étude sur les effectifs citée dans le document source situait à 58 ans l’âge moyen des développeurs COBOL en 2019, tandis qu’une enquête commandée par Deloitte à Forrester indiquait que 71 % des équipes mainframe étaient en sous-effectif. La perte progressive des compétences historiques complique la maintenance et augmente l’intérêt des outils d’assistance automatisés.
MultiLangBench : mesurer les capacités de programmation sur 20 langages
OpenAI a également publié les résultats de MultiLangBench, un benchmark conçu pour comparer les capacités de ses modèles dans 20 langages de programmation. La tâche consiste à construire un moteur de base de données compatible avec SQLite, à partir de zéro, dans le langage demandé.
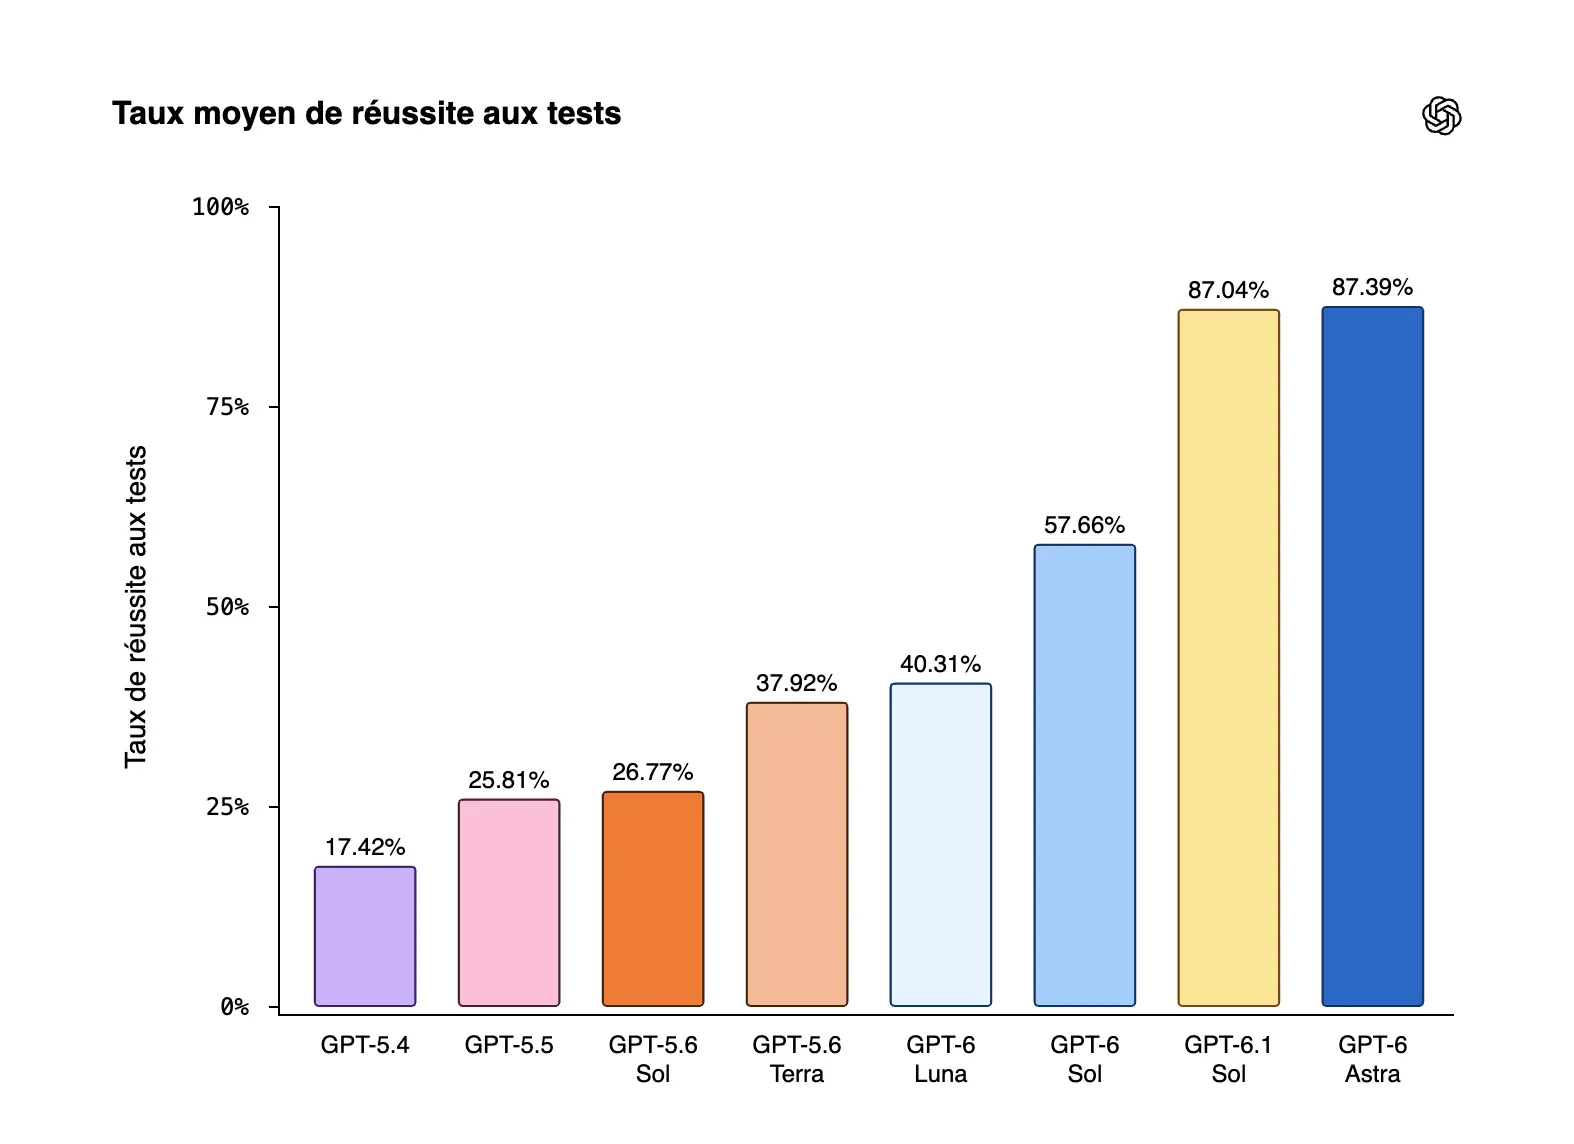
Le modèle doit organiser plusieurs fichiers, gérer l’état du programme, traiter les erreurs et ajouter des fonctionnalités sans casser les tests existants. Les résultats sont évalués en comparant le comportement du programme à celui de l’implémentation de référence de SQLite. Cette méthode permet d’utiliser un principe de test commun, adapté aux différents langages.
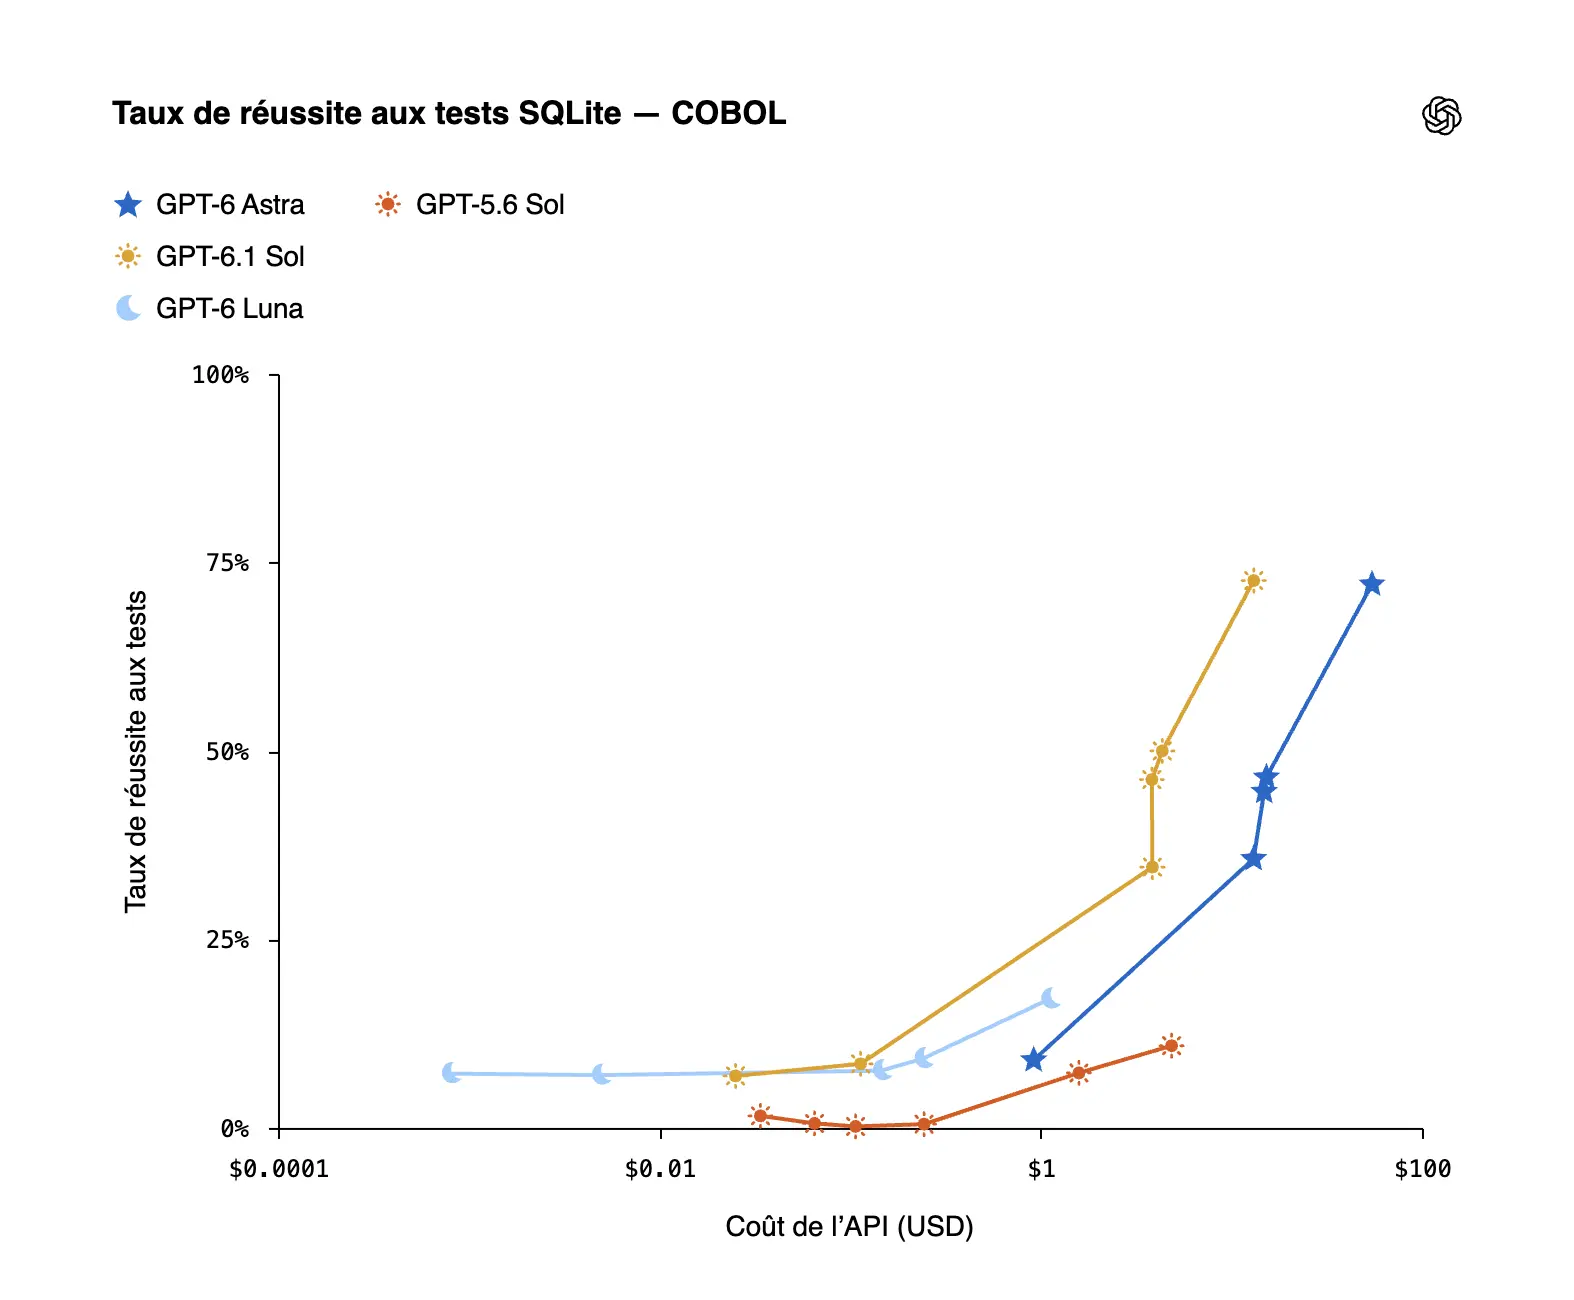
Selon les résultats publiés, GPT-6 Astra dépasse 83 % de précision dans 19 des 20 langages évalués, au niveau de raisonnement maximal. Le COBOL reste le cas le plus difficile, mais sa performance progresse de 10,9 % à 72,1 %. OCaml passe de 25,6 % à 85,8 %, Fortran de 21,4 % à 83,5 % et Visual Basic de 27,5 % à 89,4 %.
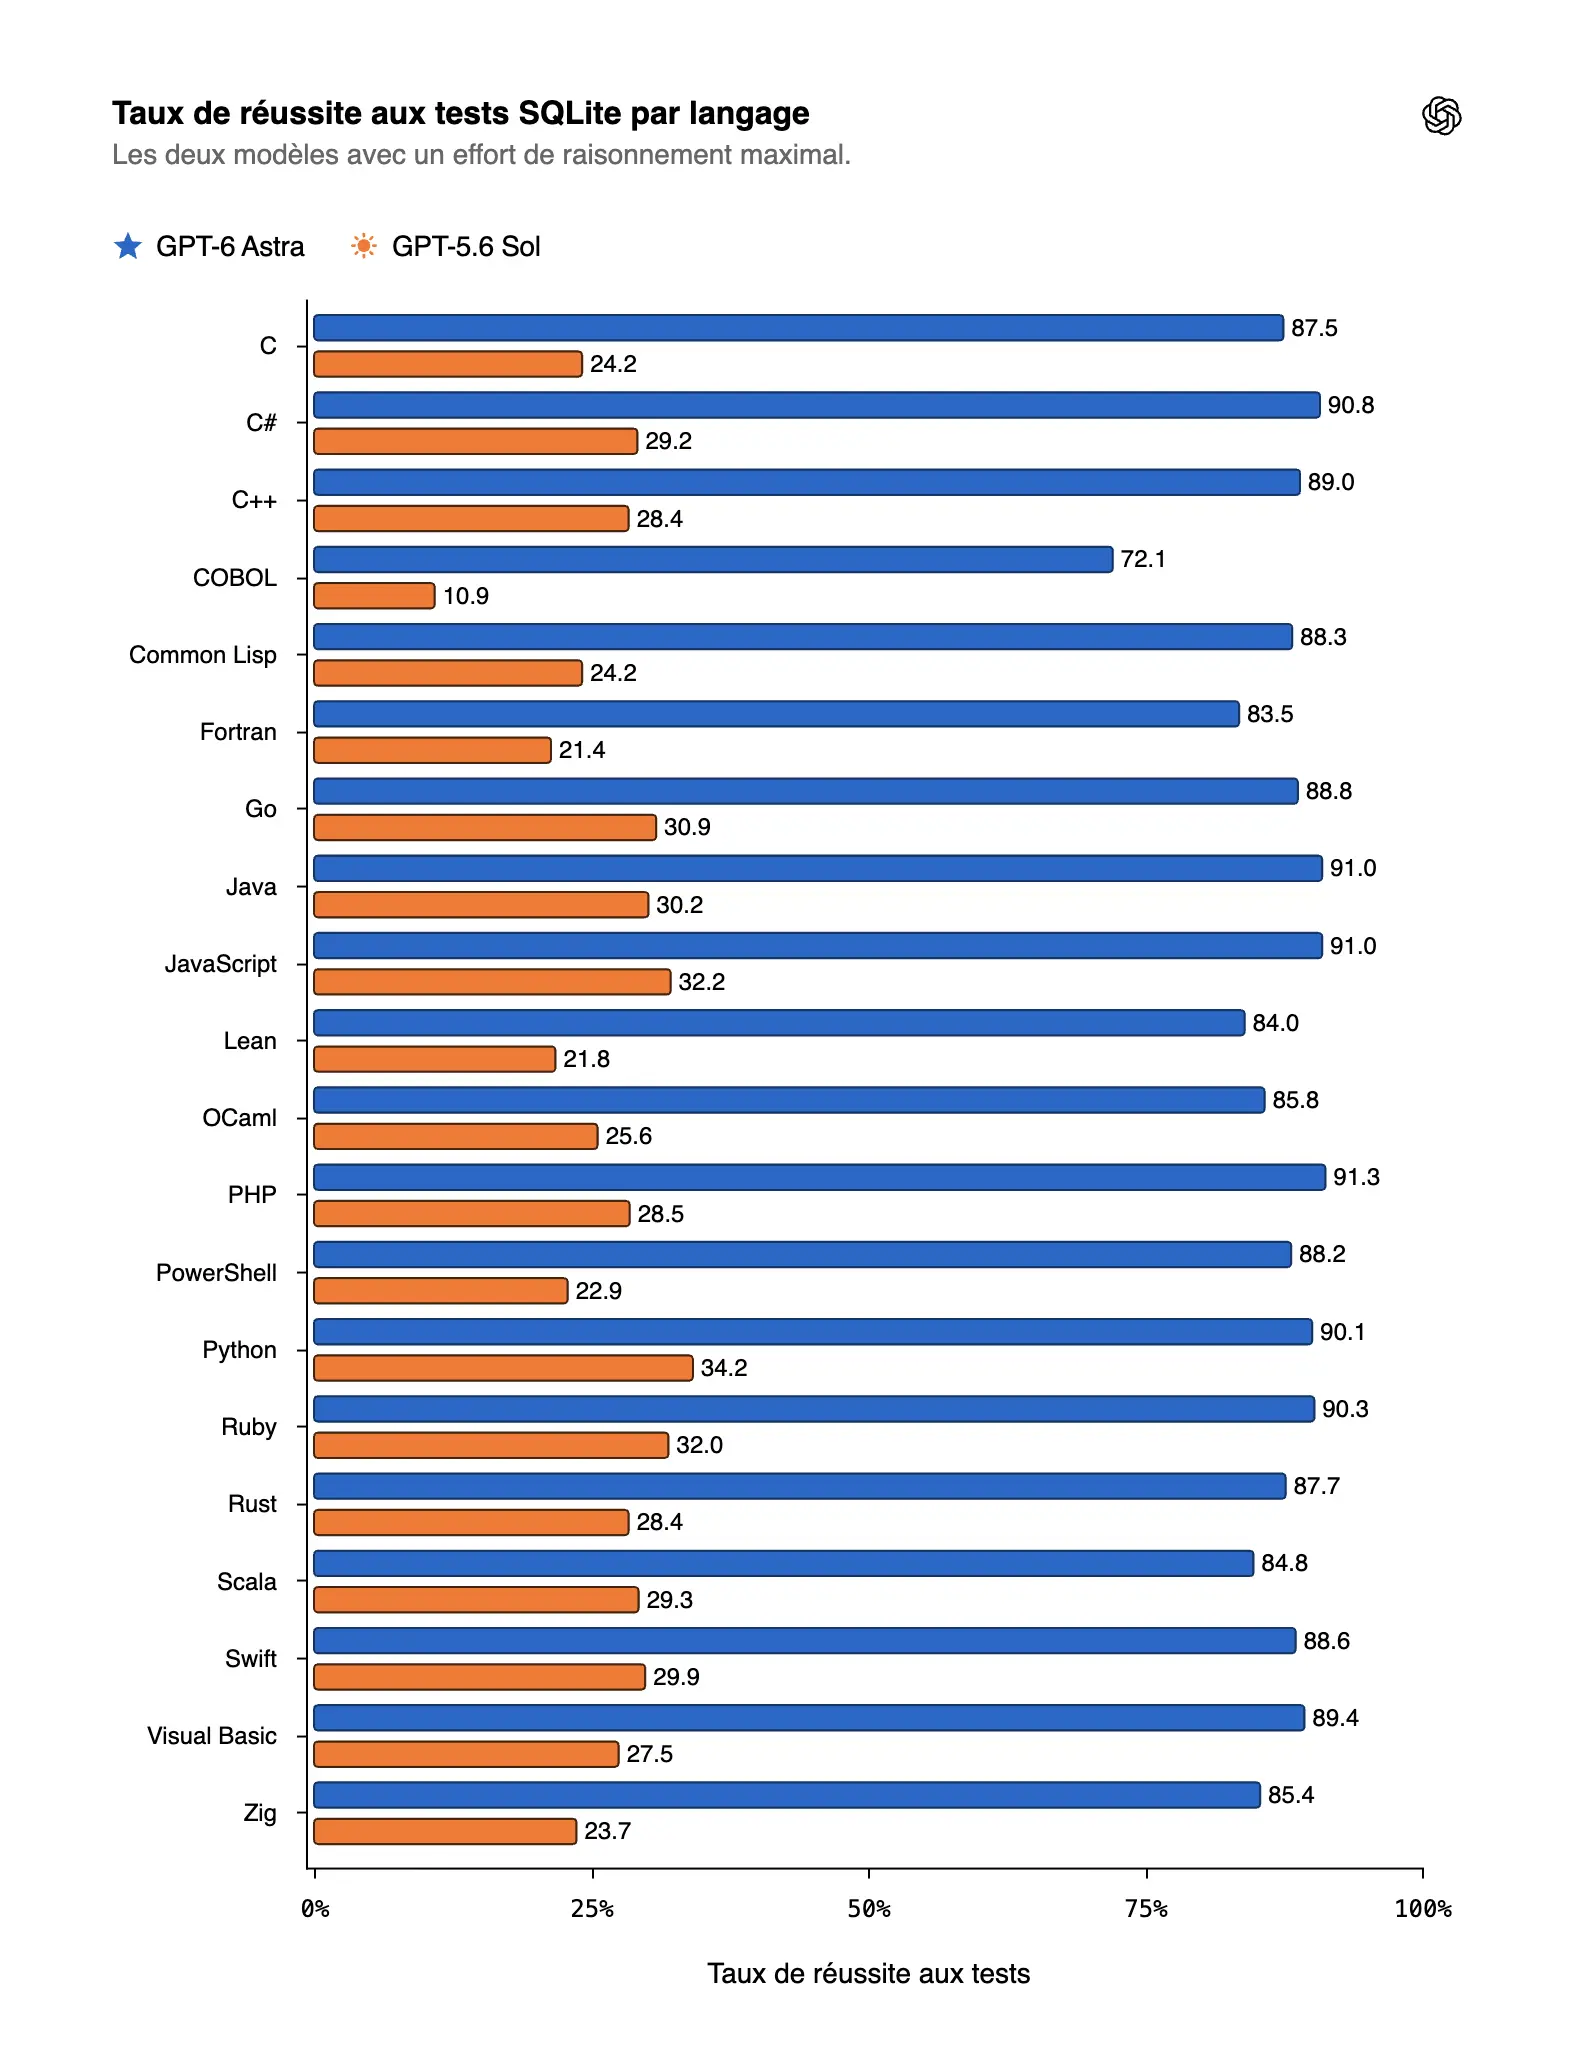
Ces résultats concernent MultiLangBench et ne doivent pas être confondus avec le test distinct de migration COBOL, sur lequel GPT-6.1 Sol atteint 97,9 %.
OpenAI a aussi évalué GPT-6 Luna, une option présentée comme plus accessible en coût. Le modèle atteint une moyenne de 40,3 % et progresse par rapport à GPT-5.6 Sol dans tous les langages testés. Sur le COBOL, son score passe de 10,9 % à 17,1 %, tandis que son coût estimé par échantillon est de 0,77 dollar, contre 3,48 dollars pour GPT-5.6 Sol, soit environ 78 % de moins.
Pour les entreprises qui analysent de grandes quantités de code ou génèrent des tests à grande échelle, cette baisse du coût pourrait compter autant que les gains de précision. Elle ne signifie toutefois pas que le modèle le moins cher conviendra à toutes les tâches : le choix dépendra du niveau de fiabilité requis et de la complexité du code.
Une fidélité de 97,9 % sur le test de migration COBOL
Le benchmark consacré à la migration COBOL impose une exigence différente de MultiLangBench. Le programme réécrit doit reproduire le comportement du code de référence, avec les mêmes tests cachés, dans des langages cibles comme C++, Java, Kotlin, Python ou Rust.
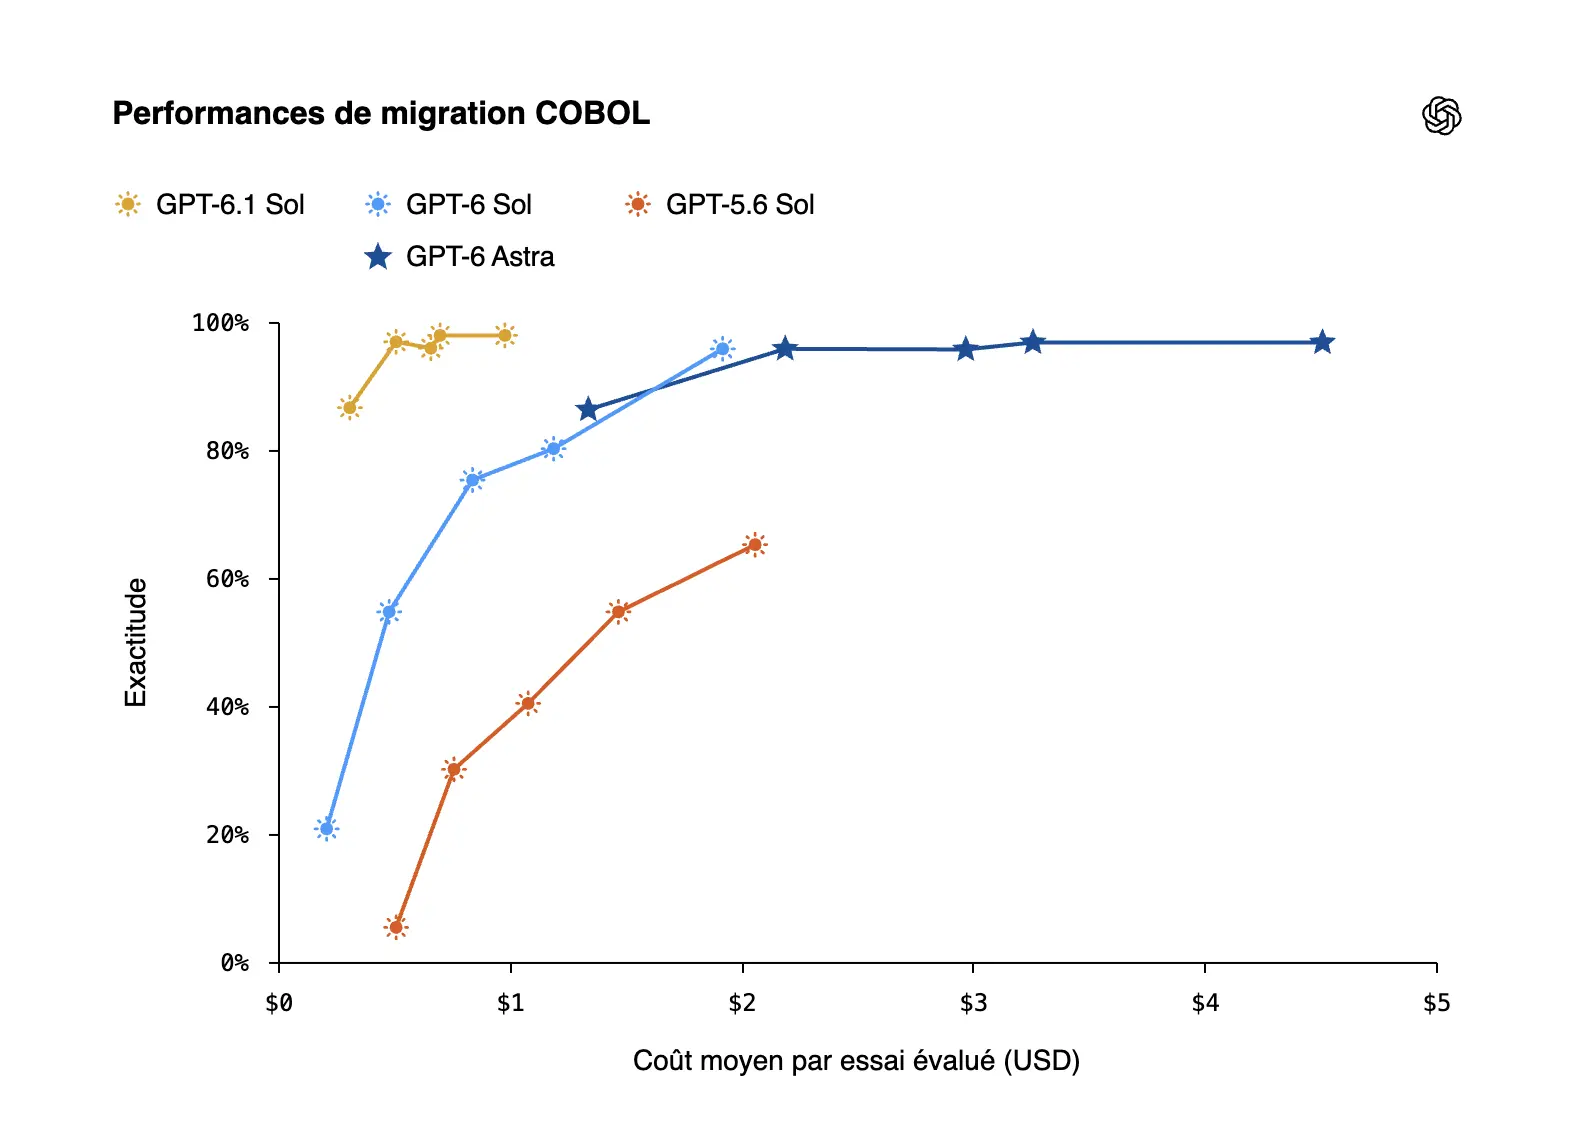
Dans cette évaluation, GPT-6.1 Sol atteint 86,6 % de précision au niveau de raisonnement faible, contre 5,4 % pour GPT-5.6 Sol dans les mêmes conditions. OpenAI indique également que GPT-6.1 Sol coûte 39 % de moins par appel d’API dans cette comparaison.
Au niveau de raisonnement maximal, le modèle atteint 97,9 %, un résultat qu’OpenAI décrit comme proche de la saturation du benchmark. Le progrès est majeur sur la tâche mesurée : l’IA se montre beaucoup plus capable de traduire un programme COBOL tout en conservant son comportement observable.
La méthode exacte à l’origine de cette amélioration n’est cependant pas entièrement détaillée dans l’annonce. Des travaux antérieurs sur l’apprentissage par transfert entre langages montrent que l’utilisation de données issues de langages plus répandus peut aider les modèles à progresser dans des langages moins représentés. Mais les différences syntaxiques et sémantiques du COBOL rendent ce transfert particulièrement difficile.
Ce que le benchmark ne mesure pas
Le score de 97,9 % ne doit pas être interprété comme un taux de réussite garanti pour la migration d’un système mainframe complet. Le test porte sur des programmes isolés et ne couvre pas plusieurs éléments essentiels des environnements d’entreprise.
Les copybooks, par exemple, définissent des structures de données partagées entre de nombreux programmes. Modifier l’une de ces définitions peut avoir des conséquences sur des dizaines, voire des centaines de composants. La gestion des traitements dépend également du JCL (Job Control Language), qui organise les travaux, les fichiers, les jeux de données et l’enchaînement des programmes sur les mainframes IBM.
À cela s’ajoutent les environnements transactionnels comme CICS, dont les mécanismes doivent être préservés lors d’une migration. Enfin, une partie importante des règles métier peut être enfouie dans du code ancien, parfois peu documenté et maintenu pendant des décennies par des équipes qui ne sont plus disponibles.
Des évaluations indépendantes ont déjà mis en évidence des erreurs silencieuses dans les tâches COBOL : un programme peut compiler et réussir une grande partie des tests tout en calculant incorrectement certaines valeurs, par exemple des retenues sur une paie. Le problème ne se limite donc pas à produire du code syntaxiquement valide, mais à démontrer qu’il reste fiable dans toutes les situations importantes.
OpenAI reconnaît que la supervision d’experts reste indispensable pour les migrations en production. Les équipes doivent examiner les règles métier, cartographier les dépendances, construire des tests adaptés et vérifier l’équivalence du système à une échelle bien plus large que celle d’un benchmark.
OpenAI face à IBM, AWS et aux spécialistes du code
Le marché de la modernisation des systèmes historiques compte déjà plusieurs acteurs établis. IBM propose watsonx Code Assistant for Z, une solution pensée pour la migration du COBOL vers Java et intégrée à l’environnement mainframe. Cette proximité avec les métadonnées de traitement, les bibliothèques de copybooks et les définitions de données lui donne accès à un contexte que ne possède pas nécessairement un modèle travaillant sur des fichiers isolés.
AWS propose également Transform for mainframe, un service de modernisation reposant sur l’IA et destiné à accompagner les migrations de bout en bout. GitHub Copilot peut aider à expliquer du code COBOL, à générer des tests et à suggérer des refactorisations. Anthropic a, de son côté, souligné l’intérêt de l’IA pour réduire le coût des phases d’analyse et de découverte, souvent particulièrement longues dans les projets de modernisation.
Cognition, l’entreprise derrière Devin, a aussi publié un retour d’expérience sur des travaux de modernisation COBOL, notamment chez Itaú Unibanco. Elle rapporte des gains de vitesse de cinq à six fois sur certains travaux de refactorisation, tout en précisant que la migration autonome de systèmes transactionnels reste hors de portée des agents actuels.
Dans ce contexte, la publication ouverte de MultiLangBench par OpenAI pourrait favoriser des comparaisons plus transparentes entre les modèles et les fournisseurs. Un benchmark partagé n’efface toutefois pas les différences entre les solutions : l’intégration au système d’information, l’accès aux dépendances et les outils de validation restent déterminants.
La migration assistée par l’IA devient plus crédible, pas automatique
Les résultats d’OpenAI modifient l’évaluation des possibilités de migration assistée par l’IA. Pour des programmes simples, bien isolés et correctement spécifiés, la fidélité obtenue par GPT-6.1 Sol peut justifier des expérimentations sérieuses dans des chaînes de modernisation.
Pour les grandes infrastructures bancaires ou administratives, le principal obstacle reste souvent l’architecture et l’organisation. Il faut comprendre le fonctionnement réel du système, documenter les règles métier, identifier les dépendances et mettre en place des validations capables de détecter les écarts subtils.
La fenêtre d’opportunité est aussi liée au renouvellement des équipes. À mesure que les spécialistes du COBOL quittent le marché du travail, la capacité à exploiter le code existant et à transmettre sa logique devient plus urgente. Les progrès des modèles peuvent aider, mais ils ne remplacent pas la connaissance institutionnelle nécessaire pour garantir la continuité des opérations.
Pour OpenAI, cette avancée met en avant un débouché important de l’IA appliquée au développement logiciel : non seulement accélérer la création de nouvelles applications, mais aussi aider les entreprises à maintenir et à moderniser les infrastructures historiques dont elles dépendent encore. Le cap technique semble avoir été franchi sur le benchmark ; le défi industriel, lui, reste entier.