
Google accélère dans la génération vocale avec Gemini 3.8 Flash TTS et Gemini 3.8 Flash-Lite TTS, deux nouveaux modèles de la famille Gemini 3.8 capables de transformer du texte en voix naturelle, de créer un personnage vocal à partir d’une simple description et, pour le plus avancé, de reproduire une voix à partir de seulement 30 secondes d’enregistrement.
Les deux modèles commencent leur déploiement dans Gemini API et Google AI Studio et rejoignent la famille Gemini 3.8 lancée plus tôt en septembre. Avec Flash TTS, Google cible principalement les podcasts, livres audio et jeux vidéo. Flash-Lite TTS privilégie de son côté les coûts et le volume, avec des usages comme le doublage ou les agents vocaux.
Google entre ainsi encore plus directement sur le terrain de spécialistes comme ElevenLabs et Murf AI.
Gemini peut inventer une voix à partir d’un prompt
L’une des principales nouveautés de Gemini 3.8 Flash TTS est la possibilité de concevoir une voix entièrement à partir d’une description en langage naturel. Plutôt que de sélectionner quelques paramètres prédéfinis, comme l’âge, le genre ou le ton, l’utilisateur peut décrire le personnage qu’il souhaite obtenir.
Google donne, par exemple, celui d’un DJ australien très énergique originaire de Melbourne, ou encore celui d’un dragon japonais. Le modèle interprète ensuite cette description pour générer une identité vocale correspondante.
Cette fonction est disponible dans plus de 100 langues et dialectes, ce qui devrait permettre de concevoir des personnages adaptés à des productions internationales.
Plus de 2 000 voix déjà disponibles
Il n’est pas obligatoire de créer sa propre voix. Google propose également une bibliothèque de plus de 2 000 voix prêtes à l’emploi. Elle comprend notamment différentes variantes régionales et linguistiques, comme l’espagnol mexicain, le français québécois ou l’anglais écossais. Une voix personnalisée peut également être sauvegardée afin d’être réutilisée dans plusieurs projets.
Cette fonction est particulièrement importante pour les productions régulières. Un podcast, un jeu ou une série audio peut ainsi conserver la même identité vocale d’un épisode à l’autre sans devoir recréer précisément le personnage à chaque génération.
Google prépare également une fonction de remix vocal qui permettra de modifier différents attributs d’une voix existante, notamment son timbre, sa hauteur, son rythme ou son accent. Cette fonction arrivera ultérieurement.
Contrôler la manière dont chaque phrase est prononcée
Gemini 3.8 Flash TTS ne se limite pas au choix de la voix. Google permet également de contrôler précisément son interprétation. Le script peut intégrer des indications de jeu ligne par ligne, à la manière de didascalies. L’utilisateur peut ainsi préciser le ton, l’émotion ou la manière dont certaines phrases doivent être prononcées.
Les scripts peuvent également contenir des éléments, comme des rires, des soupirs ou de petites interjections, telles que « mhm ». L’objectif est de produire un résultat moins uniforme qu’une synthèse vocale traditionnelle.
Deux personnages dans un même script
Les nouveaux modèles prennent également en charge les conversations. Un seul script peut contenir deux intervenants différents, chacun disposant de sa propre voix. Cette capacité vise directement des usages, comme les podcasts conversationnels, dialogues de jeux vidéo, contenus éducatifs ou histoires audio.
Google annonce également la prise en charge de contenus particulièrement longs.
Les modèles peuvent générer plusieurs heures d’audio, ce qui les rend adaptés aux livres audio ou à des productions qui dépassent largement les quelques minutes généralement associées aux assistants vocaux.
Cloner une voix avec 30 secondes d’audio
Gemini 3.8 Flash TTS propose surtout une fonction particulièrement sensible : la réplication d’une voix existante. Google indique que seules 30 secondes d’enregistrement peuvent suffire. À partir de cet extrait, le modèle peut créer une voix synthétique reproduisant les caractéristiques de la personne enregistrée. Cette technologie ouvre des possibilités évidentes pour les créateurs.
Un podcasteur pourrait, par exemple, disposer d’une version synthétique de sa propre voix pour certains passages, traductions ou corrections. Mais, elle soulève également d’importantes questions concernant l’usurpation d’identité et les deepfakes audio.
Google impose donc une étape supplémentaire.
Un consentement vocal obligatoire
Pour créer la réplique d’une voix, l’utilisateur doit fournir un enregistrement verbal de consentement provenant du propriétaire de cette voix. Google indique que son système vérifie que la personne donnant son consentement correspond bien à celle présente dans l’échantillon utilisé pour la réplication.
Le mécanisme vise à empêcher, au moins dans le cadre normal d’utilisation du service, de récupérer quelques secondes d’une interview ou d’une vidéo publique pour reproduire immédiatement la voix d’une autre personne sans son autorisation.
L’efficacité réelle de cette protection dépendra évidemment de la robustesse du système de vérification. Mais la présence d’un mécanisme de consentement intégré dès la création constitue une différence importante pour une technologie aussi facilement détournable.
SynthID pour identifier les voix générées
Google ajoute également une couche de traçabilité. Chaque contenu audio généré par les modèles Gemini Audio contient un filigrane SynthID, selon l’entreprise. SynthID est la technologie développée par Google DeepMind pour intégrer un marquage dans les contenus générés par intelligence artificielle.
Dans le cas particulier des voix répliquées, Google ajoute également des Content Credentials C2PA. L’objectif est de permettre de conserver des informations attestant l’origine synthétique du contenu et son historique de création.
Le couple SynthID et C2PA doit donc rendre les voix générées plus facilement identifiables comme telles, même si aucun système de provenance ne peut à lui seul éliminer les risques de détournement.
Flash TTS pour la qualité, Flash-Lite pour le volume
Google décline sa technologie en deux modèles aux objectifs différents. Gemini 3.8 Flash TTS est destiné aux applications nécessitant davantage de créativité et de contrôle. Google cite notamment les jeux vidéo, podcasts et livres audio. Quant à Gemini 3.8 Flash-Lite TTS, celui-ci est davantage orienté vers les applications où le coût et le volume constituent les principaux critères. Le modèle vise notamment le doublage à grande échelle et les agents vocaux.
Cette segmentation reprend une stratégie désormais courante chez les fournisseurs de modèles : proposer une version plus avancée pour les usages exigeants et une déclinaison plus économique pour les tâches effectuées à très grande échelle.
Google revendique la première place sur plusieurs benchmarks
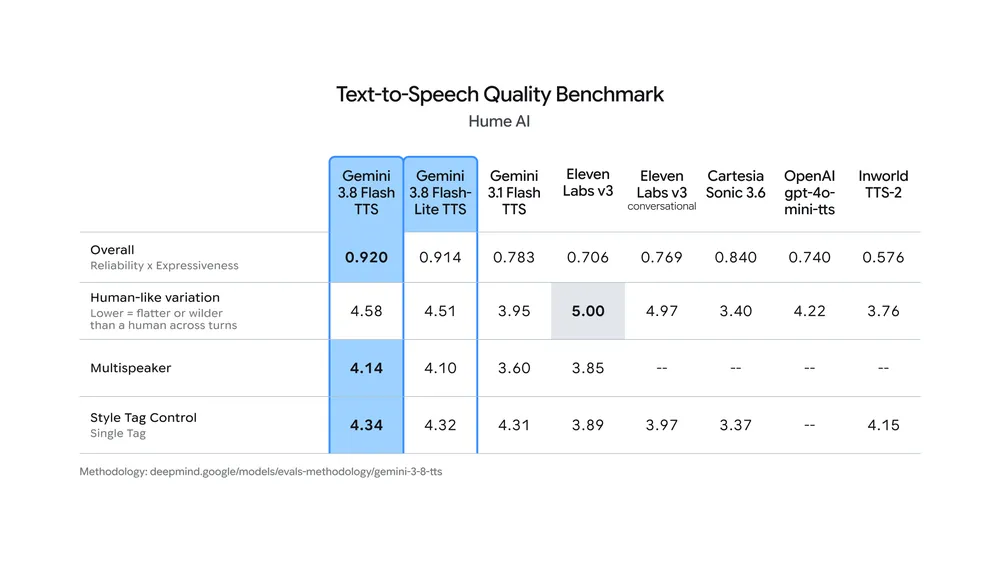
Google accompagne le lancement de plusieurs résultats de benchmarks. L’entreprise affirme que Gemini 3.8 Flash TTS a obtenu un score de 71,4 sur le Voice Design Benchmark de Hume AI, ce qui lui aurait permis d’occuper la première position. Google indique également que Flash TTS et Flash-Lite TTS ont obtenu respectivement les première et deuxième places du Overall Quality Index de Hume AI.
Dans les tests de préférence en aveugle de Voice Arena, les modèles auraient également obtenu d’excellents résultats dans plusieurs langues, notamment en japonais, hindi et espagnol mexicain.
Ces résultats restent à interpréter comme des mesures de benchmarks et ne remplacent évidemment pas des comparaisons dans des conditions réelles, particulièrement pour des usages aussi subjectifs que la qualité ou le naturel d’une voix.
Google attaque directement ElevenLabs
Le positionnement de Gemini 3.8 Flash TTS place Google face à plusieurs acteurs spécialisés. ElevenLabs s’est notamment imposé comme l’une des références de la génération et du clonage de voix, Murf AI développe également ses propres modèles vocaux, tandis qu’Adobe a intégré des fonctions de génération de parole à Firefly.
Toutefois, Google dispose d’un avantage important : son écosystème. Les nouveaux modèles ne resteront pas cantonnés à une API destinée aux développeurs.
Gemini Notebook et Google Vids vont en profiter
Google prévoit d’intégrer progressivement ses nouveaux modèles à ses propres produits. Gemini 3.8 Flash TTS arrivera dans Gemini Notebook, tandis que Flash-Lite TTS sera intégré à Google Vids. L’accès destiné aux entreprises via Gemini Enterprise est également prévu prochainement.
Plusieurs sociétés commencent parallèlement à intégrer les modèles. Google cite notamment Figma, HeyGen, Wondercraft, Linguana, 99.co et Ollang parmi les premiers partenaires. La combinaison de l’API, des outils créatifs de Google et des applications professionnelles pourrait rapidement donner à Gemini Audio une portée considérable.
La voix devient un simple prompt
La nouveauté la plus significative n’est finalement peut-être pas le clonage vocal lui-même. Cette technologie existe déjà chez plusieurs concurrents. L’évolution la plus intéressante est la manière dont Google cherche à transformer la création d’une voix en instruction en langage naturel. Accent, personnalité, rôle, rythme et style peuvent progressivement être décrits comme on décrirait une image à un générateur visuel.
Le son suit ainsi le même chemin que l’image et la vidéo génératives : l’interface technique disparaît progressivement au profit du prompt. Avec plus de 2 000 voix, la création vocale personnalisée, les dialogues, plusieurs heures d’audio et le clonage en 30 secondes, Google ne propose plus simplement une fonction de text-to-speech.
Gemini devient progressivement un studio vocal complet. Et pour ElevenLabs et les autres spécialistes du secteur, l’arrivée de Google sur ce terrain pourrait sérieusement intensifier la concurrence.