
Google présente Gemini 4 Carbon, un nouveau modèle d’intelligence artificielle conçu pour traiter des tâches de programmation complexes et renforcer la cybersécurité.
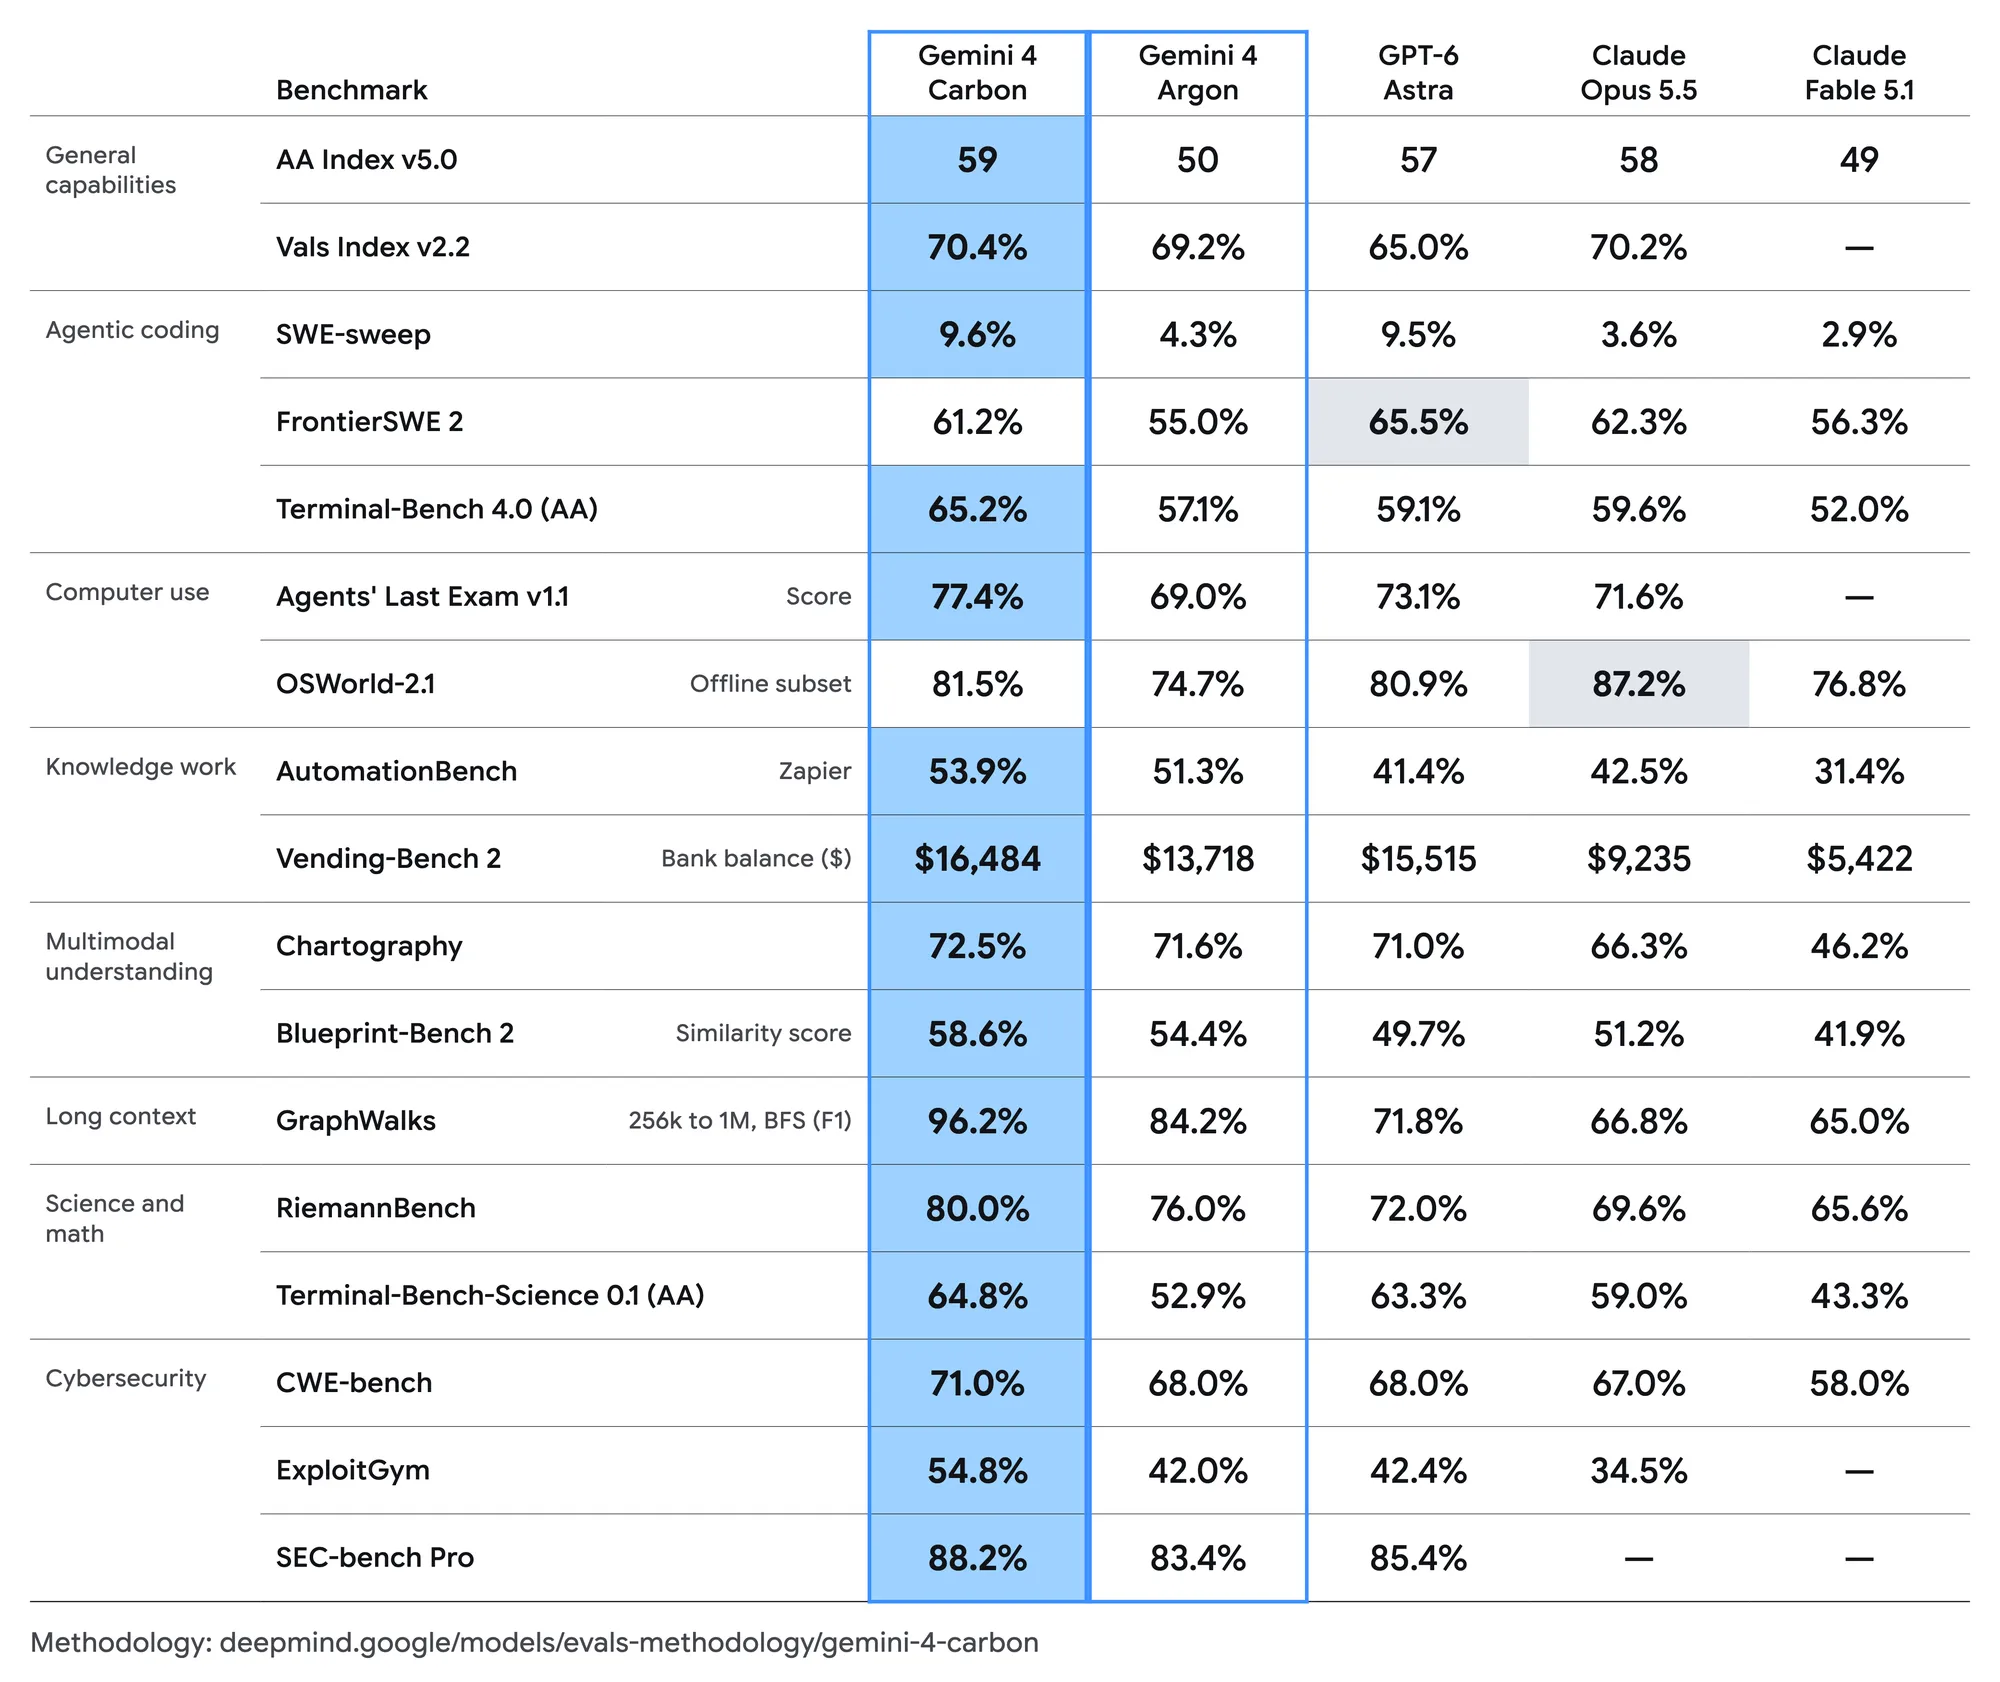
Selon l’entreprise, il peut travailler pendant plusieurs jours sur de grandes bases de code, identifier des bugs difficiles à détecter et élaborer des correctifs. Le modèle se distingue également dans les évaluations de capacités générales, où il prend la tête de l’Intelligence Index d’Artificial Analysis avec un score de 59 points.
Cette performance le place devant Claude Opus 5.5, GPT-6 Astra et son prédécesseur Gemini 4 Argon. Google met toutefois surtout en avant les progrès réalisés dans le développement logiciel, le raisonnement et les tâches impliquant des agents autonomes.
Un modèle pensé pour les projets de développement au long cours
GeminiGemini est la famille de modèles d'IA multimodaux de Google DeepMind, à la fois application grand public et couche d'intelligence intégrée à Search, Android, Gmail et YouTube. Lire la fiche 4 Carbon s’appuie sur Gemini 4 Argon, avec des améliorations annoncées en programmation, en raisonnement et dans l’exécution de workflows complexes. Google affirme que le modèle peut poursuivre un travail sur une base de code importante pendant plusieurs jours, même lorsqu’il rencontre des impasses, jusqu’à parvenir à résoudre certains problèmes.
Cette capacité à maintenir un objectif sur la durée est importante pour les projets logiciels qui ne se résument pas à générer quelques lignes de code. Il faut comprendre une architecture existante, identifier l’origine d’un dysfonctionnement, modifier plusieurs composants et vérifier que le correctif ne provoque pas de nouvelles erreurs.
Sur le classement WebDev Arena, Gemini 4 Carbon aurait gagné 89 points. Il ne domine toutefois pas tous les benchmarks spécialisés en programmation : le modèle reste derrière certains concurrents sur plusieurs évaluations précises. Les résultats suggèrent donc une progression globale, sans garantir une supériorité dans chaque type de développement.
La cybersécurité au cœur des ambitions de Google
La sécurité informatique constitue l’un des principaux axes de Gemini 4 Carbon. Google communique plusieurs résultats sur des benchmarks consacrés à la recherche de vulnérabilités, à l’évaluation de leur exploitabilité et à la correction de failles.
| Évaluation | Score annoncé |
|---|---|
| SEC-bench Pro, détection de vulnérabilités | 88,2 % |
| ExploitGym, évaluation de l’exploitabilité | 54,8 % |
| CWE-bench, correction de vulnérabilités | 71 % |
Ces résultats couvrent différentes étapes du travail de sécurité : repérer une faille potentielle, déterminer si elle peut être exploitée et proposer un correctif. Un modèle capable de contribuer à ces trois tâches pourrait aider les équipes de sécurité à examiner plus rapidement de grandes quantités de code.
Ces capacités restent néanmoins à interpréter dans le contexte des tests utilisés. Les scores sur des benchmarks ne suffisent pas, à eux seuls, à démontrer qu’un modèle détectera toutes les vulnérabilités en production ou qu’il produira systématiquement des correctifs fiables.
Google annonce aussi des progrès en matière de fiabilité
Google affirme avoir travaillé sur plusieurs comportements indésirables observés avec les modèles précédents, notamment les informations inventées, les raccourcis et les actions qui dépassent les instructions données par l’utilisateur.
Dans ses évaluations internes, l’entreprise rapporte plus de deux fois plus de réussite dans la génération de code sécurisé par rapport à Gemini 4 Argon. Elle indique également environ deux fois moins d’affirmations non étayées et près de 80 % d’alertes de désalignement graves en moins dans ses environnements internes de programmation en direct.
Google fait aussi état d’une baisse de 26 % des comportements allant au-delà du périmètre demandé et de 29 % des situations où le modèle ne répond pas suffisamment à la tâche. Enfin, le modèle aurait enregistré un taux de réussite des attaques de 0 % sur le benchmark Gray Swan évalué.
Ces chiffres proviennent des tests rapportés par Google et ne constituent pas une garantie absolue de sécurité. Les résultats peuvent varier selon les environnements, les tâches et les méthodes d’évaluation. Ils devront être confrontés à des évaluations indépendantes et à des usages réels.
Une disponibilité encore limitée
Gemini 4 Carbon n’est pas encore accessible à l’ensemble des utilisateurs. Google le propose pour l’instant à certains spécialistes de la défense en cybersécurité dans le cadre de son programme Fairwind, avec une ouverture plus large prévue ultérieurement.
La tarification initiale de l’API commence à 2 dollars par million de tokens en entrée et à 10 dollars par million de tokens en sortie. Google prévoit ensuite de passer respectivement à 4 et 20 dollars, sans annoncer de date précise pour cette augmentation.
L’accès élargi dépendra notamment de l’évaluation des mécanismes de protection et des performances du modèle en conditions réelles. Cette approche reflète la sensibilité des usages visés : une IA capable d’analyser des vulnérabilités et de tester leur exploitabilité peut aider les défenseurs, mais ses capacités nécessitent aussi un encadrement adapté.
Avec Gemini 4 Carbon, Google cherche à positionner ses modèles sur des tâches où la persévérance, la compréhension de grandes bases de code et la fiabilité sont aussi importantes que la génération de texte. Ses résultats initiaux sont prometteurs selon les évaluations présentées, mais l’accès limité et l’absence de validation indépendante généralisée invitent encore à la prudence.