GPT-6 : le guide d’OpenAI pour choisir et bien utiliser Astra, Sol et Luna
Durée5 à 15 minutes
NiveauDébutant
RequiertL’appareil, le service ou le compte concerné
Étapes9
Yohann Poiron
·
PUBLIÉ
L'ESSENTIEL
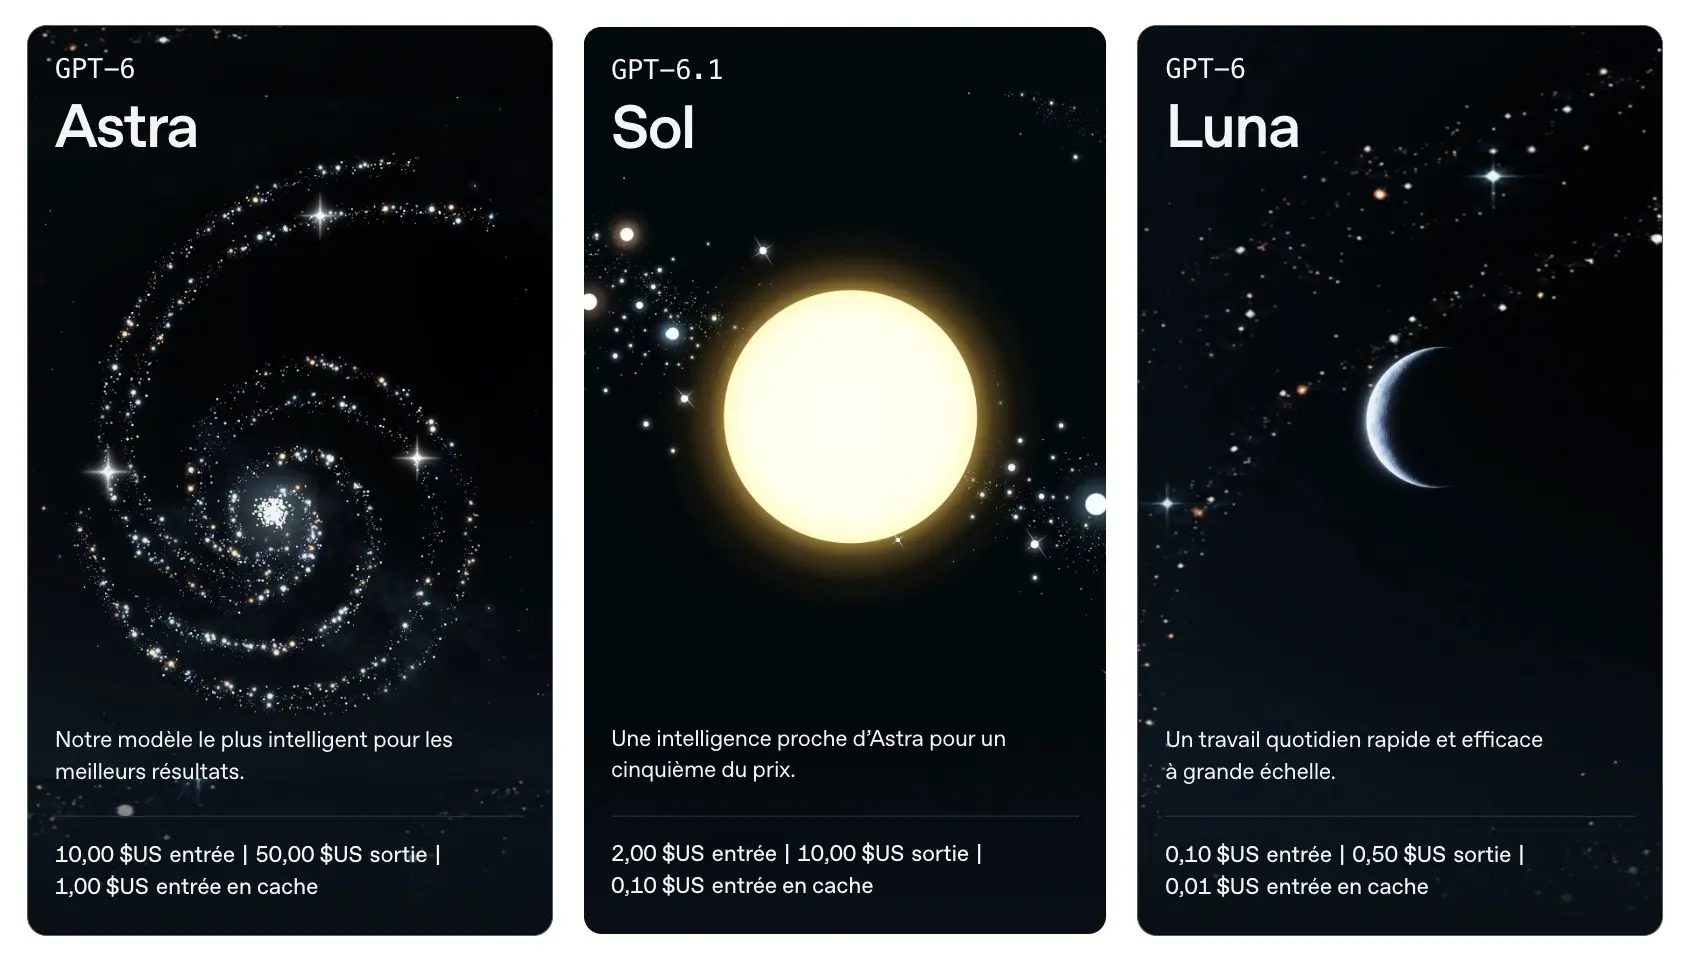
Astra vise le raisonnement le plus difficile (10 $ / 50 $ par million de tokens), Sol offre une intelligence proche pour un cinquième du prix, Luna cible les tâches répétitives à grande échelle (0,10 $ / 0,50 $).
Le cache d'entrée peut réduire jusqu'à 95 % le coût des tokens d'entrée, à condition de placer les instructions stables avant les détails variables.
OpenAI déconseille de sur-spécifier les prompts : une mission claire, des limites de décision et une définition de « terminé » suffisent.
Le 2 octobre 2026, OpenAI a publié un guide pratique destiné aux développeurs pour la famille GPT-6 : comment choisir le bon modèle, rédiger des instructions efficaces, piloter les tâches qui durent plusieurs heures et préparer la mise en production. Voici l’essentiel, réorganisé en neuf étapes.
Choisissez le modèle selon la difficulté de la tâche
OpenAI recommande de voir le choix comme un compromis entre intelligence et prix. GPT-6 Astra est réservé aux tâches de raisonnement les plus difficiles. GPT-6.1 Sol convient aux tâches complexes de programmation, de recherche et d’utilisation de l’ordinateur. GPT-6 Luna vise les tâches ciblées et répétitives à grande échelle : extraire les champs d’une facture, classer des demandes, produire des résumés structurés.
!Astuce. Comparez les tarifs de chaque modèle avant de fixer votre choix : l'écart de prix est de 1 à 100 entre Astra et Luna.
Étape02
Réglez l'effort de raisonnement et la vitesse
Dans l’API, l’effort de raisonnement se règle par niveaux : faible pour des tâches courantes (extraire des faits, petites modifications), moyen pour celles qui demandent du discernement (planifier une fonctionnalité, comparer des options), élevé pour un débogage difficile ou une analyse approfondie. Le niveau « très élevé / max », quand il est disponible, ne se garde que si le gain justifie le temps et le coût.
Côté vitesse, le mode Rapide raccourcit et régularise les temps de réponse à un coût par token supérieur. Le mode Ultrarapide, disponible dans CodexOpenAI Codex est l'agent de programmation d'OpenAI — capable d'écrire, corriger et exécuter du code de façon autonome depuis un terminal, une app de bureau ou l'application ChatGPT, et depuis 2026 de piloter directement un ordinateur comme le ferait un développeur.Lire la fiche et l’API pour GPT-6 Astra, accélère la génération indépendamment de l’effort de raisonnement.
!Astuce. Vous pouvez changer l'effort de raisonnement en cours de conversation dans l'API sans invalider le cache.
Étape03
Réduisez le coût avec le cache et le compactage
Les tokens d’entrée en cache coûtent jusqu’à 95 % de moins que les autres, selon le modèle. Pour en profiter, placez les instructions stables et les références avant les détails variables de la tâche, et gardez des définitions d’outils cohérentes d’un appel à l’autre. Dans les longues conversations, le compactage réduit la taille du contexte tout en conservant l’état nécessaire pour poursuivre.
Supprimez aussi le contexte inutile à la tâche, et lancez les tâches indépendantes en parallèle pour qu’une étape lente ne bloque pas les autres.
!Astuce. Intégrez les écritures en cache et les éventuels tarifs de long contexte dans l'estimation du coût d'un workflow complet.
Étape04
Donnez une mission claire, sans sur-spécifier
Selon Eric Provencher, de l’équipe expérience développeur d’OpenAI, ces modèles comprennent mieux les nuances et les ambiguïtés : des consignes trop précises peuvent désormais nuire aux résultats, alors qu’elles les amélioraient avant. Partez donc d’une mission claire : le résultat souhaité, le public visé, le contexte et les contraintes utiles, et les critères d’achèvement.
!Astuce. Indiquez ce qui constitue une réponse utile : langage clair, détails techniques adaptés au public, bref compte rendu des modifications et des points restant à traiter.
Étape05
Mettez à jour vos compétences et votre fichier AGENTS.md
OpenAI propose quatre ajustements. Pour les compétences : décrivez brièvement quand chacune doit s’exécuter, ne chargez les détails qu’au besoin et remplacez les recettes rigides par des consignes adaptées au modèle. Pour AGENTS.md : expliquez quand certains documents et tests sont pertinents et autorisez les workflows sûrs courants, comme les tests locaux sur des données jetables, sans accès à la production.
Fixez aussi les limites décisionnelles (quelles actions sont autonomes, lesquelles exigent une approbation, plutôt qu’un « toujours demander » général), et précisez jusqu’où persévérer : implémenter, exécuter, examiner le résultat, corriger les échecs.
!Astuce. Définissez ce que « terminé » veut dire et listez les décisions qui exigent votre avis.
Étape06
Gardez le cap sur les tâches longues avec l'API
Les modèles GPT-6 peuvent travailler plusieurs heures, voire plusieurs jours. Trois fonctions aident à les piloter dans l’API. Le pilotage en cours de tour permet d’envoyer une correction via l’API WebSocket Responses pendant l’exécution : elle est mise en file d’attente sans annuler les outils ni les actions déjà réalisées. L’appel asynchrone d’outils laisse le modèle poursuivre des travaux indépendants pendant qu’une tâche lente, comme des tests, s’exécute. La délégation permet à GPT-6.1 Sol de confier des sous-tâches indépendantes à des sous-agents, dans l’API Responses.
!Astuce. La fonctionnalité multi-agent est actuellement en bêta. Attendez le résultat d'un outil asynchrone avant de lancer le travail qui en dépend.
Étape07
Répondez aux questions de Codex et réorientez-le en cours de route
Avec GPT-6 Astra, Codex peut poser des questions pendant qu’il travaille. Tranchez celles qui influencent la suite et précisez quels travaux indépendants peuvent continuer pendant votre réflexion. Si vous vous absentez, indiquez à Codex quelles tâches peuvent continuer et quand il doit s’arrêter pour attendre votre réponse.
Quand les besoins changent, pilotez la tâche en cours en expliquant ce qui doit changer et ce qui doit rester identique, plutôt que de laisser le modèle poursuivre une approche devenue inadaptée.
!Astuce. Commencez par le niveau de raisonnement par défaut du modèle dans Codex, puis ajustez selon la tâche.
Étape08
Utilisez l'ordinateur quand il n'y a pas d'API
GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna peuvent interagir directement avec des sites web et des applications de bureau. Exemple donné par OpenAI : analyser un bug, corriger le code, puis ouvrir le produit dans un navigateur pour vérifier que la correction fonctionne.
La règle : choisir la méthode fiable la plus simple pour chaque étape. Une API ou un outil connecté quand ils suffisent ; l’utilisation de l’ordinateur quand le modèle doit lire un écran, cliquer ou remplir un formulaire.
!Astuce. Pour l'intégrer à votre application, donnez au modèle un outil qui exécute du code : Playwright pour les navigateurs, PyAutoGUI pour les applications de bureau.
Étape09
Préparez la mise en production
Avant le déploiement, exécutez des tâches représentatives et mesurez la réussite, la latence et le coût par tâche réussie. Prévoyez la surveillance du comportement du modèle et passez en revue les contrôles des données de votre application. OpenAI renvoie vers une liste de vérification pour le déploiement de l’API.
!Astuce. Le bon indicateur est le coût par tâche réussie, pas le prix du token : un modèle moins cher qui échoue coûte plus cher au final.
?
Troubleshooting
Ça n'a pas marché ?
01
Que faire si l’option n’apparaît pas ?
Vérifiez que votre application ou votre système est à jour, puis relancez la procédure depuis le début.
Publicité
Ne manquez plus rien
Retrouvez BlogNT en priorité sur Google
Ajoutez-nous à vos sources préférées : nos analyses et tests remontent en tête de votre fil Google Actualités et de la recherche.
To provide the best experiences, we and our partners use technologies like cookies to store and/or access device information. Consenting to these technologies will allow us and our partners to process personal data such as browsing behavior or unique IDs on this site and show (non-) personalized ads. Not consenting or withdrawing consent, may adversely affect certain features and functions.
Click below to consent to the above or make granular choices. Your choices will be applied to this site only. You can change your settings at any time, including withdrawing your consent, by using the toggles on the Cookie Policy, or by clicking on the manage consent button at the bottom of the screen.
Fonctionnel
Toujours activé
L’accès ou le stockage technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’utilisateur, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
L’accès ou le stockage technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou l’internaute.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques.Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
L’accès ou le stockage technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’utilisateur sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.