


OpenAI a présenté Pando, un nouveau backend Git conçu pour tenir la charge d’un dépôt où les agents Codex écrivent l’essentiel du code. Le billet d’ingénierie publié le 2 novembre par l’entreprise (« Le passage à l’échelle de Git chez OpenAI »), explique que le système conserve les clients et le protocole Git habituels, mais change entièrement la manière dont le serveur stocke et distribue branches et packfiles.
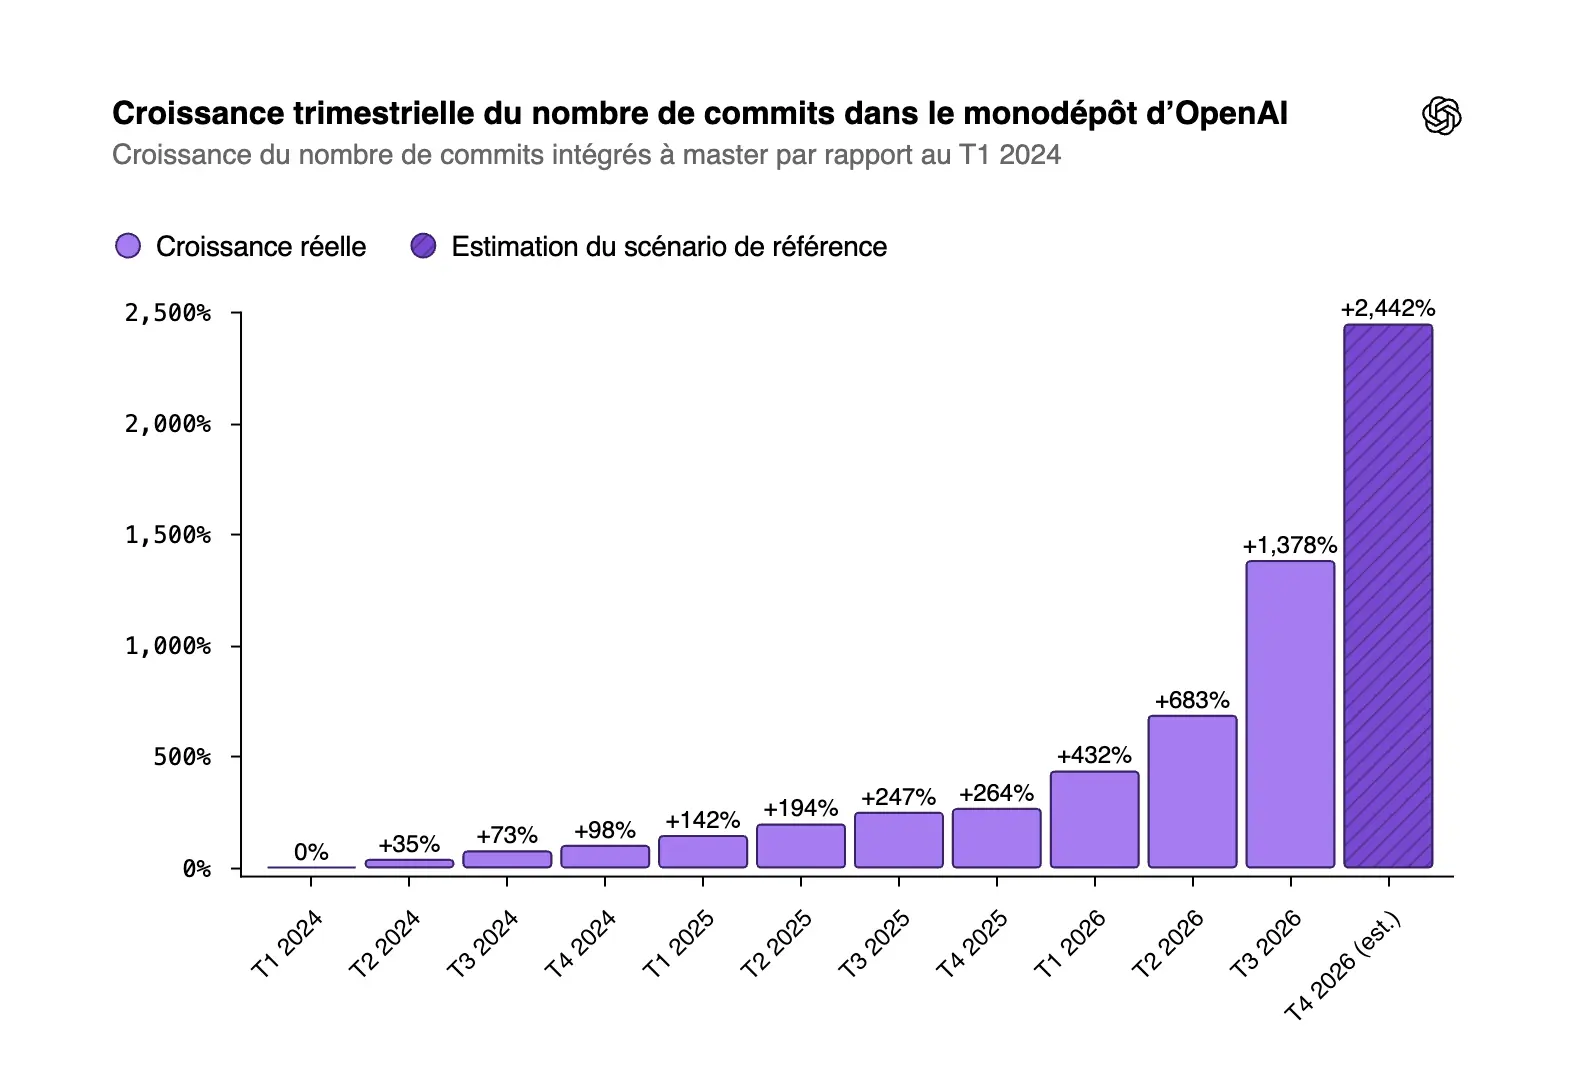
Le contexte chiffré est parlant : selon le graphique du billet, le nombre de commits intégrés à la branche principale a augmenté de 1 378 % entre le premier trimestre 2024 et le troisième trimestre 2026, avec une estimation de 2 442 % pour le quatrième trimestre. Vers la fin de l’année dernière, les systèmes du monodépôt ont commencé à peiner : récupérations et pushes lents, échecs de fusion, fiabilité tombant parfois sous les 90 %.
Tous les chiffres de cet article proviennent d’OpenAI et n’ont pas été vérifiés de façon indépendante. L’entreprise n’a pas publié le code de Pando et dit seulement étudier des moyens de partager la technologie.
Pourquoi Git a fini par coincer chez OpenAI
Le problème décrit n’est pas d’abord la taille du dépôt, mais la concurrence. Codex multiplie les branches, les pushes, les merges et les fetches simultanés, depuis les environnements de développement, les tâches de recherche et l’intégration continue. De nombreux écrivains mettent à jour des branches différentes pendant que de nombreux lecteurs réclament des historiques qui se chevauchent.
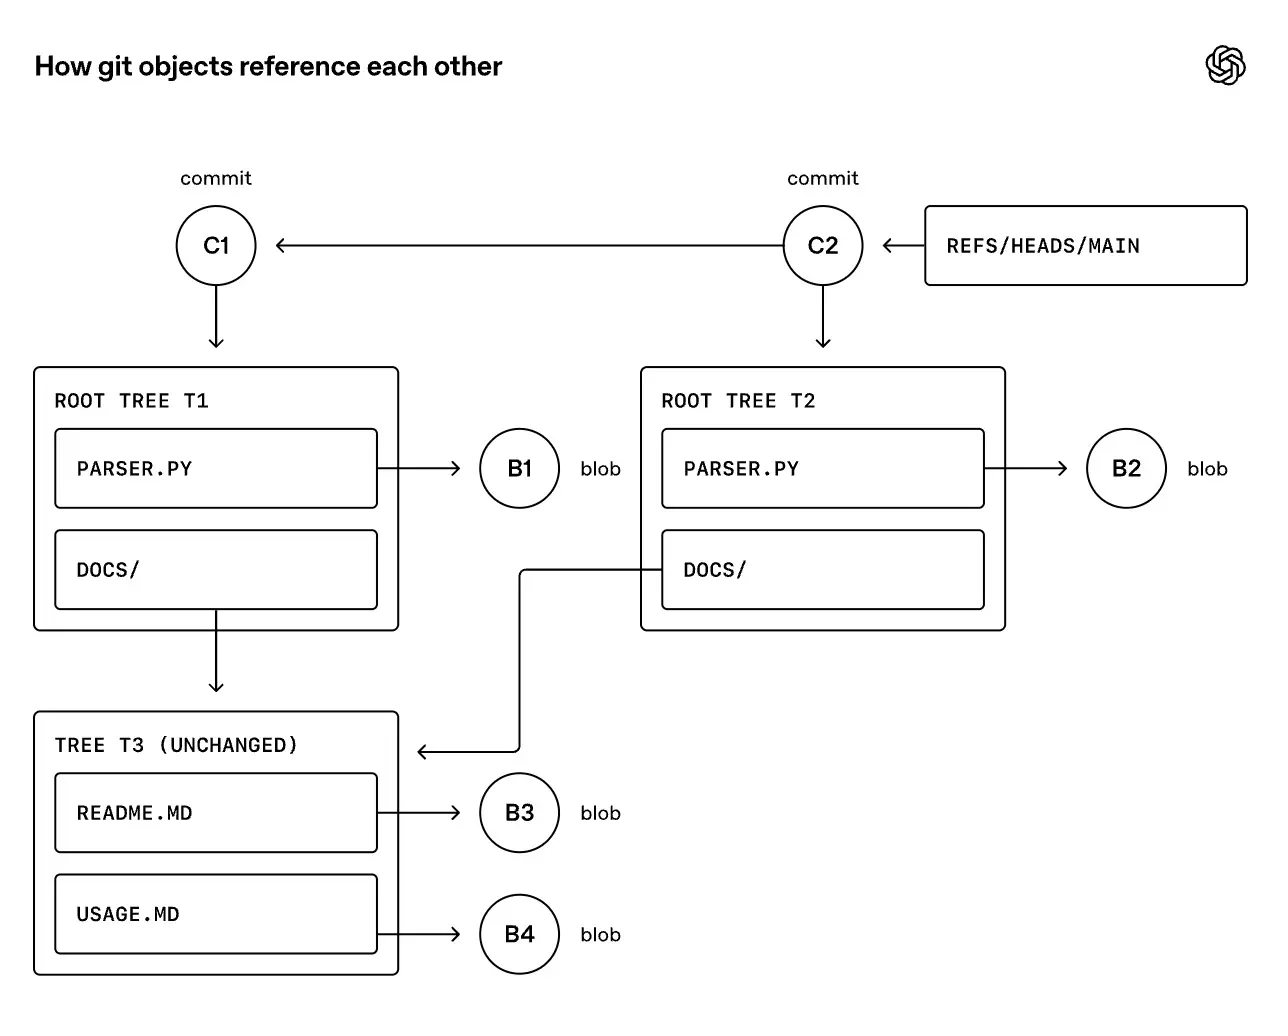
Dans un Git classique, ce schéma devient coûteux : chaque requête de lecture peut déclencher la fabrication d’un packfile sur mesure, et la cohérence à l’échelle du dépôt oblige des écritures sans rapport à s’attendre les unes les autres. OpenAI a comparé deux architectures classiques, la validation en trois phases et le journal d’écriture anticipée, et constate que la première sature les disques à l’écriture, la seconde à la lecture, quand les répliques n’arrivent plus à suivre le journal.
C’est exactement le type de goulot que rencontre aussi Anthropic avec Scion, son système de versioning maison, né du même constat : quand des agents produisent le code, l’architecture pensée pour des développeurs humains montre ses limites.
Comment fonctionne Pando ?
Pando mise sur la cohérence causale plutôt que sur la cohérence globale. Les pushes vers des branches différentes avancent en parallèle ; ceux qui visent une même référence restent sérialisés, grâce à un mécanisme de type compare-and-swap sur un magasin de métadonnées capable de monter en charge horizontalement. Le packfile entrant est envoyé vers un stockage d’objets et validé sans être déballé dans un dépôt local.
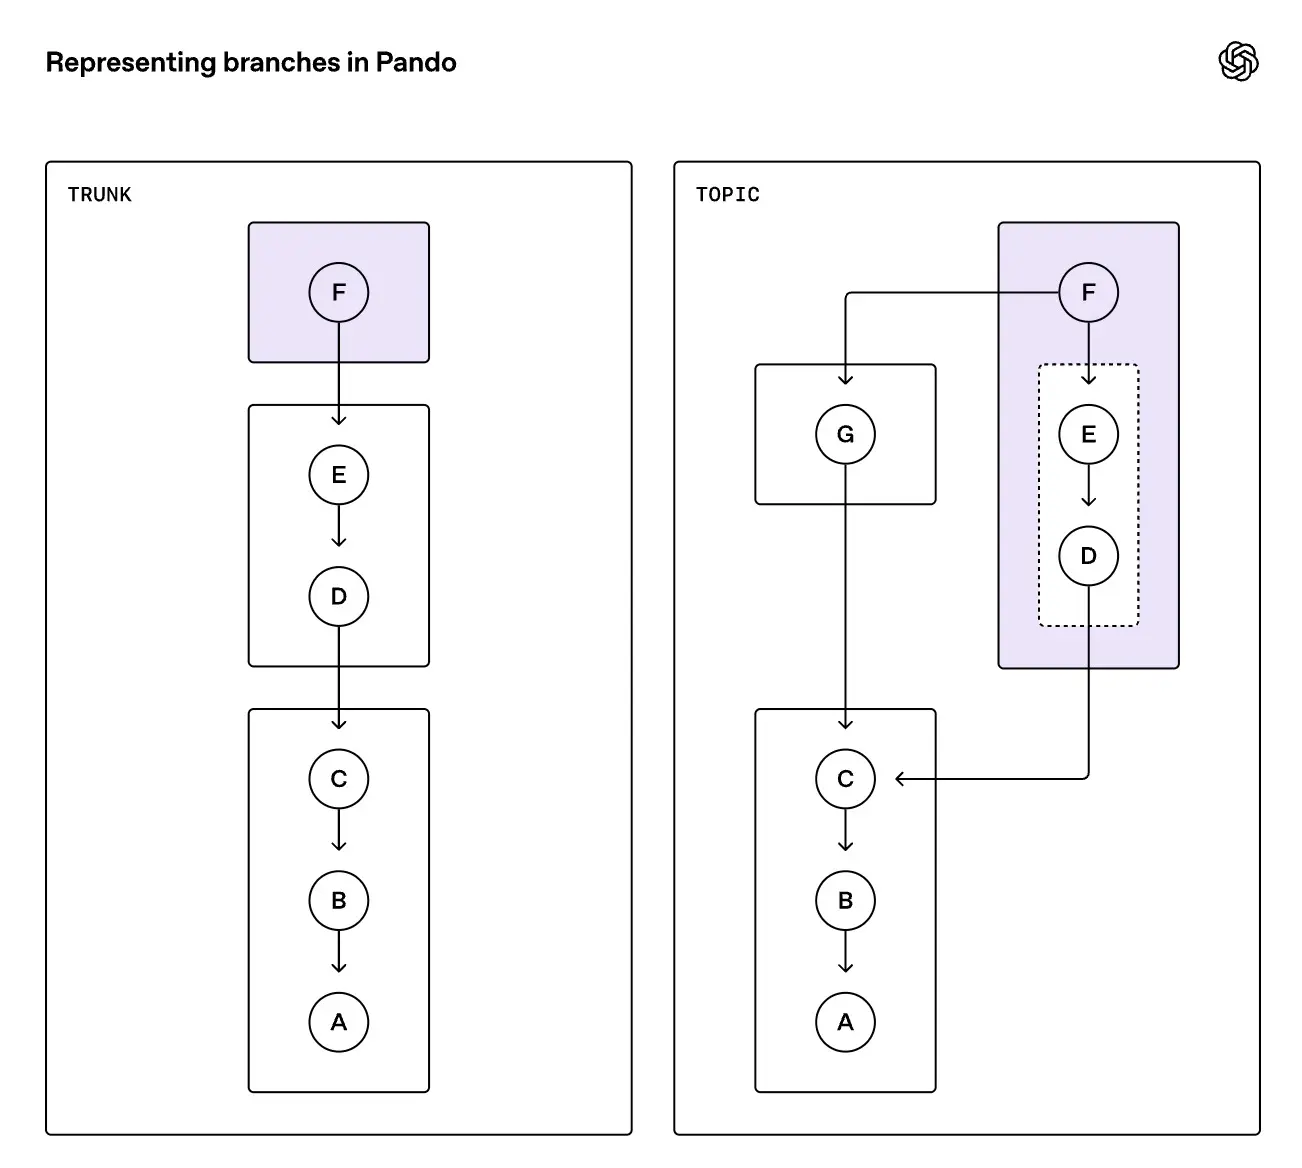
Côté lecture, le système ne construit plus un pack par client. Il sélectionne des packs déjà stockés qui couvrent les commits demandés, indique leur emplacement via la fonction packfile-uri de Git et renvoie un pack vide en ligne. Une couche de cache régionale, baptisée Express, sert ensuite ces packs, tandis que des tâches de fond compactent les packs et maintiennent des index pour planifier efficacement les réponses.
Le compromis est assumé : un client peut télécharger des objets qu’il possède déjà, mais le serveur fournit les mêmes octets à de nombreux clients avec très peu de calcul. Même logique à l’écriture : à un push, Pando n’annonce par défaut que la branche principale comme base. Les pushes successifs d’une même branche de fonctionnalité sont un peu plus lourds, mais, dans le monodépôt d’OpenAI, la taille médiane de ces packs reste sous 20 Kio et le 99e centile sous 3 Mio.
Des résultats annoncés élevés
OpenAI affirme que la latence médiane des pushes a baissé d’environ 80 %, soit près de cinq fois moins, et que la fiabilité des fusions atteint 99,99 %. Le système sert désormais près d’un pétaoctet de données Git par jour avec une poignée de cœurs de processeur, et a livré un pic de plus de 57 To de packs en une heure, dont plus de 99 % depuis le cache disque local. Il traite le trafic de production depuis avril, après un déploiement d’abord en proxy devant l’ancien système, pour migrer les outils un à un.
Le projet lui-même illustre l’usage de Codex : un seul ingénieur aurait conçu le cœur du système, des équipes d’agents l’auraient implémenté en Rust, et une poignée d’ingénieurs l’auraient déployé, en une dizaine de semaines entre le lancement et la production.
Avec GPT‑6 Astra, des agents ont aussi écrit du Lean et du TLA+ pour formaliser une « théorie de Pando » et débusquer des bugs. Le billet est signé Aaron Friel, Taylor Blau et Ted Nyman.
Les réserves à garder en tête
La cohérence causale a un prix. Il n’existe plus d’instantané unique de toutes les branches : deux clients peuvent observer des combinaisons de versions différentes d’une branche à l’autre. OpenAI juge ce modèle adapté aux agents, qui dépendent surtout de l’ordre des changements au sein d’une même référence, mais il peut poser problème aux outils qui lisent plusieurs références ensemble, comme ceux qui coordonnent des releases.
Pando reste en outre un système interne : ni code source ni API n’ont été publiés. L’entreprise publie en revanche une distribution publique de Git, avec téléchargements de packs en parallèle, et a remonté des correctifs packfile-uri au projet amont. Le billet ne nomme pas le système remplacé, et la simulation qui compare les architectures est présentée comme un modèle pédagogique, pas comme un benchmark de production.
Reste à savoir si Git saura absorber ces idées
Contrairement à Anthropic, qui a bâti un système centralisé distinct, OpenAI choisit de rester compatible avec Git. Les deux démarches convergent pourtant : serveur plus intelligent, clients plus légers, cache omniprésent. OpenAI explore déjà d’autres usages de Pando, notamment pour des charges où de nombreux agents collaborent sur un dépôt partagé.
Reste à savoir si ces techniques, aujourd’hui réservées à deux géants de l’IA, finiront dans Git lui-même, chez GitHub et GitLab, ou si les dépôts écrits par des agents imposeront durablement leur propre outillage.