
Pendant des années, laisser les robots explorer un site Web reposait sur un échange relativement simple : les moteurs indexaient les contenus et, en retour, renvoyaient des visiteurs vers les éditeurs. L’essor de l’intelligence artificielle a profondément compliqué cette relation, certains robots pouvant désormais collecter des pages pour entraîner des modèles sans nécessairement générer de trafic en retour.
Cloudflare veut redonner davantage de contrôle aux propriétaires de sites. Depuis le 15 septembre, son nouveau réglage Disallow AI Training permet de continuer à accueillir les moteurs de recherche tout en refusant que les contenus soient utilisés pour l’entraînement de modèles d’IA. Une distinction qui pourrait devenir essentielle pour l’économie du Web ouvert.
Cloudflare sépare enfin recherche et entraînement des IA
Le problème vient en partie de la manière dont les robots parcourent Internet. Un éditeur souhaite généralement laisser Google ou Bing accéder à ses pages afin qu’elles apparaissent dans les résultats de recherche. Il peut en revanche ne pas vouloir que les mêmes contenus servent à entraîner des modèles génératifs.
Cette distinction devient difficile lorsque le même crawler remplit plusieurs fonctions. Cloudflare parle de mixed-use crawlers, c’est-à-dire de robots capables d’explorer un site pour la recherche tout en participant à d’autres usages liés à l’intelligence artificielle.
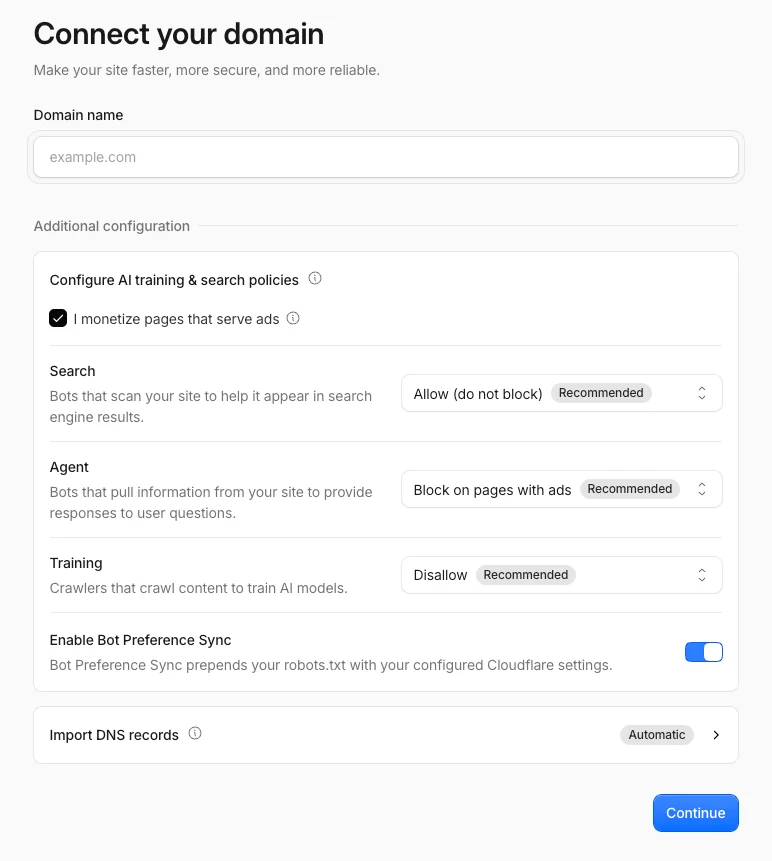
Avec Disallow AI Training, Cloudflare ajoute une couche permettant de distinguer trois grandes catégories de comportements : Search, pour l’indexation destinée aux moteurs de recherche ; Training, pour l’entraînement ou l’ajustement des modèles ; et Agent, lorsqu’un agent IA visite une page à la demande d’un utilisateur.
Le propriétaire d’un site peut ainsi accepter l’une de ces catégories sans nécessairement autoriser les autres.
Pour les robots dédiés uniquement à l’entraînement, la situation est encore plus directe. Cloudflare indique pouvoir bloquer les crawlers d’entraînement exploités notamment par Amazon, Anthropic, Meta ou OpenAI sans que cette décision affecte l’indexation classique du site dans un moteur de recherche.
« Disallow AI Training » ne repose pas uniquement sur la bonne volonté des robots
Le fichier robots.txt constitue depuis longtemps le mécanisme utilisé par les sites pour indiquer aux robots quelles pages ils peuvent ou non explorer. Mais il possède une limite fondamentale : il exprime une règle sans constituer à lui seul une barrière technique.
Un crawler peut tout simplement décider de ne pas la respecter. Cloudflare cherche précisément à dépasser cette limite grâce à sa position dans l’infrastructure réseau. Son système Bot Preference Sync peut publier automatiquement les préférences appropriées dans le fichier robots.txt, tandis que les outils de gestion des bots de Cloudflare peuvent identifier les crawlers et bloquer ceux qui ne respectent pas les règles définies par le propriétaire.
Disallow AI Training fonctionne donc différemment selon le type de robot rencontré. Pour les opérateurs que Cloudflare considère comme suffisamment transparents et respectueux des préférences des éditeurs, le robot peut continuer à explorer le site pour la recherche tout en respectant l’interdiction concernant l’entraînement. Cloudflare a créé pour cela une désignation baptisée Accountable, associée notamment à Apple, Google et Microsoft. Pour les crawlers d’entraînement distincts, Cloudflare peut simplement bloquer leur accès.
Cette combinaison entre déclaration dans robots.txt et contrôle au niveau du réseau donne davantage de poids à la préférence exprimée par l’éditeur.
Google-Extended permet déjà de conserver Google Search
Google constitue probablement le meilleur exemple de la distinction que Cloudflare cherche à généraliser. Le groupe propose depuis plusieurs années le jeton Google-Extended, que les éditeurs peuvent utiliser dans leur fichier robots.txt. Celui-ci permet de contrôler l’utilisation des contenus explorés par Google pour certaines fonctions liées à Gemini, notamment l’entraînement de futures générations de modèles et certains usages de grounding.
Google précise que le choix effectué avec Google-Extended n’affecte ni l’inclusion d’un site dans Google Search ni son classement.
Un éditeur peut donc continuer à bénéficier de l’indexation classique tout en refusant certains usages de ses contenus par Gemini.
Il existe néanmoins une nuance importante : bloquer Google-Extended ne signifie pas automatiquement disparaître des fonctions génératives directement intégrées à Google Search.
Les AI Overviews et AI Mode font partie de l’expérience de recherche de Google. Les mécanismes permettant de contrôler l’entraînement de Gemini et ceux qui déterminent l’apparition des contenus dans les fonctionnalités IA de Google Search ne sont donc pas équivalents.
Autrement dit, refuser l’entraînement n’est pas synonyme de refuser toute utilisation d’un contenu dans une réponse générée par un moteur de recherche.
Cette frontière devrait devenir l’un des prochains grands sujets pour les éditeurs.
Les sites financés par la publicité bénéficient de règles plus strictes
Cloudflare va particulièrement loin pour les nouveaux domaines dont le modèle économique repose sur la publicité. Dans sa configuration recommandée, la recherche reste autorisée tandis que l’entraînement des modèles peut être désactivé. Les agents peuvent également être bloqués spécifiquement sur les pages où Cloudflare détecte la présence de publicités.
La logique économique est assez claire.
Une page financée par la publicité génère généralement des revenus lorsqu’un internaute la consulte. Un moteur de recherche peut participer à ce modèle puisqu’il envoie potentiellement l’utilisateur vers le site.
Un agent IA peut fonctionner différemment. S’il consulte une page, récupère l’information et la restitue directement à son utilisateur, celui-ci n’a plus nécessairement besoin de visiter le site d’origine. La publicité n’est alors jamais affichée.
Pour Cloudflare, l’attention humaine devient donc un élément à protéger sur les pages financées par ce modèle. Cette distinction entre moteurs de recherche, agents et robots d’entraînement montre à quel point la notion de « bot » est devenue trop générale. Deux crawlers peuvent télécharger exactement la même page tout en créant des conséquences économiques radicalement différentes pour son éditeur.
Le vieux contrat entre les sites et les robots est en train d’être renégocié
L’enjeu dépasse largement les paramètres de Cloudflare. Pendant une grande partie de l’histoire du Web, l’exploration automatique reposait sur une forme de compromis implicite. Les éditeurs autorisaient Google et les autres moteurs à copier et analyser leurs pages pour construire leurs index ; en contrepartie, ces services devenaient une source majeure de trafic.
L’intelligence artificielle modifie cet équilibre.
Un modèle peut apprendre à partir d’un contenu sans jamais renvoyer directement un visiteur vers sa source. Un assistant peut également consulter plusieurs pages, synthétiser leurs informations et fournir une réponse complète sans que l’utilisateur ouvre le moindre lien.
Pour les éditeurs financés par la publicité, les abonnements ou les ventes directes, cette évolution pose une question fondamentale : quelle valeur reçoivent-ils en échange de l’accès automatisé à leurs contenus ? Cloudflare révèle d’ailleurs une différence significative dans les comportements de ses clients. Selon l’entreprise, moins de 1 % de ses sites choisissent de bloquer les robots de recherche, tandis que 17 % activent déjà un mécanisme destiné à empêcher l’entraînement des modèles.
Les éditeurs ne cherchent donc pas nécessairement à fermer leur contenu aux machines. Ils veulent pouvoir décider pourquoi une machine vient le consulter.
Après l’entraînement, la prochaine bataille sera celle des résumés IA
Disallow AI Training apporte une réponse relativement claire à la question de l’entraînement, mais elle ne règle qu’une partie du problème. Cloudflare considère déjà les résumés générés par IA comme la prochaine étape. L’entreprise estime qu’un simple choix entre autoriser et interdire risque d’être trop rudimentaire, car la quantité de contenu reproduite ou synthétisée dans une réponse peut être aussi importante que le principe même de son utilisation.
Son objectif est de permettre à terme aux éditeurs de mieux contrôler la manière dont leurs contenus peuvent apparaître dans ces expériences, sans avoir à configurer séparément chaque opérateur.
Cette évolution pourrait devenir déterminante à mesure que moteurs de recherche et assistants convergent. La distinction ne sera bientôt plus simplement entre « Googlebot autorisé » et « robot IA bloqué ». Un même service pourra indexer une page, générer un résumé, répondre à une question, déclencher un agent et éventuellement utiliser certains contenus pour améliorer ses modèles.
Cloudflare tente donc de remplacer une logique binaire par une gestion fondée sur l’usage réel du contenu. Et c’est probablement là que se joue une partie de l’avenir du Web. Les éditeurs n’ont pas nécessairement intérêt à fermer leurs portes aux IA, pas plus qu’ils n’avaient intérêt à disparaître des moteurs de recherche. Mais ils ont besoin de savoir ce qu’ils obtiennent en échange.
Avec Disallow AI Training, Cloudflare transforme finalement une question longtemps présentée comme « faut-il bloquer les robots IA ? » en une question beaucoup plus pertinente : « qu’autorisez-vous exactement les robots à faire avec votre contenu ? ».


