
OpenAI utilise désormais ses propres modèles d’intelligence artificielle pour contribuer à la conception de ses puces. Et l’expérience donne lieu à une situation pour le moins paradoxale : les modèles ont réussi à optimiser certaines parties de la puce Jalapeño sans que les ingénieurs comprennent toujours précisément comment ni pourquoi leurs modifications fonctionnaient.
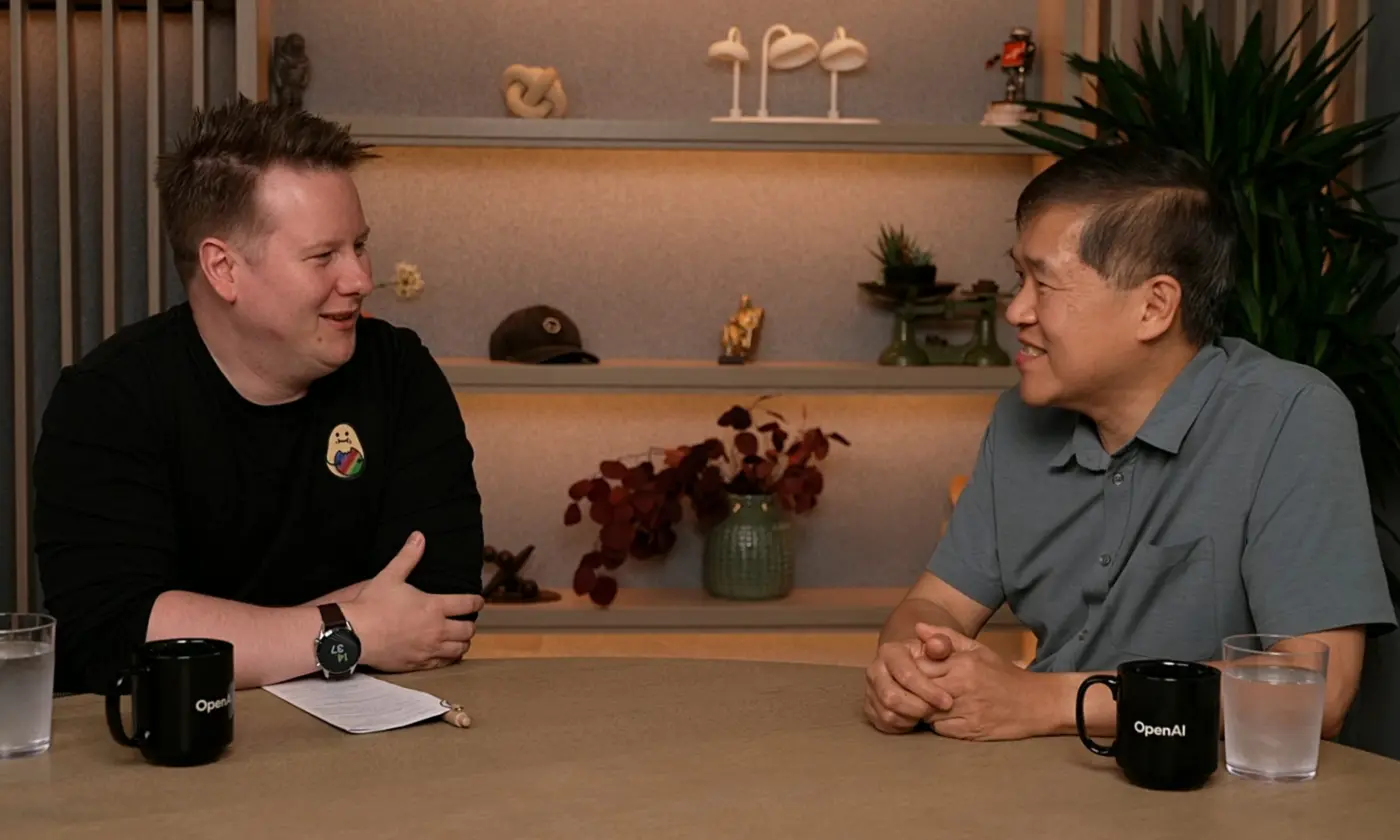
Richard Ho, qui dirige l’équipe hardware d’OpenAI et a notamment participé aux débuts du programme TPU de Google, explique que certaines optimisations ont permis de réduire de plus de 13 % la surface du die dans un cas précis. Mais malgré ces résultats, il affirme ne pas faire totalement confiance aux modèles.
Quand l’IA aide à faire tenir davantage de logique
OpenAI a dévoilé sa propre puce Jalapeño en juin, développée avec Broadcom pour exécuter ses modèles d’IA. Contrairement aux GPU destinés à l’entraînement, cette puce est conçue pour l’inférence, c’est-à-dire l’exécution des modèles une fois ceux-ci entraînés.
Lors de la conception, l’équipe s’est rapidement retrouvée confrontée à un problème très concret : ses premières estimations concernant la quantité de logique pouvant tenir sur la puce étaient légèrement erronées. Plutôt que de réduire les performances prévues, les ingénieurs ont alors demandé à leurs modèles internes de chercher des optimisations.
À cette époque, ces modèles n’étaient pas spécialement entraînés ou affinés pour la conception de puces. Richard Ho explique qu’ils étaient simplement des modèles internes légèrement plus avancés que ceux accessibles au public.
Pourquoi XLS a joué un rôle important ?
Une grande partie du code manipulé par les modèles était écrite en XLS, un outil permettant de transformer du code de haut niveau en logique matérielle. Le langage a notamment un avantage pour les modèles d’IA : sa syntaxe se rapproche davantage de Rust que de Verilog, le langage traditionnellement utilisé pour décrire les circuits électroniques.
Selon Ho, les modèles étaient plus efficaces pour raisonner sur du code logiciel que sur du Verilog directement. XLS leur a donc fourni une abstraction plus adaptée pour intervenir dans la conception de la puce.
Cette approche permettait aux modèles de proposer des modifications du code source susceptibles d’améliorer l’implémentation matérielle finale.
Certaines optimisations restaient incompréhensibles
C’est là que l’expérience devient particulièrement intéressante. Les modèles ont parfois proposé des modifications dont les ingénieurs ne comprenaient pas clairement la logique. Certaines semblaient pourtant améliorer le design, notamment en réduisant la surface occupée par certaines parties de la puce.
L’équipe avançait suffisamment rapidement pour ne pas pouvoir s’arrêter systématiquement afin d’analyser conceptuellement chaque optimisation.
Le problème est évident : lorsqu’un modèle produit une modification efficace mais dont le raisonnement reste difficile à expliquer, il devient compliqué de savoir si le résultat repose sur une véritable optimisation ou sur un comportement plus fragile.
Une puce ne peut pas se contenter d’être « presque correcte »
OpenAI n’a donc pas simplement accepté les modifications générées par ses modèles. Chaque changement est passé par l’intégralité du processus de validation, tandis que les outils traditionnels de conception électronique ont continué à effectuer la vérification finale.
Richard Ho insiste sur un point essentiel : une puce peut contenir des centaines de millions de portes logiques. Une IA correcte 99,99 % du temps reste donc très loin d’être suffisamment fiable pour remplacer les mécanismes classiques de validation. L’approche d’OpenAI consiste plutôt à considérer cette prise de risque comme acceptable si elle est accompagnée de contrôles rigoureux.
Et surtout, Ho ne considère pas ces modèles comme une raison de réduire les effectifs. L’objectif est de permettre aux ingénieurs de faire davantage de travail, plus rapidement.
Une architecture pensée pour toute l’inférence
Jalapeño adopte également une approche inhabituelle concernant l’inférence. Une partie de l’industrie tend à utiliser des architectures distinctes pour les deux grandes phases d’une génération : le prefill, qui traite la requête initiale, et le decode, qui génère progressivement la réponse.
OpenAI a choisi de concevoir une architecture capable de prendre en charge les deux. Richard Ho estime qu’une infrastructure séparée peut devenir difficile à dimensionner lorsque la répartition entre les différents types de tâches évolue constamment. Construire une capacité avec un ratio fixe entre prefill et decode peut donc conduire à sous-utiliser une partie du matériel.
Avec une architecture commune, OpenAI cherche à rendre son infrastructure plus flexible.
Cependant, cette décision n’est pas sans compromis. Ho reconnaît que certains coûts pourraient n’apparaître qu’une fois la puce déployée à grande échelle, notamment avec des contextes extrêmement longs.
La mémoire directement reliée aux cœurs
Jalapeño adopte également une autre approche : les banques de mémoire à haute bande passante sont directement reliées aux cœurs de calcul. L’objectif est de limiter les déplacements de données, qui représentent une part importante des coûts et des contraintes dans les systèmes d’IA modernes.
Richard Ho estime que cette approche pourrait être reprise à terme par d’autres acteurs du secteur, y compris les fabricants de GPU. OpenAI a pourtant choisi de publier cette information alors même que Nvidia reste l’un de ses principaux fournisseurs de matériel. La raison est pragmatique : OpenAI continue d’avoir besoin de GPU et souhaite que ceux-ci progressent également.
Jalapeño 2 est déjà en préparation
La première génération n’est d’ailleurs plus le seul projet sur lequel travaille OpenAI. La deuxième version de Jalapeño est déjà en laboratoire pour sa phase de qualification, alors que l’entreprise se rapproche de la production en volume. Cette accélération illustre l’évolution du rôle d’OpenAI dans l’infrastructure IA. L’entreprise ne se contente plus de concevoir des modèles : elle cherche également à contrôler une partie du matériel capable de les faire fonctionner à grande échelle.
Mais l’expérience de Jalapeño montre aussi les limites actuelles de cette approche. L’IA peut déjà découvrir des optimisations que les ingénieurs n’auraient pas nécessairement trouvées eux-mêmes. Le défi consiste désormais à exploiter cette capacité sans perdre la compréhension et le contrôle du système conçu.