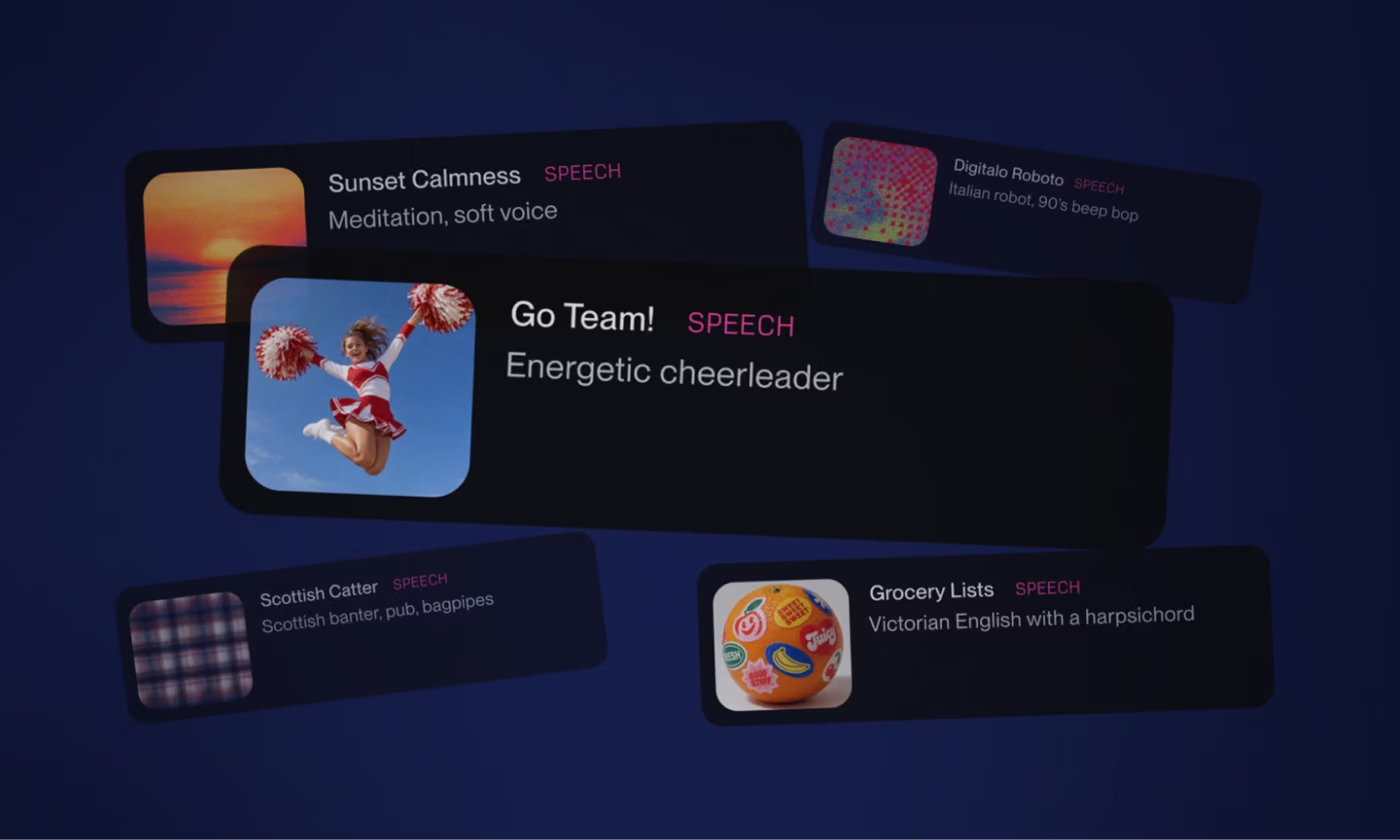

Suno veut désormais aller au-delà de la génération musicale. La plateforme spécialisée dans la création de morceaux par intelligence artificielle lance Speech, une nouvelle fonctionnalité capable de générer des voix parlées à partir d’un script ou d’une simple description.
Disponible en bêta publique sur le web et les applications mobiles de Suno, Speech peut surtout faire quelque chose de différent des solutions classiques de synthèse vocale : générer simultanément la voix et une musique d’accompagnement dans une même piste audio.
Suno ne veut plus seulement créer de la musique
« La musique sera toujours au cœur de Suno », explique Jack Brody, directeur produit de l’entreprise. Mais, Suno souhaite désormais étendre sa technologie à d’autres formes d’expression audio.
L’idée de Speech est donc de rapprocher la génération vocale et la création musicale. Plutôt que de produire uniquement une voix artificielle à partir d’un texte, Suno peut créer une ambiance sonore complète autour du discours.
Toutefois, la musique reste optionnelle. Un bouton permet de la désactiver afin d’obtenir uniquement la voix générée, comme avec un service traditionnel de text-to-speech.
Deux façons de créer une voix
Suno propose deux modes pour utiliser Speech. Le mode Simple permet de décrire directement ce que l’on souhaite obtenir dans un champ de prompt. Il est par exemple, possible de demander la voix d’un capitaine pirate encourageant son équipage.
Le mode Advanced s’adresse davantage aux utilisateurs qui savent exactement ce qu’ils veulent faire dire à la voix. Ils peuvent fournir leur propre script et ajuster différents paramètres de génération.
Les réglages avancés permettent notamment de modifier le genre de la voix, son style de diction ainsi que le niveau de variété entre les différentes générations. La durée maximale d’une création Speech est d’environ huit minutes.
Une approche différente du text-to-speech
La génération de voix par IA n’est évidemment pas nouvelle. Google travaille depuis longtemps sur la synthèse vocale basée sur l’apprentissage profond, tandis qu’Adobe propose ses propres outils et qu’ElevenLabs s’est imposé comme l’un des acteurs les plus visibles du secteur depuis son lancement en 2023.
Suno ne cherche donc pas à réinventer la synthèse vocale sur tous les fronts. Son originalité repose plutôt sur la combinaison native entre voix et musique générée.
Cette approche pourrait être intéressante pour des contenus où la voix seule paraît trop froide. Un poème pourrait être accompagné d’une musique douce, une narration pourrait bénéficier d’une ambiance plus cinématographique ou un discours motivant pourrait recevoir une bande-son plus énergique.
Une diversification bienvenue pour Suno
Le lancement de Speech intervient aussi alors que Suno cherche à élargir son activité au-delà de la génération musicale. Le secteur de la musique générée par IA fait en effet l’objet de nombreuses controverses et procédures judiciaires autour de l’utilisation d’œuvres protégées pour entraîner les modèles.
Une fonctionnalité consacrée à la voix permet à Suno de diversifier les usages de sa technologie sans abandonner son positionnement historique autour de l’audio génératif.
La société insiste d’ailleurs sur le fait que la musique restera au centre de sa plateforme. Speech apparaît davantage comme une extension de son modèle que comme un abandon de la génération musicale.
Une bêta qui assume encore ses défauts
Suno prévient néanmoins que Speech est loin d’être parfait. Jack Brody assume pleinement le statut de bêta de la fonctionnalité, en expliquant que certaines générations peuvent encore produire des résultats inattendus.
Les accents peuvent notamment dériver au cours d’une génération, tandis que les pauses dramatiques peuvent devenir particulièrement… dramatiques. Suno estime également que les utilisateurs vont probablement trouver des usages auxquels l’entreprise n’avait pas pensé.
C’est justement l’intérêt de cette phase de bêta : confronter le modèle à des scripts, des styles et des situations beaucoup plus variés que ceux utilisés pendant son développement.
Une nouvelle étape pour les outils audio génératifs
Avec Speech, Suno transforme donc progressivement sa plateforme en un outil de création audio plus large. La frontière entre musique, narration, voix off et ambiance sonore devient moins nette, puisque les différents éléments peuvent désormais être générés ensemble.
La fonctionnalité ne menace pas directement les spécialistes de la synthèse vocale sur leur propre terrain. Elle propose plutôt une autre approche, dans laquelle la voix n’est plus nécessairement un élément isolé, mais une composante d’une création audio complète.
La prochaine étape sera de voir si cette combinaison voix-musique apporte réellement une valeur ajoutée aux créateurs ou si elle reste principalement une curiosité parmi les nombreuses possibilités de l’IA générative.