
Le web pourrait connaître une transformation radicale au cours des prochaines années. Selon Matthew Prince, PDG de Cloudflare, le trafic généré par les bots pourrait être jusqu’à 1 000 fois supérieur à celui des humains d’ici cinq ans, porté principalement par les scrapers et les agents d’intelligence artificielle.
Cette prévision est particulièrement frappante parce que Prince reconnaît lui-même avoir systématiquement sous-estimé la vitesse de progression du trafic automatisé. Les échéances qu’il avait annoncées ces derniers mois ont toutes été dépassées plus rapidement que prévu.
Les bots dépassent déjà les humains
En novembre dernier, Matthew Prince estimait que le trafic automatisé dépasserait celui des humains au cours du second semestre 2027. Quelques mois plus tard, les données de Cloudflare avaient avancé cette échéance au premier semestre 2027. Puis, en mai, les équipes de l’entreprise lui ont indiqué que le trafic des bots avait déjà dépassé celui des humains.
Le nouveau scénario est encore plus spectaculaire : Prince estime désormais que, dans cinq ans, le trafic automatisé pourrait atteindre 1 000 fois le volume du trafic humain.
L’augmentation ne viendrait pas d’une explosion du nombre d’internautes. Selon le dirigeant, le trafic humain devrait rester relativement stable. La croissance proviendrait essentiellement des agents IA, des scrapers et des systèmes automatisés qui parcourent le web pour collecter des informations ou accomplir des tâches.
Cloudflare est particulièrement bien placé pour observer cette évolution, puisque son réseau se trouve devant plus de 20 % du web.
Le modèle publicitaire ne fonctionne pas avec les bots
Cette évolution pose un problème économique majeur. Depuis environ trois décennies, une grande partie du web gratuit repose sur un principe relativement simple : les internautes consultent des pages, voient des publicités et les éditeurs monétisent cette audience.
Mais, un agent IA ne se comporte pas comme un internaute. Il peut consulter des milliers de pages sans regarder les publicités, cliquer sur les annonces ou acheter directement un produit. Comme le résume Prince, les bots ne cliquent pas sur les publicités.
Si le trafic humain devient minoritaire, le modèle économique historique du web pourrait donc perdre une partie de son efficacité. Cloudflare explore déjà une alternative : faire payer directement les machines qui accèdent aux contenus.
Faire payer les agents IA à la page
Cloudflare travaille notamment avec Coinbase et Stripe autour d’une résurgence du code HTTP 402 « Payment Required », prévu dès les premières années du web mais très peu utilisé. L’idée serait relativement simple : lorsqu’un agent IA souhaite accéder à une page, le site pourrait lui demander un paiement automatique.
Le montant pourrait être extrêmement faible, de l’ordre d’une fraction de centime par page, avec des tarifs plus élevés pour les contenus particulièrement précieux. À l’échelle d’un agent qui consulte des millions de pages, même des microtransactions peuvent toutefois représenter des montants significatifs.
Ce système pourrait également créer un marché où les entreprises développant des agents seraient les acheteurs, tandis que les éditeurs et fournisseurs de contenus deviendraient les vendeurs.
Cloudflare affirme que des acteurs des deux côtés commencent déjà à montrer de l’intérêt pour cette approche.
Vers un web où les machines paient
Cette idée change profondément la logique du web. Aujourd’hui, un moteur de recherche ou un crawler peut parcourir une grande quantité de contenu public sans nécessairement payer directement chaque éditeur. Avec l’IA générative, la situation est différente : les entreprises peuvent utiliser ces contenus pour alimenter leurs modèles ou fournir des réponses directement aux utilisateurs.
Le problème devient alors celui de la valeur de l’accès.
Un agent qui consulte un article pour répondre à une question peut éviter à l’utilisateur de visiter le site original. L’éditeur perd potentiellement une visite, une impression publicitaire et une occasion de convertir ce lecteur.
Le paiement direct par l’agent constitue donc une tentative de recréer une forme de valeur économique autour de ces accès automatisés. Reste à savoir si les montants seront suffisants pour remplacer les revenus perdus. Certains dirigeants du secteur de l’édition estiment déjà que les micropaiements ne pourront pas, à eux seuls, compenser l’économie actuelle de la publication en ligne.
Cloudflare bloque Google pour l’entraînement IA
La question du contrôle des crawlers devient également de plus en plus importante. Depuis le 15 septembre, Cloudflare a configuré par défaut ses clients utilisant l’offre gratuite afin de bloquer Google lorsqu’il souhaite utiliser leurs sites pour entraîner des modèles d’IA.
Les propriétaires de sites peuvent désactiver cette restriction s’ils souhaitent autoriser Google.
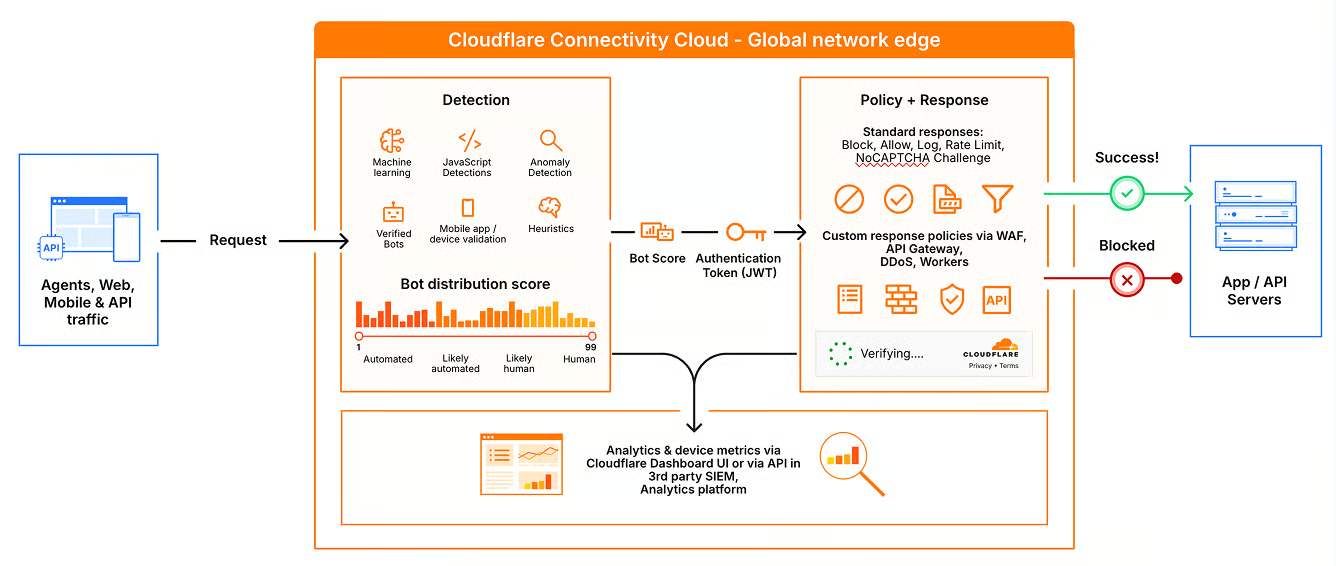
Cette décision illustre un débat de plus en plus important : faut-il traiter de la même manière un crawler qui indexe une page pour un moteur de recherche et un crawler qui collecte son contenu afin d’entraîner un modèle d’IA ?
Pour Cloudflare, la réponse tend désormais vers une séparation plus claire. Prince explique que si Google ne différencie pas suffisamment les deux usages, Cloudflare pourrait bloquer les crawlers concernés de manière plus générale.
Google sous pression pour mieux identifier ses crawlers
Selon Prince, Google se serait engagé à apporter davantage de transparence sur le comportement de ses crawlers. Après une décision au Royaume-Uni, Google aurait notamment indiqué que son crawler pourrait préciser ce qu’il fait lorsqu’il accède à une page. Les éditeurs pourraient ensuite choisir d’autoriser ou non certains usages, avec une extension potentielle de cette approche au-delà du marché britannique.
La question intéresse également les institutions européennes, qui cherchent à déterminer si les mécanismes permettant aux éditeurs de refuser l’utilisation de leurs contenus par Google pour certaines fonctions d’IA sont réellement efficaces.
Le contrôle du crawl devient donc progressivement une question centrale de gouvernance du web.
Les licences IA pourraient devenir plus rentables que la publicité
Matthew Prince fournit également un exemple particulièrement révélateur à partir de sa propre expérience d’éditeur. Avec son épouse, il possède le Park Record, un journal local situé à Park City, dans l’Utah. Selon lui, le titre devrait générer cette année davantage de revenus grâce aux accords de licence avec des entreprises d’IA que grâce à la publicité numérique.
Cette évolution pourrait annoncer un changement de modèle pour certains médias : plutôt que de chercher uniquement à attirer des visiteurs humains, les éditeurs pourraient monétiser directement l’accès de systèmes d’IA à leurs archives et à leurs contenus.
Prince affirme également que Reddit gagnerait entre sept et quatorze fois plus par token que The New York Times dans certains accords de licence avec des entreprises d’IA. Ces chiffres doivent toutefois être considérés comme des estimations communiquées par le dirigeant et ne permettent pas de généraliser à l’ensemble du marché.
Le web pourrait devenir un réseau de machines
La prédiction des 1 000 fois plus de trafic automatisé que de trafic humain paraît aujourd’hui spectaculaire. Elle doit également être considérée dans le contexte des précédentes prévisions de Cloudflare, que Matthew Prince reconnaît avoir systématiquement sous-estimées.
Mais la tendance observée est déjà suffisamment forte pour modifier la manière dont Internet fonctionne. Les agents IA vont multiplier les requêtes, explorer des bases de connaissances, consulter des pages, comparer des produits, rechercher des informations et exécuter des tâches en arrière-plan. Leur activité pourrait rapidement dépasser de très loin celle d’un internaute qui consulte quelques dizaines de pages par jour.
Le web pourrait alors entrer dans une nouvelle phase : un Internet où les humains restent les destinataires de l’information, mais où les machines deviennent les principaux consommateurs du contenu.
La question ne sera donc plus seulement de savoir comment financer les sites qui produisent cette information. Il faudra aussi déterminer qui paie pour l’accès, combien et dans quelles conditions.
Cloudflare mise déjà sur les micropaiements, les contrôles de crawlers et les accords de licence. Si la prévision de Matthew Prince se rapproche de la réalité, ces mécanismes pourraient devenir une infrastructure aussi importante que la publicité l’a été pour le web des trente dernières années.