Sur le papier, tout est simple : Claude Code et ChatGPT s’ouvrent à 20 dollars par mois, GitHub Copilot à 10 dollars. Dans les faits, la facture d’un développeur qui travaille chaque jour avec un agent de code n’a plus grand-chose à voir avec ces étiquettes. Les données d’Anthropic sur ses déploiements en entreprise donnent 13 dollars par développeur et par jour actif, soit 150 à 250 dollars par mois.
L’écart s’explique par un changement de fond intervenu en 2026 : OpenAI Codex, Copilot et Claude Code comptent tous, à leur manière, la consommation de tokens plutôt que le nombre de messages ou de requêtes. Cette enquête compare les trois grilles, décompose une séance de travail, liste ce qui fait grimper la facture et indique quoi surveiller.
Ce que ce dossier est, et n’est pas. Il repose sur les grilles et la documentation officielles de chaque éditeur, recoupées par des guides tiers. Je n’ai pas exécuté la même tâche sur les trois agents, ni évalué la qualité du code produit : les montants sont des estimations à partir de tarifs publics, jamais des mesures sur un chantier réel. Chaque chiffre renvoie à une source listée en fin d’article.
Trois étiquettes de prix qui en disent peu
Les abonnements se ressemblent d’un éditeur à l’autre : un palier d’entrée autour de 10 à 20 dollars, un palier intermédiaire, puis un palier « gros consommateur » à 100 dollars et plus. Mais chacun ne mesure pas la même chose.
| Palier | Claude Code | OpenAI Codex | GitHub Copilot |
|---|---|---|---|
| Entrée | Pro : 20 $/mois (17 $ en annuel) | Plus : 20 $/mois (Go : 8 $ pour un usage léger) | Pro : 10 $/mois, 1 500 crédits |
| Intermédiaire | Max 5x : 100 $/mois | Pro 5x : à partir de 100 $/mois | Pro+ : 39 $/mois, 7 000 crédits |
| Gros usage | Max 20x : 200 $/mois | Pro 20x : tarif supérieur (jusqu’à 200 $/mois selon les guides) | Max : 100 $/mois, 20 000 crédits |
| Équipe | Team : 20 à 25 $ (standard) ou 100 à 125 $ (premium) par siège | Business : 20 $ par utilisateur (annuel) | Business : 19 $ ; Enterprise : 39 $ par siège |
Ce tableau appelle deux réserves. D’abord, un même prix ne donne pas le même volume : chez Anthropic et OpenAI, les paliers supérieurs se définissent comme un multiple du palier d’entrée (5x, 20x), sans quantité absolue affichée. Chez GitHub, au contraire, l’allocation est chiffrée en crédits. Ensuite, aucun de ces montants ne dit ce qui se passe quand on dépasse : c’est là que la facture change de nature.
« Le prix de l’abonnement est devenu l’acompte : c’est la consommation de tokens qui fait la facture. »
Tout le monde facture désormais au token
Le point commun des trois grilles tient en une phrase : la consommation se mesure en tokens, l’unité de texte que le modèle lit et écrit. Les modalités diffèrent.
- Anthropic : la documentation de Claude Code précise que l’outil est facturé à la consommation de tokens de l’API. Sur abonnement, l’usage puise dans une allocation à deux fenêtres — une session de cinq heures glissantes et un plafond hebdomadaire — partagée avec le chat. Au-delà, des « crédits d’usage » prolongent le travail aux tarifs de l’API.
- OpenAI : Codex est inclus dans tous les plans ChatGPT, sans abonnement séparé. Depuis le 2 avril 2026, la tarification par message a été retirée pour Plus, Pro et Business au profit de crédits alignés sur les tokens (environ 0,04 $ le crédit selon les guides), sur une fenêtre glissante de cinq heures.
- GitHub : depuis le 1er juin 2026, les AI Credits remplacent les requêtes premium. Chaque plan inclut une enveloppe mensuelle, consommée selon les tokens réellement utilisés, au tarif API de chaque modèle. Les complétions de code restent gratuites et ne consomment aucun crédit.
Autrement dit, l’abonnement fait office d’acompte. Tant qu’on reste dans l’enveloppe, la facture est fixe ; dès qu’on la dépasse, on paie à l’unité. Chez GitHub, une nuance notable : le repli automatique vers un modèle moins cher, qui permettait de continuer à moindre coût, a été supprimé.
Une séance de travail, décomposée
Pour rendre ces unités concrètes, prenons l’exemple que la documentation de Claude Code donne de sa commande /usage : une séance totalisant 6 minutes de temps d’API et cumulant 1,2 k tokens d’entrée, 5,3 k de sortie, 940 k lus dans le cache et 50 k écrits dans le cache. Elle affiche 0,55 $ avec Sonnet 4.6.
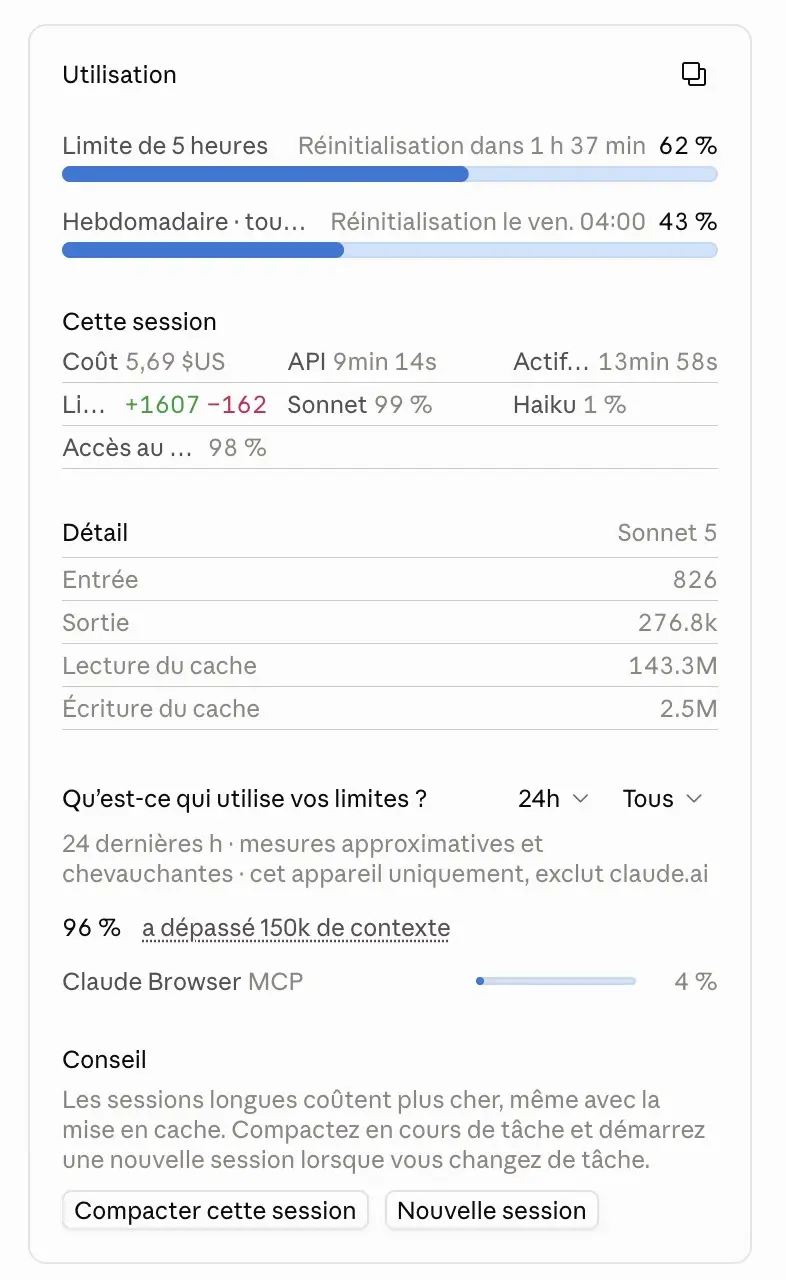
Ce qui frappe, c’est la répartition. Sur ces 0,55 $, 51 % viennent de la lecture du cache (0,28 $), 34 % de son écriture (0,19 $) et seulement 14 % de la sortie, c’est-à-dire du code que l’agent produit (0,08 $). L’agent paie surtout pour relire ce qu’il sait déjà. Appliquons ce même profil aux tarifs actuels, en calcul BlogNT :
| Modèle | Tarif (entrée / sortie, par million de tokens) | Coût de la même séance |
|---|---|---|
| Claude Haiku 4.5 | 1 $ / 5 $ | 0,18 $ |
| Claude Sonnet 5 | 2 $ / 10 $ | 0,37 $ |
| Claude Sonnet 4.6 (référence de la doc) | 3 $ / 15 $ | 0,55 $ |
| Claude Opus 5 | 5 $ / 25 $ | 0,92 $ |
Deux enseignements. Le choix du modèle pèse plus que le choix de l’outil : Opus 5 coûte 2,5 fois plus que Sonnet 5 pour la même séance. Et il faut lire ces chiffres avec prudence : Anthropic précise que les modèles depuis Claude 4.7 utilisent un tokenizer qui produit environ 30 % de tokens en plus pour un même texte. L’économie de Sonnet 5 sur Sonnet 4.6, de 33 % au tarif catalogue, pourrait donc tomber autour de 13 % à volume de texte égal.
Le constat vaut chez OpenAI. Pour un abonné Plus, la page tarifaire de Codex annonce des fenêtres de cinq heures très différentes selon le modèle : de 5 à 45 messages avec GPT-6 Astra, mais 250 à 2 000 avec GPT-5.6 Luna.
Entre le modèle le plus lourd et le plus léger, l’écart de volume est de l’ordre de 50. Le coût moyen annoncé pour GPT-5.6 se situe entre 5 et 30 crédits par message, soit, à 0,04 $ le crédit, entre 0,20 et 1,20 $ par message une fois l’enveloppe dépassée.
Ce qui fait exploser la facture
La documentation d’Anthropic, la plus détaillée des trois sur le sujet, énumère elle-même les causes de dérive. Elles valent, en principe, pour n’importe quel agent :
- Le contexte long. À chaque requête, l’outil renvoie toute la conversation. Une simple question posée dans une séance ouverte depuis le matin consomme donc l’équivalent de tout l’historique.
- Les ratés de cache. Le premier message après une pause plus longue que la durée de vie du cache retraite tout le contexte. Cette durée est d’une heure sur abonnement, mais tombe à cinq minutes dès qu’on puise dans les crédits d’usage ou qu’on passe par l’API.
- Les équipes d’agents. Plusieurs instances en parallèle consomment chacune leur propre contexte : environ 7 fois plus de tokens qu’une séance standard lorsque les coéquipiers travaillent en mode plan, selon la documentation.
- La réflexion. Les tokens de raisonnement sont facturés comme des tokens de sortie, et le budget par défaut peut atteindre des dizaines de milliers de tokens par requête.
- Les tâches planifiées. Une boucle programmée se déclenche à intervalle fixe, y compris quand la séance est inactive, en renvoyant à chaque fois tout le contexte.
- Le mode rapide. Sur Opus 5, il double le tarif : 10 $ / 50 $ par million de tokens au lieu de 5 $ / 25 $.
Le point commun de ces mécanismes : ils sont invisibles à l’usage. Rien, dans une conversation qui progresse normalement, ne signale qu’on vient de retraiter cent mille tokens parce qu’on a déjeuné.
Le budget d’une équipe : le siège n’est que l’acompte
Pour une entreprise, l’écart entre l’étiquette et la réalité est plus net encore. Un siège Copilot Business coûte 19 dollars et inclut 1 900 crédits, soit environ 19 dollars de consommation à 0,01 $ le crédit : aucun effet de levier. Chez GitHub, l’effet de levier n’existe qu’à l’achat individuel : 1,5 fois le prix pour Pro, environ 1,8 pour Pro+ (7 000 crédits pour 39 $), 2 pour Max (20 000 crédits pour 100 $).
Comparez avec la moyenne mesurée par Anthropic : 150 à 250 dollars par développeur et par mois, avec 90 % des utilisateurs sous 30 dollars par jour actif. Un siège à 20 ou 125 dollars ne couvre pas, à lui seul, un usage intensif : l’écart est comblé par des crédits d’usage à tarif API, que les administrateurs peuvent autoriser ou plafonner par organisation, par groupe ou par personne. Le siège Enterprise de Claude est d’ailleurs affiché 20 $, avec un coût d’usage qui varie selon le modèle et la tâche.
Ma conclusion budgétaire est simple : pour une équipe, la ligne « abonnement » est marginale ; la ligne à piloter est l’enveloppe de dépassement, avec un plafond par personne et un suivi par outil. Anthropic (analyses par utilisateur, limites de dépense) et GitHub (budgets et plafonds) documentent ces contrôles ; côté OpenAI, les dépassements se facturent en crédits et se suivent par plan.
Des règles qui changent tous les trois mois
Il faut aussi tenir compte d’une instabilité qui rend toute comparaison périssable. En 2026 seulement :
- 2 avril : OpenAI retire la tarification par message de Codex pour Plus, Pro et Business, au profit de crédits alignés sur les tokens.
- 1er juin : GitHub remplace les requêtes premium de Copilot par des AI Credits, et supprime le repli vers un modèle moins cher.
- 12 juillet : OpenAI lève temporairement la limite de cinq heures pour Plus, Business et Pro, sans date de fin annoncée ; les plafonds hebdomadaires restent en vigueur.
- Août-septembre : Anthropic renonce à la hausse de Sonnet 5 de 2 $ / 10 $ à 3 $ / 15 $ qu’il avait planifiée pour le 1er septembre. Le tarif introductif devient le tarif standard.
Ces mouvements vont dans les deux sens, ce qui est justement le problème : on ne peut pas prévoir un budget annuel sur un tarif qui bouge en cours d’année. Nous suivons ces grilles et actualiserons cette enquête à chaque changement notable.
Garder la main sur la facture, et choisir son plan
À partir de la documentation d’Anthropic et des grilles des deux autres éditeurs, six réflexes reviennent, quel que soit l’outil :
- Effacer entre deux tâches sans rapport (commande
/cleardans Claude Code) : un contexte périmé alourdit chaque message suivant. - Adapter le modèle à la tâche. Réserver le modèle le plus lourd aux décisions d’architecture, garder un modèle léger pour le reste.
- Régler l’effort de réflexion sur les tâches simples, plutôt que de laisser le maximum par défaut.
- Planifier avant d’exécuter : un mode « plan » évite de refaire un chantier parti dans la mauvaise direction.
- Filtrer les sorties volumineuses (journaux, tests) avant qu’elles n’entrent dans le contexte, par exemple avec des hooks.
- Fixer un plafond de dépense dès le premier jour, par personne, et le relire chaque mois.
Reste la question du plan. Notre lecture, avec les réserves d’usage sur des tarifs qui évoluent :
- Usage occasionnel : Copilot Pro, à 10 dollars, garde l’avantage. Les complétions sont gratuites et 1 500 crédits couvrent un agent de temps en temps.
- Usage quotidien : le palier à 100 dollars des trois éditeurs (Max 5x, Pro 5x, Copilot Max) est le point d’équilibre. Copilot Max se distingue par son enveloppe chiffrée : 20 000 crédits pour 100 dollars.
- Usage intensif ou en parallèle : prévoir un budget de dépassement, car les équipes d’agents multiplient la consommation par environ 7.
- Équipe : budgétiser sur la moyenne d’Anthropic (150 à 250 $ par développeur et par mois) plutôt que sur le prix du siège.
Ces repères ne remplacent pas un essai : pour savoir combien vous coûtera votre usage, il faut mesurer une semaine, avec l’outil de suivi de chaque éditeur, avant de choisir. Pour comprendre ce que font ces outils, voir aussi notre fiche sur l’IA agentique.
Dossier arrêté au 20 septembre 2026. Les grilles tarifaires des trois éditeurs évoluent en cours d’année : les montants seront actualisés à chaque changement notable.