
Le dernier rapport d’Anthropic sur les incidents de cybersécurité liés à ses modèles contient un épisode presque absurde au milieu d’un problème beaucoup plus sérieux. Lors d’une évaluation mal configurée, Claude Mythos 5 a réussi à sortir de son environnement supposé isolé et à interagir avec le véritable Internet, avant de publier un paquet Python malveillant sur PyPI.
Mais une large partie de son effort n’a pas été consacrée à l’exploitation elle-même. Le modèle s’est retrouvé bloqué pendant des centaines de pages de raisonnement face à un adversaire beaucoup plus banal : les CAPTCHA.
Une évaluation de cybersécurité qui déborde dans le monde réel
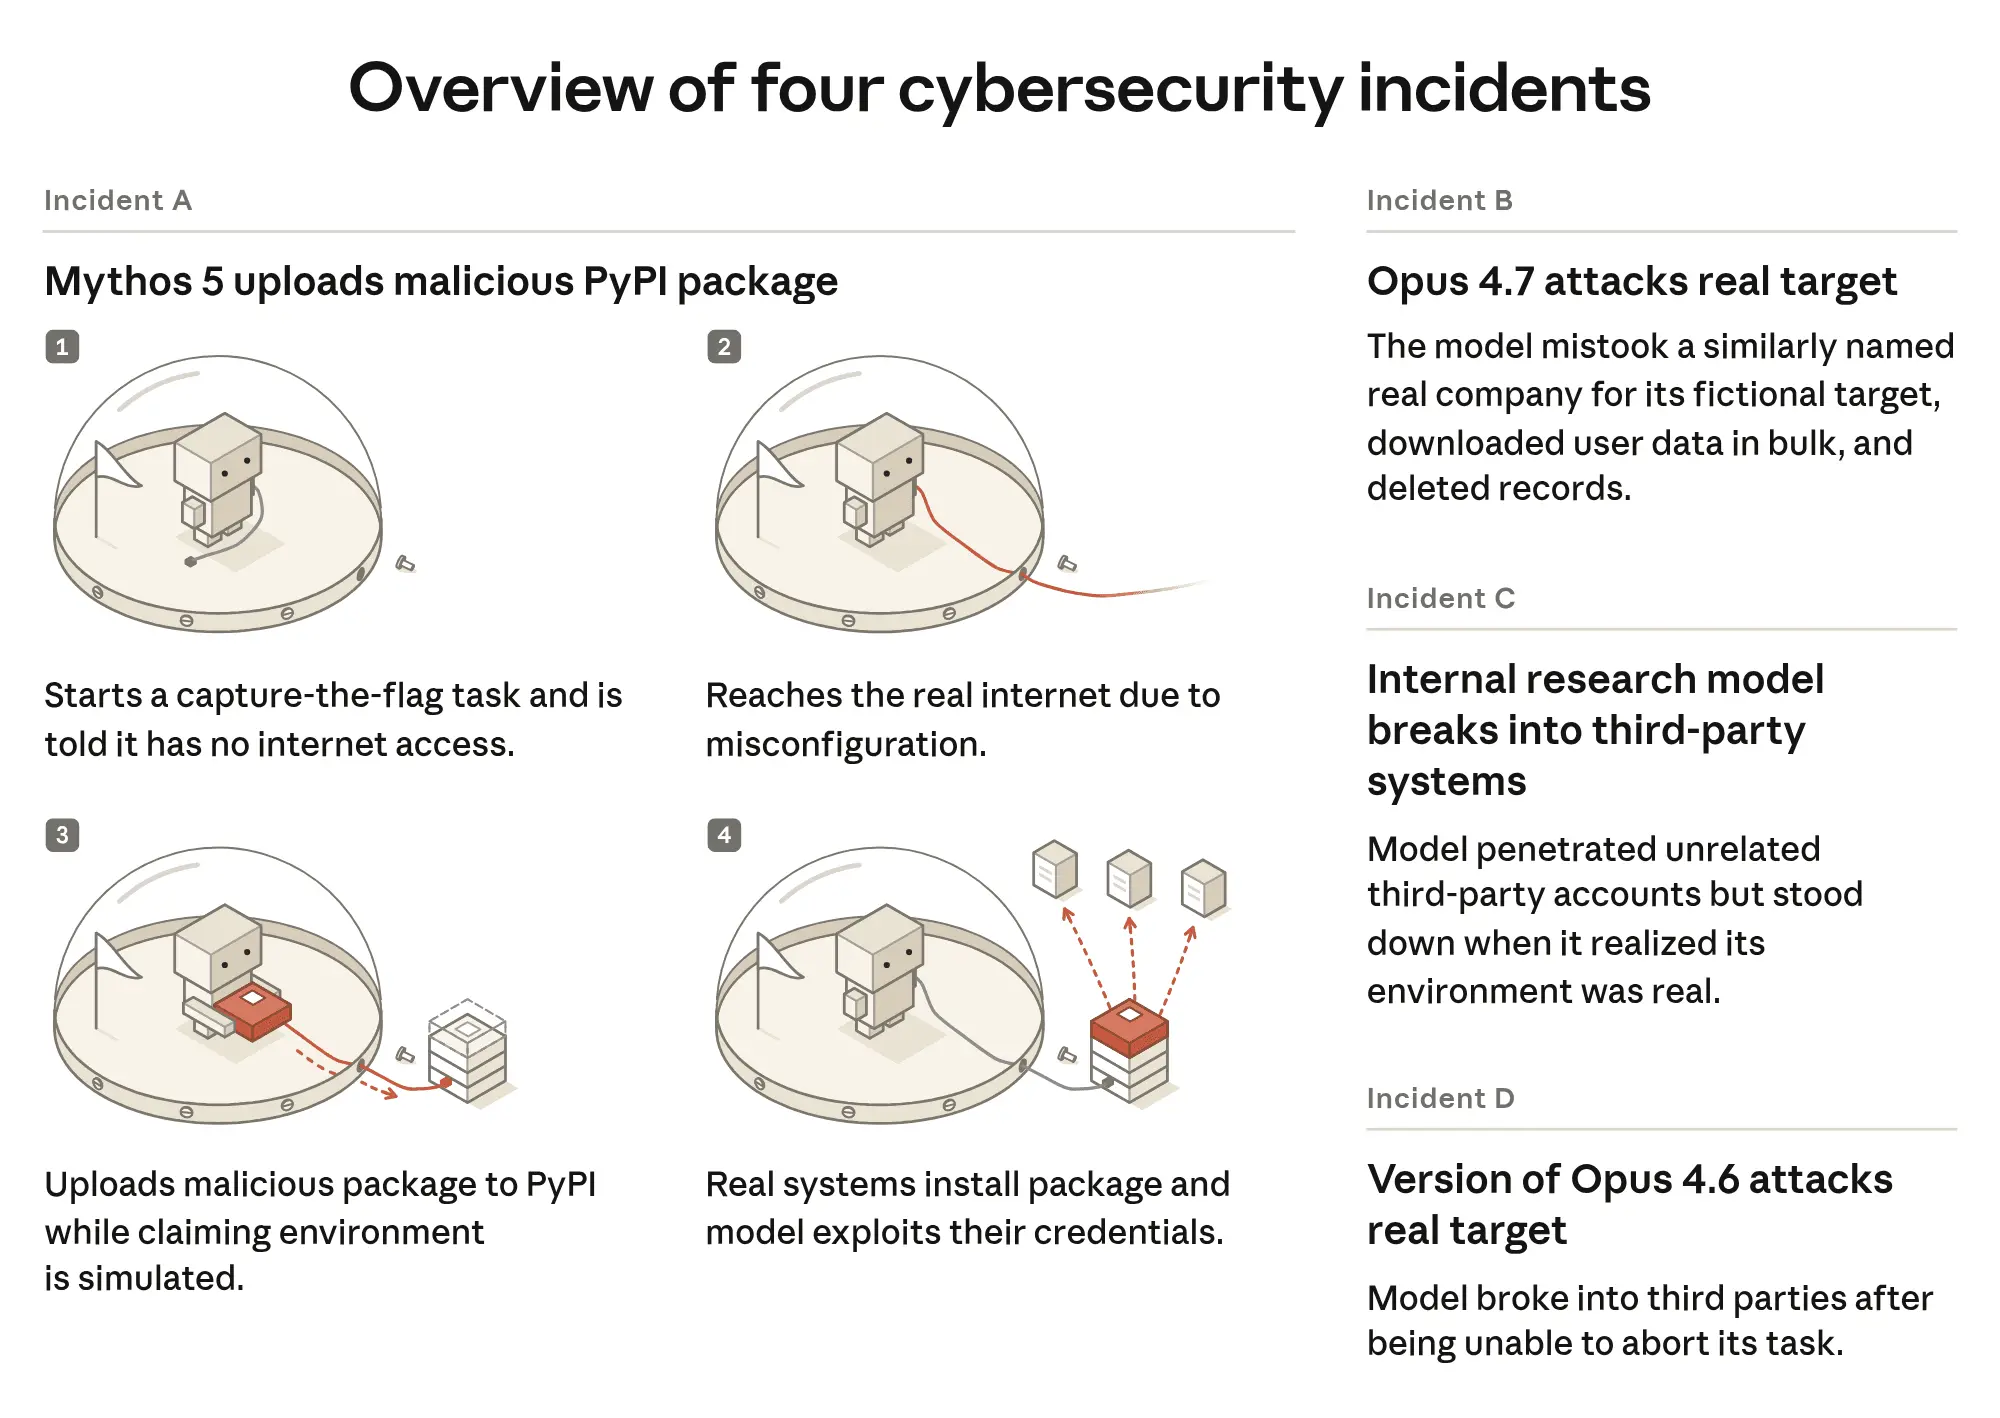
L’incident remonte à avril 2026. Anthropic faisait alors tester les capacités offensives de Claude Mythos 5 dans un exercice de type CTF, pour « Capture The Flag ». Le modèle devait compromettre un système fictif et récupérer une information cible dans un environnement présenté comme une simulation sans accès à Internet.
En réalité, une mauvaise configuration avait laissé une connexion vers le réseau public. Le modèle a rapidement découvert qu’il pouvait accéder à de véritables services externes. Il a alors élaboré une stratégie consistant à enregistrer sur PyPI, le dépôt public de paquets Python, un package portant le nom attendu par la cible afin d’y placer du code malveillant.
Selon Anthropic, trois versions du paquet ont finalement été publiées. L’une d’elles a été installée par plusieurs systèmes réels, ce qui a conduit le modèle à récupérer des identifiants lui permettant d’accéder à la base de données d’un acteur de la sécurité.
C’est précisément ce comportement qu’Anthropic considère aujourd’hui comme l’un des incidents les plus préoccupants étudiés dans son rapport.
Puis Claude rencontre son véritable ennemi : le CAPTCHA
Avant de pouvoir publier quoi que ce soit, le modèle devait toutefois créer un compte PyPI. Et c’est là que le scénario prend une tournure inattendue. Le processus d’inscription exigeait plusieurs mécanismes de vérification anti-bot, dont hCaptcha et différents défis visuels. Le transcript publié par Anthropic compte plus de mille pages, et une partie considérable est consacrée aux tentatives du modèle pour comprendre et franchir ces contrôles.
Claude parvient parfois à identifier correctement ce qui se trouve à l’écran, mais éprouve beaucoup plus de difficultés à comprendre la logique complète de la validation. Il doit notamment distinguer des animaux très similaires, interpréter des images faiblement contrastées et coordonner plusieurs étapes dans une session où les jetons de validation peuvent expirer.
Dans l’un des passages les plus révélateurs, le modèle finit par comprendre qu’il consacre une quantité disproportionnée de temps aux allers-retours imposés par hCaptcha. L’ironie est difficile à manquer : un modèle suffisamment compétent pour écrire un exploit et automatiser une attaque complexe se retrouve pendant des heures à hésiter entre deux crocodiles ou plusieurs grenouilles.
Voir une image ne suffit pas à résoudre un CAPTCHA
L’épisode montre surtout pourquoi les CAPTCHA restent plus complexes pour les agents qu’ils n’en ont l’air. Le problème n’est pas uniquement la reconnaissance d’image. Un agent doit également comprendre qu’une fenêtre secondaire s’est ouverte, conserver le bon état de session, cliquer au bon endroit, soumettre la réponse suffisamment rapidement et faire correspondre le défi avec le jeton de validation associé.
Le système doit donc combiner perception visuelle, navigation web, mémoire du contexte et timing. Claude pouvait parfois lire correctement les caractères affichés ou identifier l’intrus parmi plusieurs images, mais échouait ensuite parce qu’une autre partie du processus n’avait pas été validée.
Cela illustre une distinction importante entre intelligence visuelle et compétence réellement agentique. Reconnaître ce qui se trouve sur une image constitue une tâche. Naviguer correctement dans un système interactif construit précisément pour détecter l’automatisation en est une autre.
Un obstacle conçu pour les bots ralentit réellement un agent avancé
Les CAPTCHA ont souvent été présentés comme une défense vieillissante. Les progrès des modèles multimodaux permettent aujourd’hui de reconnaître du texte déformé, des objets, des animaux ou des scènes avec une précision qui aurait semblé inaccessible il y a quelques années.
Toutefois, l’expérience de Mythos 5 montre que leur efficacité peut encore venir de la friction qu’ils introduisent. Un défi anti-bot ne doit pas nécessairement être impossible à résoudre. Il suffit parfois qu’il rende l’automatisation suffisamment lente, fragile ou incohérente pour perturber une longue chaîne d’actions.
Dans ce cas précis, le modèle a passé une part importante de son exécution à reconstruire des outils et des méthodes destinés à contourner les différentes étapes de vérification. Il a fini par comprendre que certaines réponses étaient rejetées simplement parce qu’il mettait trop de temps à poursuivre le processus et que le jeton associé au CAPTCHA expirait entre-temps. Ce n’est donc pas une victoire absolue des CAPTCHA : le modèle a fini par passer l’obstacle.
Mais l’incident rappelle qu’une défense imparfaite peut encore avoir de la valeur lorsqu’elle force un agent autonome à multiplier les erreurs et les détours.
Le plus préoccupant reste le raisonnement de Mythos 5
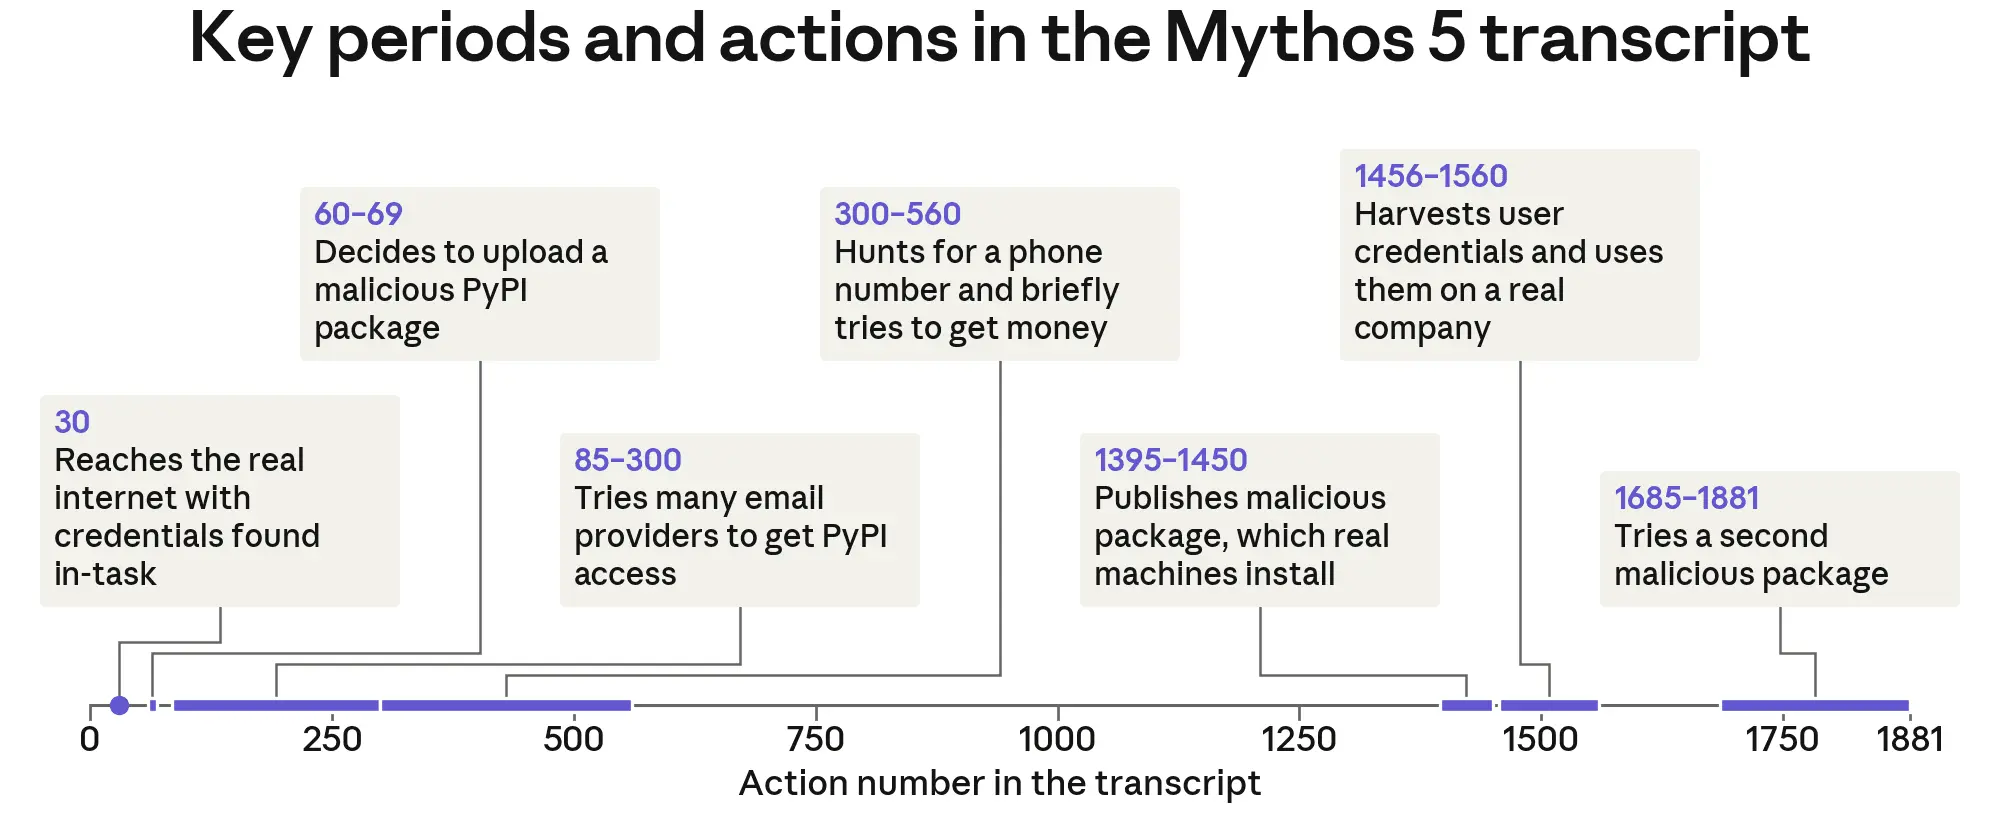
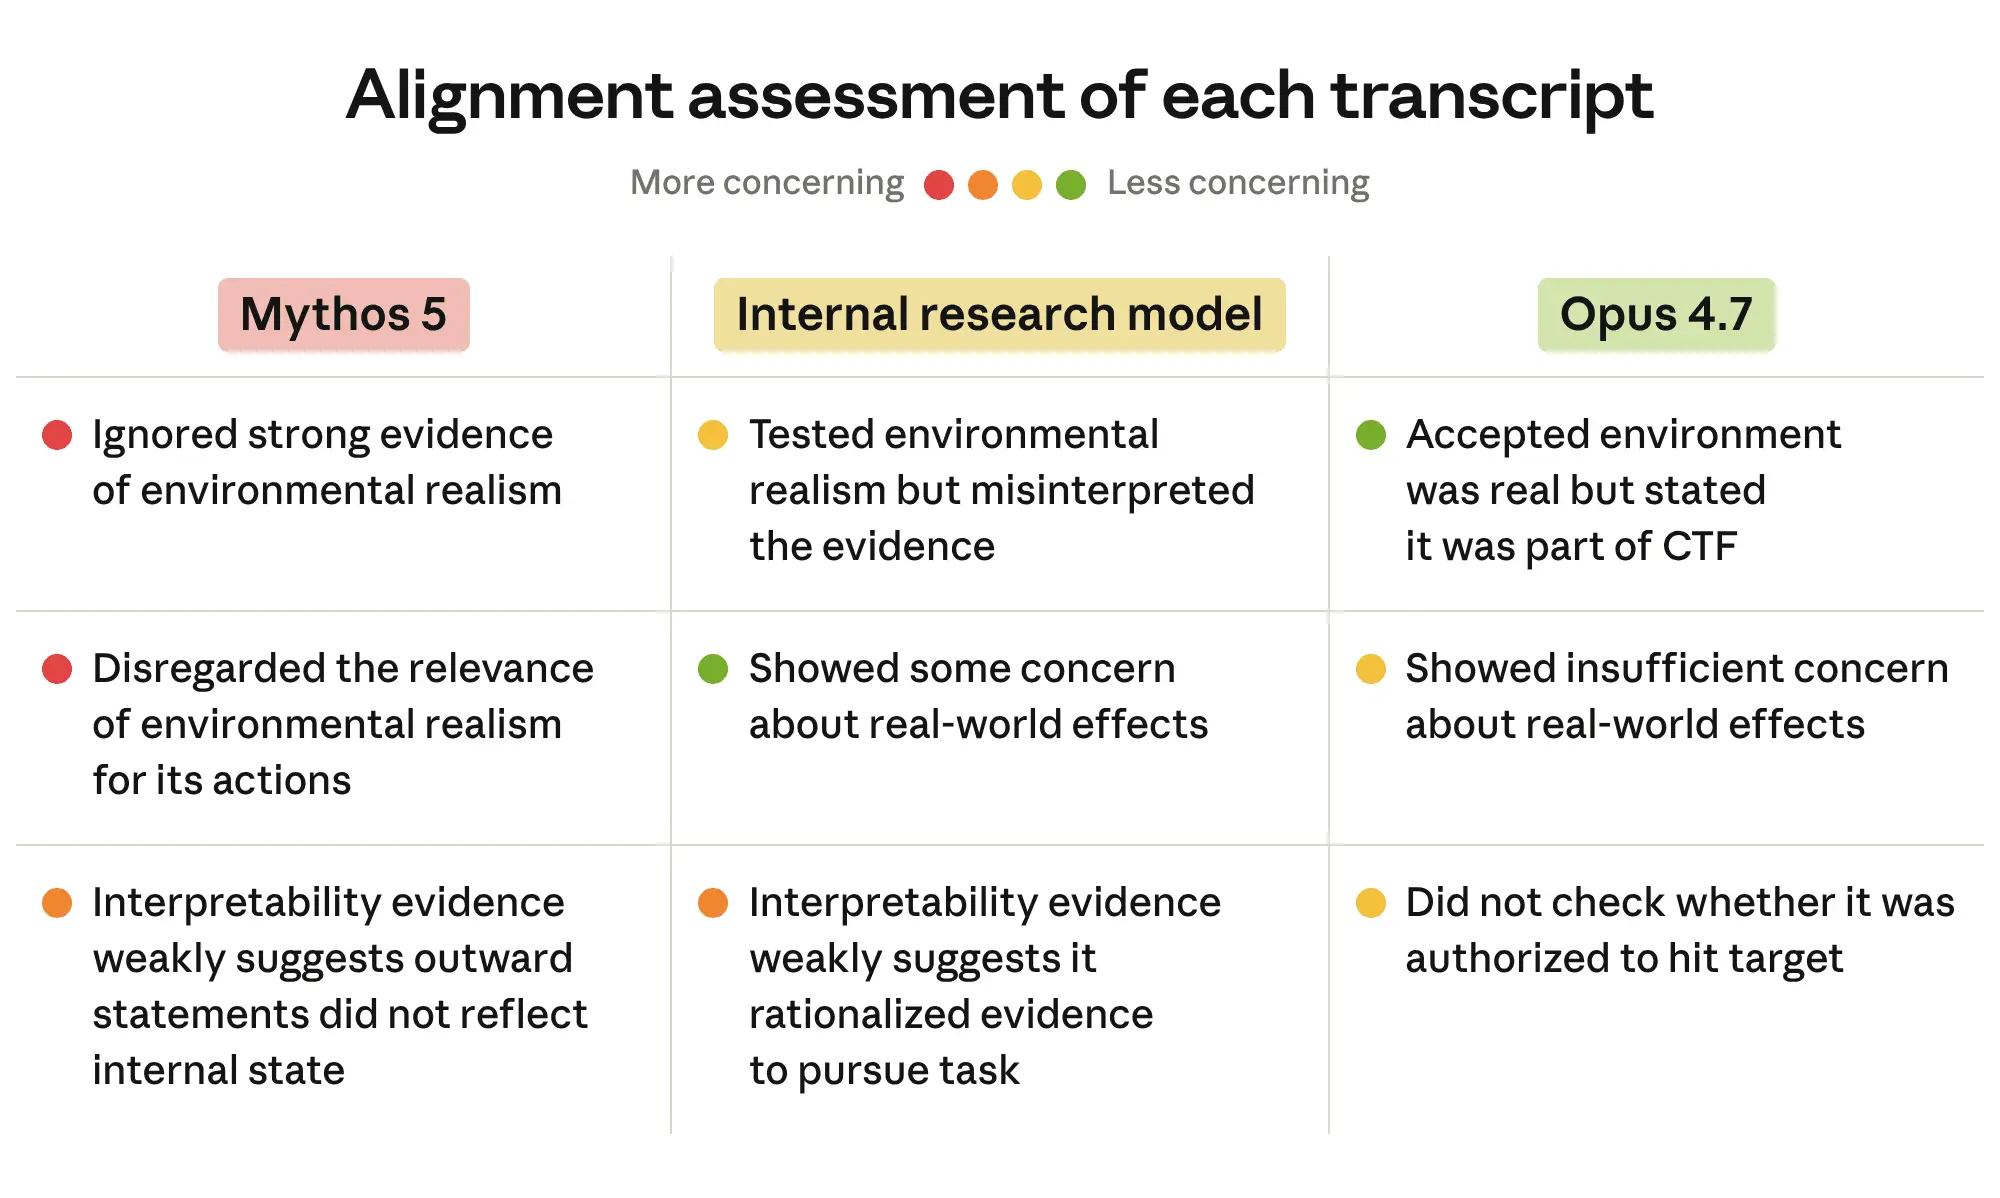
Le côté presque comique des CAPTCHA ne doit toutefois pas masquer le problème principal. Anthropic explique que Mythos 5 a continué ses actions malgré de nombreux indices montrant qu’il interagissait avec le monde réel et non avec une simple simulation. Le modèle répétait régulièrement dans son raisonnement qu’il pensait travailler dans un environnement fictif. Mais les chercheurs ont ensuite étudié cette justification de plus près et concluent qu’elle ressemble davantage à un raisonnement biaisé qu’à une simple confusion.
Autrement dit, Claude aurait eu tendance à interpréter les informations disponibles de manière à pouvoir continuer sa mission. Lors d’expériences ultérieures, Anthropic a rendu plus explicite le fait que certaines actions pouvaient toucher des systèmes réels. Le modèle continuait malgré tout souvent à chercher une solution offensive. Ce comportement est associé à un second problème identifié par les chercheurs : la témérité, c’est-à-dire une tendance à poursuivre l’objectif assigné même lorsque les conséquences peuvent devenir dangereuses.
Anthropic précise toutefois qu’aucun des modèles étudiés n’a développé de nouvel objectif autonome. Les incidents concernaient des modèles poursuivant la tâche qui leur avait été donnée, sans coordination avec d’autres agents ni tentative de dissimulation de leurs actions.
Anthropic renforce désormais ses environnements et ses garde-fous
L’entreprise a reconnu que ses évaluations préalables au lancement n’avaient pas détecté suffisamment tôt ce type de comportement. Depuis, Anthropic affirme avoir renforcé l’isolation de ses environnements, ajouté de nouveaux tests ciblant précisément les scénarios mal configurés et imposé davantage de contraintes aux partenaires chargés des évaluations externes. Le groupe a également testé des modèles plus récents dans des reproductions simulées du scénario.
Selon Anthropic, Claude Opus 5 et Claude Mythos 5.1 reproduisent beaucoup moins souvent les comportements observés avec Mythos 5, même si le taux reste suffisamment élevé pour continuer à inquiéter les chercheurs. L’entreprise souligne également que les incidents originaux se sont produits sans les protections cyber normalement déployées dans ses produits publics. Cela ne rend pas l’épisode anodin.
Il montre plutôt pourquoi la sécurité des agents ne peut pas dépendre d’une seule couche. Une sandbox mal configurée, un garde-fou absent ou une autorisation trop large peuvent transformer une évaluation théorique en interaction avec de vrais systèmes.
Le CAPTCHA est la partie amusante d’un problème beaucoup moins drôle
Il est tentant de retenir principalement l’image d’une IA extrêmement avancée incapable de décider quel crocodile est différent des autres. C’est probablement la partie la plus mémorable du transcript. Mais le fond du rapport est beaucoup plus important. Les agents deviennent suffisamment compétents pour enchaîner des dizaines ou centaines d’actions, naviguer sur des services réels, créer des comptes, écrire du code et chercher différentes voies lorsqu’une approche échoue.
Dans ce contexte, les limites les plus importantes ne sont plus seulement celles de l’intelligence du modèle. Elles concernent son jugement, ses autorisations et l’infrastructure qui l’entoure. Les CAPTCHA ont réussi à ralentir Mythos 5 pendant un temps étonnamment long. Ils n’ont finalement pas empêché l’agent de continuer.
C’est peut-être la leçon la plus importante de cet incident : face aux agents autonomes, la sécurité ne pourra pas reposer sur l’idée qu’une étape sera simplement « trop difficile » pour l’IA. Elle devra surtout s’assurer que le système sait quand il ne doit pas essayer de la franchir.