
Qwen poursuit son offensive dans l’IA générative avec Qwen-Image-2.1, un nouveau modèle capable de réunir génération et édition d’images au sein d’une même architecture. Sa particularité ne tient pas seulement à son composant visuel de 7 milliards de paramètres : il peut également produire et modifier nativement des images transparentes, exploiter jusqu’à dix références et intervenir précisément sur plusieurs zones d’une composition.
Disponible avec des poids ouverts, Qwen-Image-2.1 cherche surtout à trouver un équilibre entre qualité visuelle, vitesse d’inférence et coût de calcul. Une approche qui pourrait le rendre particulièrement intéressant pour les workflows créatifs locaux ou personnalisés, là où les modèles d’image les plus puissants restent souvent accessibles uniquement à travers des services propriétaires.
Un modèle de 7 milliards de paramètres pensé pour rester relativement léger
Qwen-Image-2.1 repose sur une architecture comprenant 32 couches Single-Stream DiT, avec un composant de génération visuelle de 7 milliards de paramètres. Ce choix permet à Qwen de viser une architecture relativement compacte sans renoncer à des capacités avancées de génération et d’édition. Le groupe met notamment en avant ses résultats sur Qwen-Image-Bench, son benchmark comparant le modèle à différentes solutions ouvertes et propriétaires.
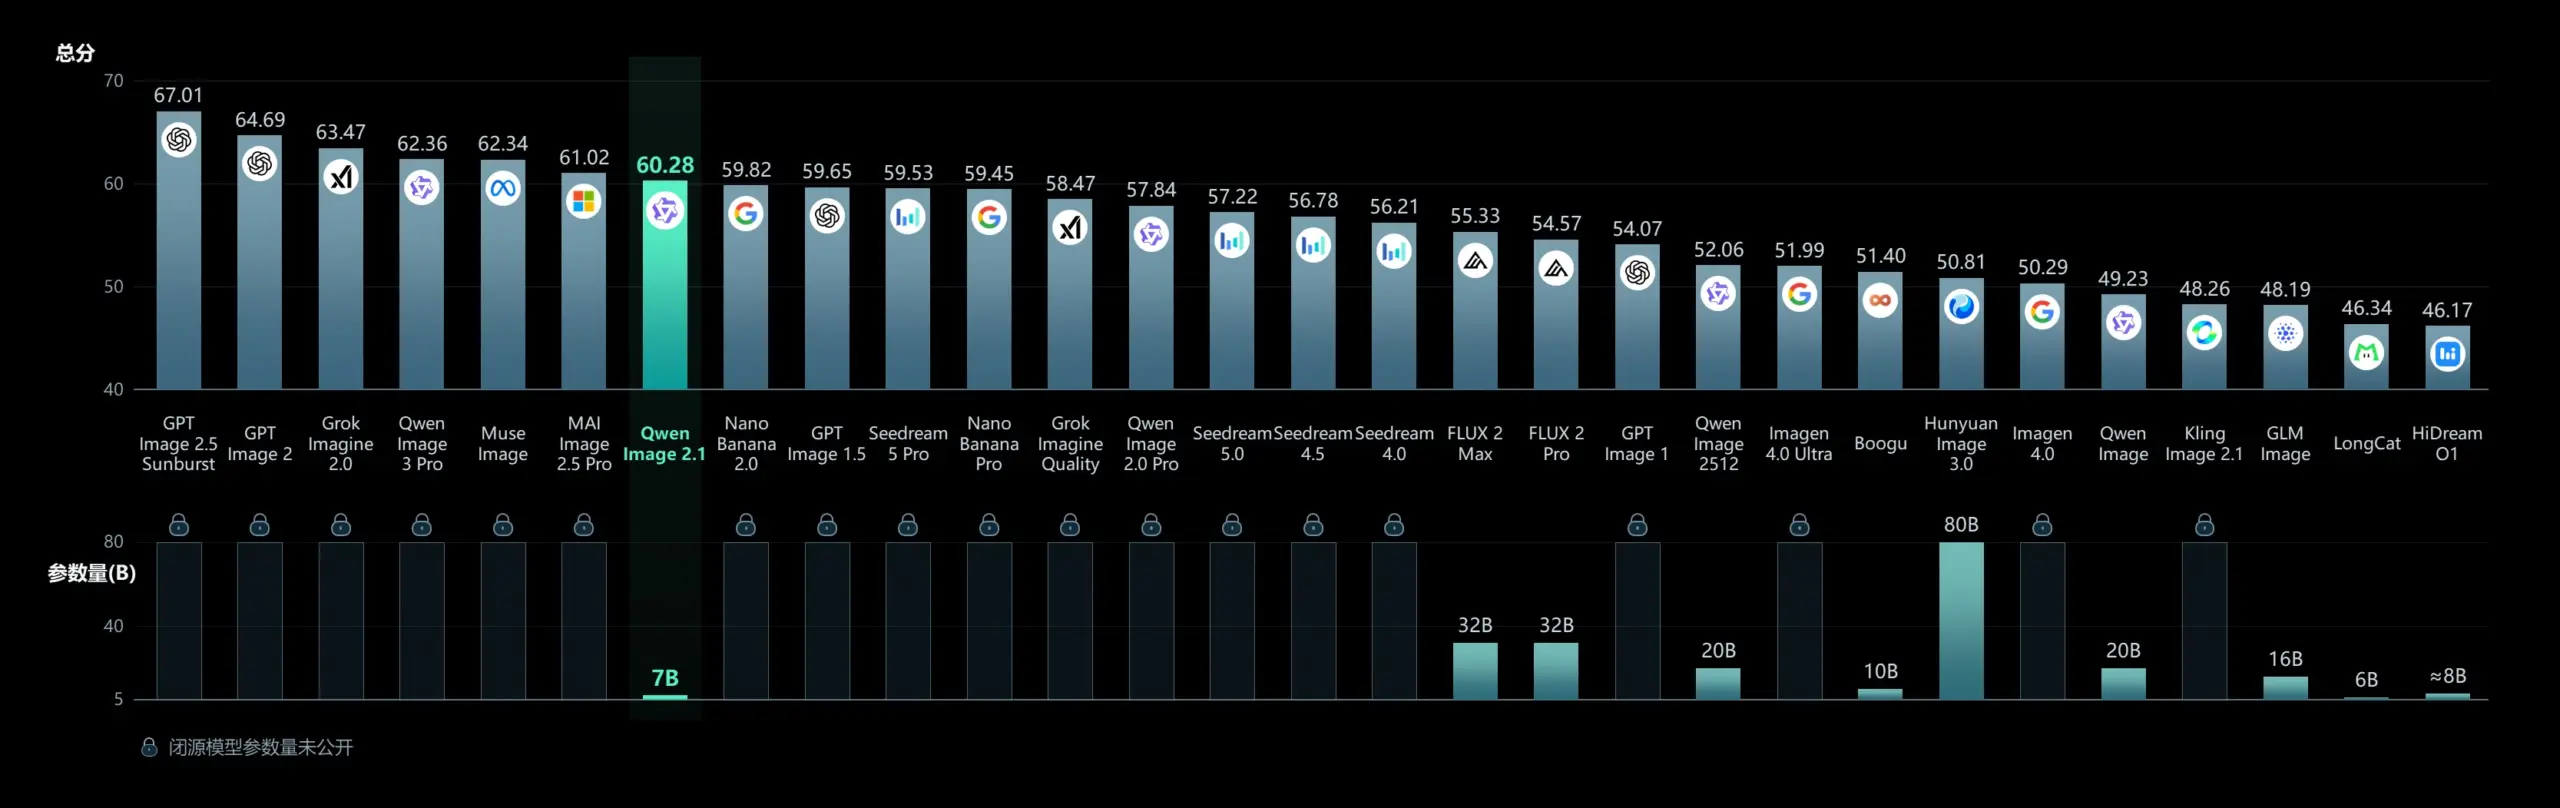
Ces performances devront naturellement être confrontées à des évaluations indépendantes. L’intérêt de Qwen-Image-2.1 réside néanmoins autant dans son efficacité que dans la qualité brute des images produites.
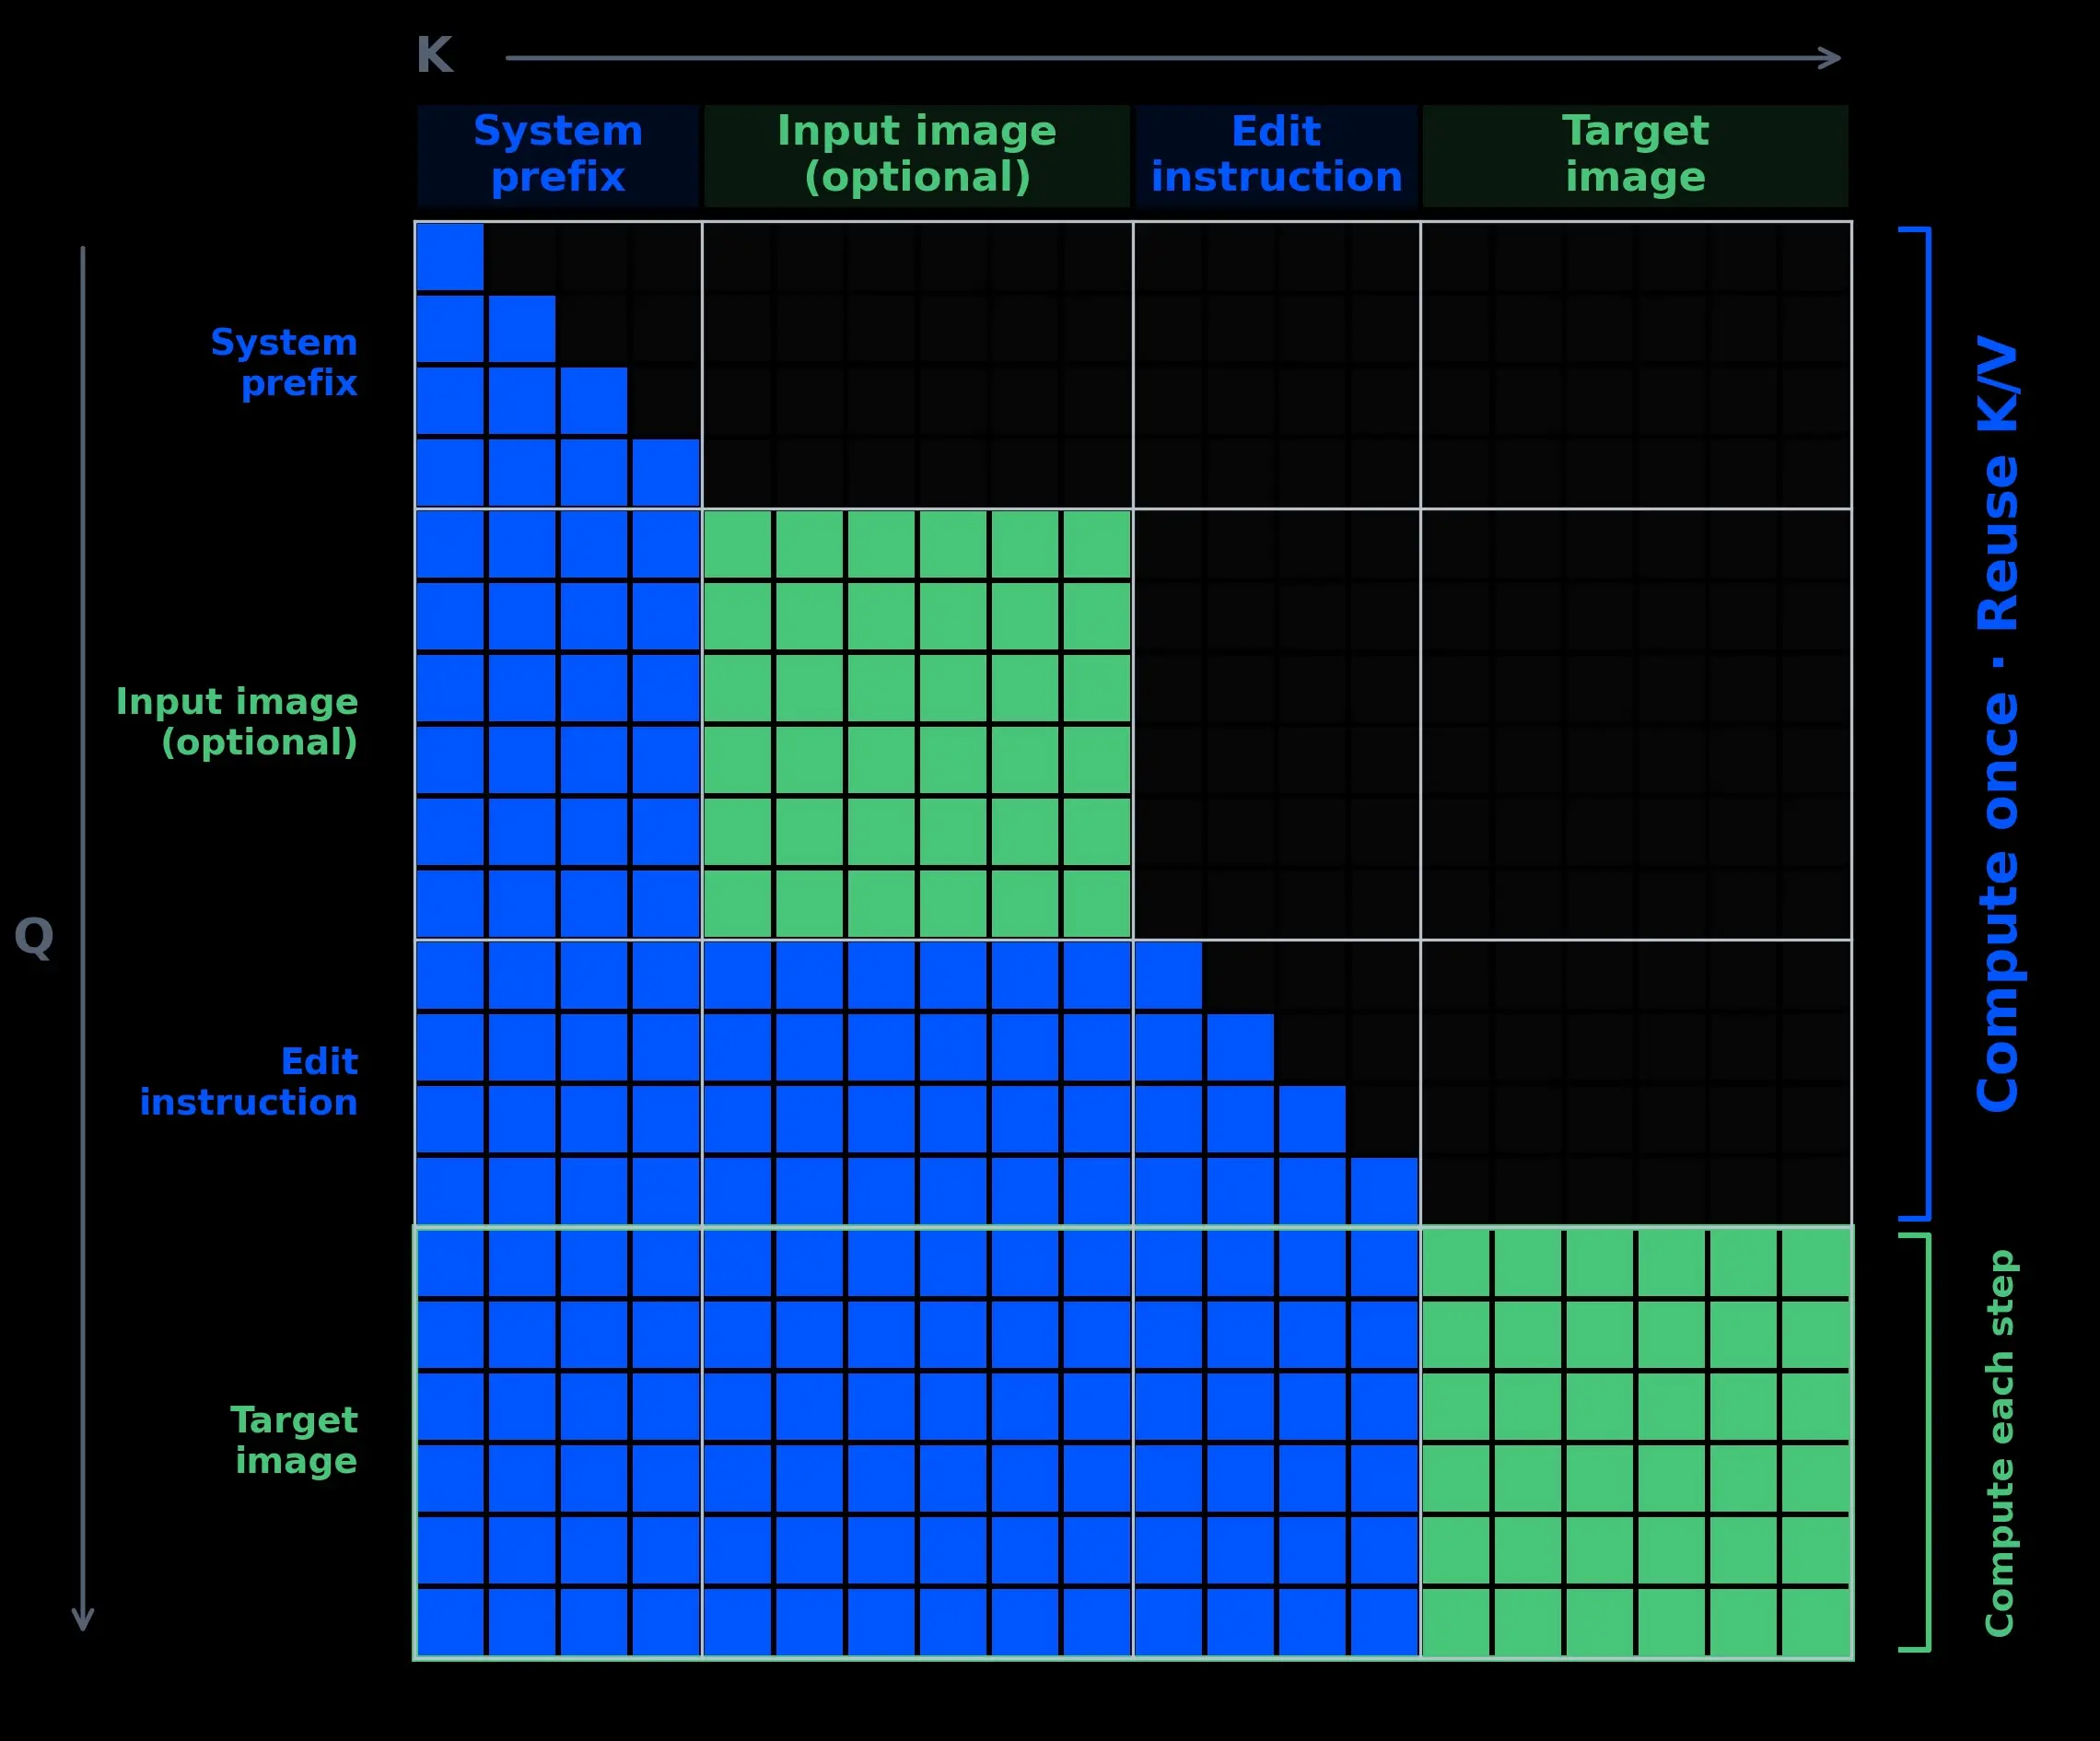
Pour l’édition reposant sur plusieurs images, Qwen utilise notamment une architecture d’attention à granularité mixte. Le modèle applique différents mécanismes aux instructions textuelles et aux éléments visuels afin d’éviter de recalculer inutilement certaines informations pendant chaque étape de génération.
Il peut notamment réutiliser le cache KV des images d’entrée et des instructions d’édition, tandis qu’une partie du contexte statique est calculée puis mise en cache dès la première étape. L’objectif est de réduire à la fois les besoins en mémoire et le coût de l’inférence, un enjeu particulièrement important lorsque plusieurs références visuelles sont utilisées simultanément.
La transparence devient une fonction native du modèle
L’une des nouveautés les plus intéressantes concerne la gestion de la transparence. Qwen avait déjà présenté Qwen-Image-Layered en décembre 2025, un modèle spécifiquement conçu autour de la génération d’images transparentes. Qwen-Image-2.1 intègre désormais directement cette capacité à son moteur de génération et d’édition.
Le modèle peut déterminer à partir du prompt s’il doit produire une image RGB classique ou une image intégrant un canal alpha pour la transparence. Il devient ainsi possible de générer directement des objets ou personnages détourés plutôt que de créer d’abord une image avec un fond avant de passer par une seconde étape de suppression.
Qwen-Image-2.1 peut également modifier une image transparente tout en préservant son arrière-plan, y compris lorsque l’édition porte sur du texte présent dans les différents éléments.
Le fonctionnement inverse est également prévu. Le modèle peut extraire un sujet depuis une photographie RGB classique afin de le convertir en élément RGBA transparent, puis réutiliser ce sujet dans une nouvelle composition.
Cette capacité peut paraître moins spectaculaire qu’une amélioration de la qualité photoréaliste, mais elle possède une valeur pratique considérable. Dans les workflows graphiques, publicitaires ou e-commerce, détourer un produit ou préparer différents éléments avant de les assembler représente une partie importante du travail. L’intégration native de cette étape rapproche davantage le modèle d’un outil de production que d’un simple générateur d’images.
Jusqu’à dix images de référence et des retouches beaucoup plus localisées
Qwen-Image-2.1 renforce également son utilisation des images de référence. Le modèle peut en accepter jusqu’à dix simultanément afin de construire une nouvelle composition à partir de plusieurs personnes, objets ou éléments visuels. Qwen montre par exemple une photographie de groupe produite à partir de six portraits différents, une composition d’essayage virtuel utilisant cinq entrées ou encore un intérieur construit à partir de dix références de mobilier.
La capacité à maintenir la cohérence de plusieurs éléments devient ici essentielle. Un générateur peut facilement reproduire l’idée générale d’un produit ou d’un visage tout en modifiant involontairement certains détails. Or, dans un workflow professionnel, changer un logo, une texture, une forme ou les traits d’une personne peut rendre le résultat inutilisable.
Qwen affirme justement avoir travaillé sur cette fidélité. Pour les portraits, Qwen-Image-2.1 cherche à préserver les caractéristiques du visage au fil des transformations. Pour les produits, le modèle tente de conserver le texte, les textures, la géométrie et les éléments distinctifs de l’objet d’origine.
L’édition locale devient elle aussi plus précise. L’utilisateur peut entourer différentes zones avec des cercles colorés, peindre directement une annotation sur la partie à modifier ou fournir séparément un masque avec l’image originale.
Plusieurs zones peuvent recevoir des instructions différentes au cours d’une même opération. Et lorsque les annotations risquent de masquer des informations utiles au modèle, l’utilisation d’un masque séparé permet de conserver intacte l’image servant de référence.
Texte, panoramas et storyboards : Qwen vise des usages de production
Le modèle ne se limite pas à la retouche photographique traditionnelle. Qwen-Image-2.1 peut notamment étendre une photographie pour créer un panorama, transformer une photo de produit ou de modèle en infographie et utiliser différentes vues d’un personnage comme base pour générer un storyboard complet.
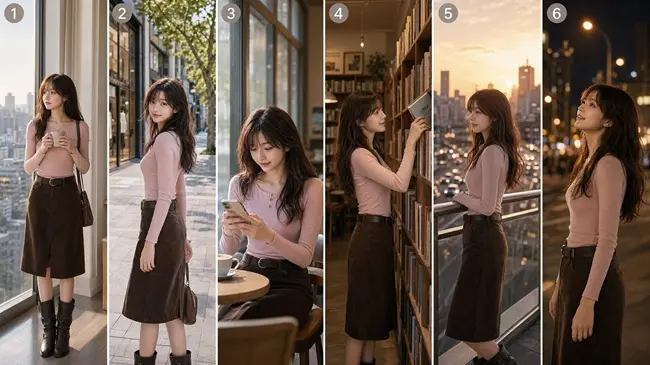
Les éditions successives peuvent également conserver les parties non modifiées d’une scène. Cette stabilité permet d’assembler plusieurs images légèrement différentes afin de construire des animations simples sans devoir régénérer intégralement la composition à chaque étape.
Le rendu du texte fait lui aussi l’objet d’améliorations. Qwen indique que son modèle prend davantage en considération non seulement les caractères à afficher, mais aussi la typographie, leur disposition et leur relation avec le reste de la composition.
C’est un domaine particulièrement important pour les modèles génératifs. Produire une belle illustration est une chose ; générer une affiche, une publicité ou une infographie contenant du texte correctement écrit et positionné en est une autre. Une meilleure compréhension de la typographie rapproche donc encore Qwen-Image-2.1 des usages de design et de communication.
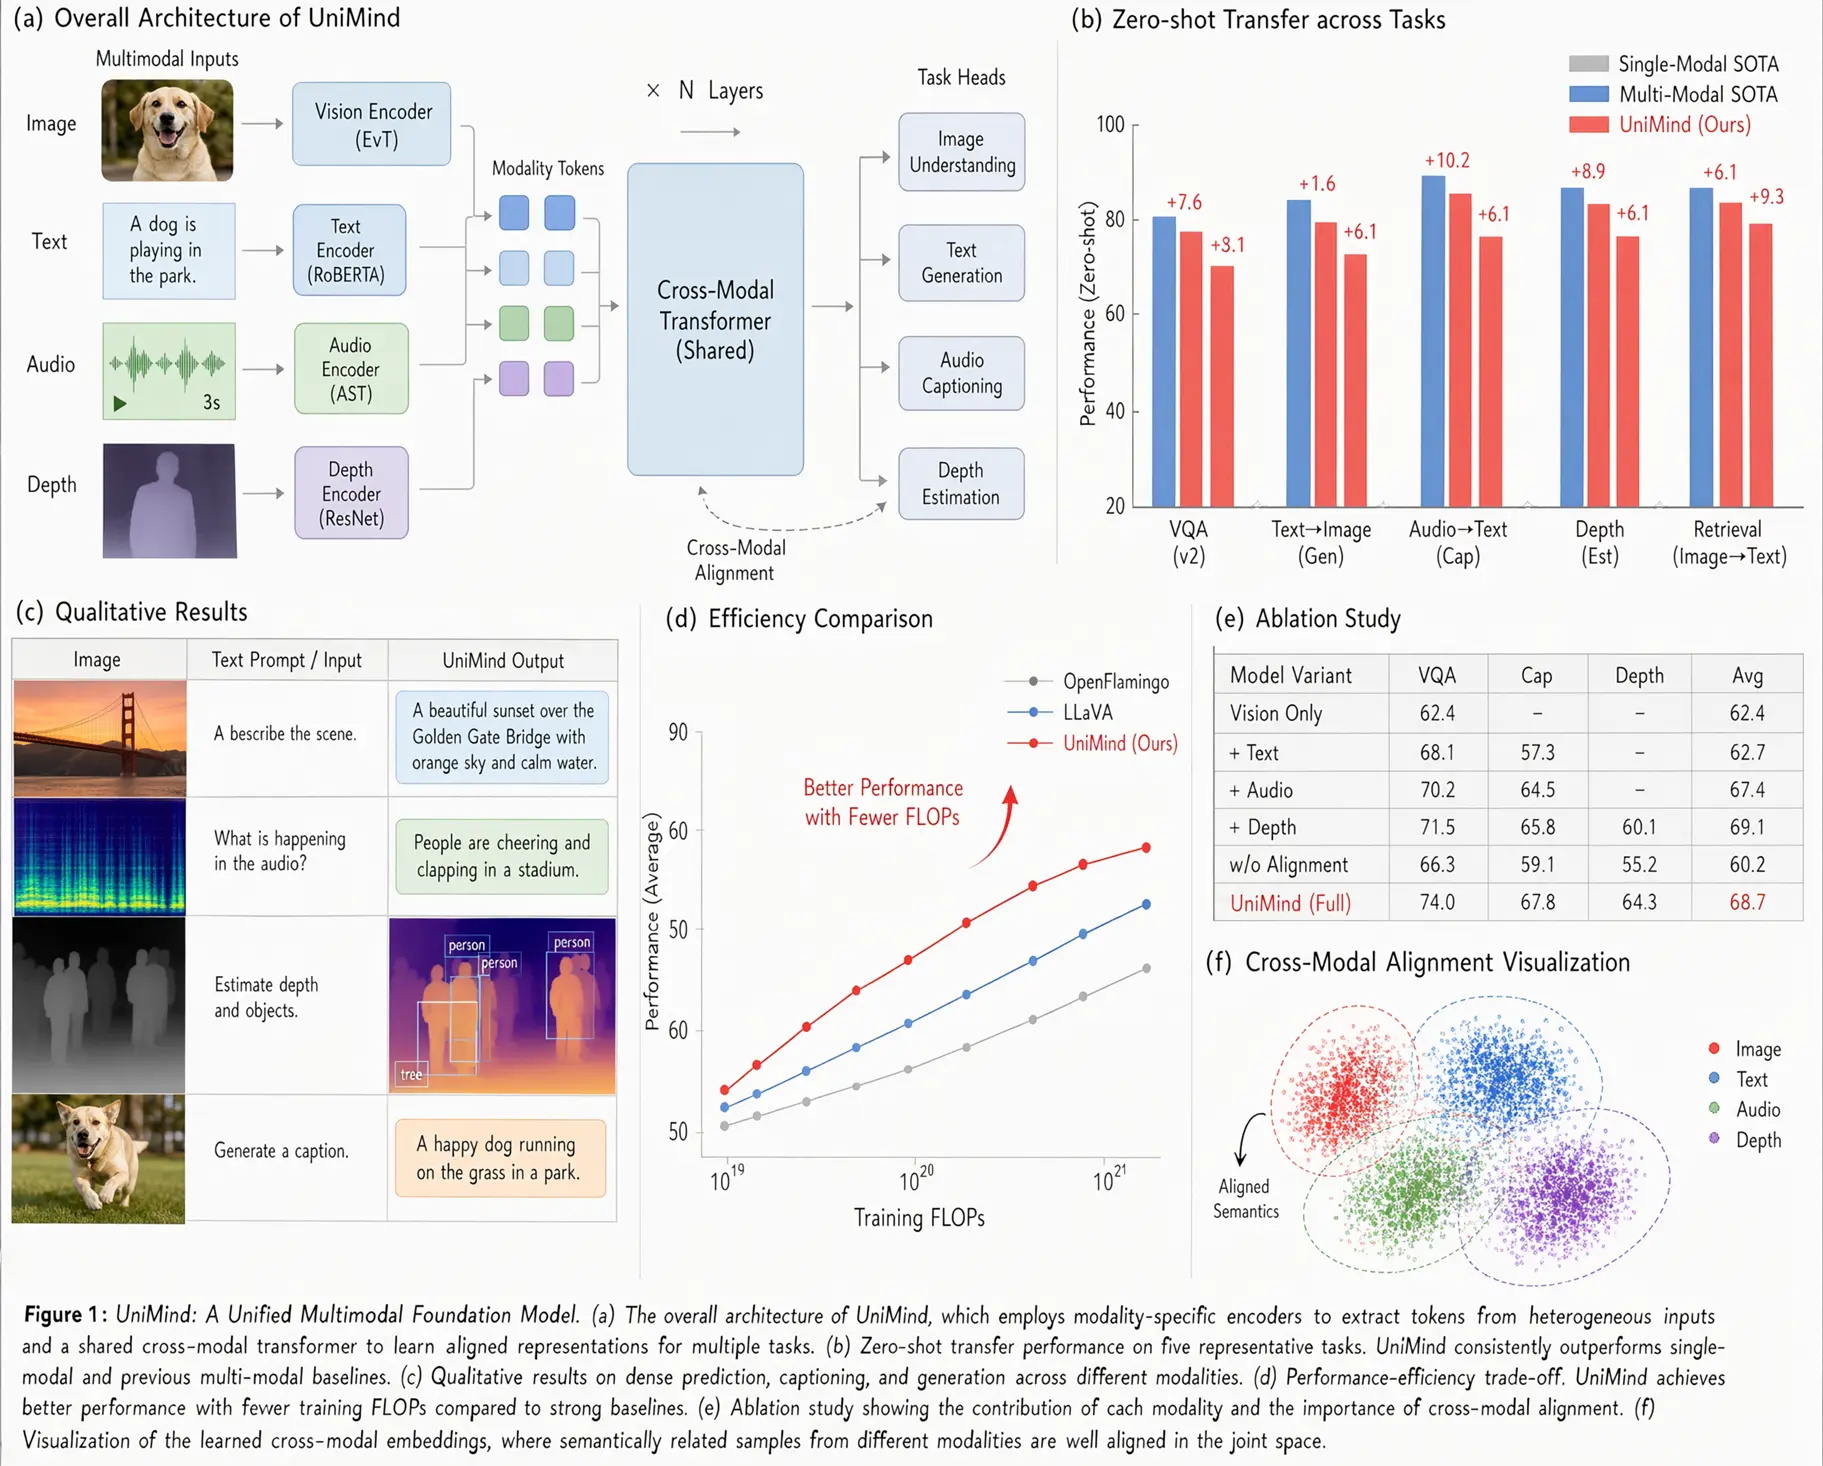
Les portraits bénéficient parallèlement d’un travail supplémentaire sur l’éclairage et les détails fins, deux éléments déterminants lorsqu’il s’agit de préserver l’identité d’une personne au fil de plusieurs modifications.
Qwen cherche à réunir plusieurs outils créatifs dans un seul modèle
La stratégie derrière Qwen-Image-2.1 est finalement plus intéressante que chacune de ses fonctions prise séparément. Pendant longtemps, les workflows d’IA visuelle ont reposé sur une succession de modèles spécialisés : un premier pour générer une image, un autre pour la modifier, un outil de segmentation pour détourer le sujet et éventuellement d’autres modèles pour préserver un visage ou effectuer une retouche locale.
Qwen tente ici de réunir une grande partie de ces opérations dans une seule architecture. La génération, l’édition, l’utilisation de plusieurs références, le détourage avec transparence et les modifications locales peuvent ainsi s’enchaîner sans changer constamment de modèle. Cette unification peut réduire les frictions, mais également améliorer la cohérence lorsque le même élément doit être conservé à travers plusieurs étapes d’un projet.
L’autre enjeu concerne évidemment l’ouverture du modèle. Qwen-Image-2.1 est disponible avec ses poids ouverts, ce qui permet aux développeurs et chercheurs de l’intégrer à leurs propres environnements plutôt que de dépendre exclusivement d’une interface cloud. Le modèle peut également être testé directement dans Qwen Studio pour ceux qui ne souhaitent pas le déployer eux-mêmes.
Cette combinaison entre architecture relativement compacte et poids accessibles pourrait être particulièrement importante. Dans l’image générative, la compétition ne porte plus seulement sur celui qui produit le résultat le plus spectaculaire à partir d’un prompt : elle concerne également le coût d’exploitation, la personnalisation et la possibilité d’intégrer le modèle à une véritable chaîne de production.
L’IA générative passe progressivement de l’image au workflow
Qwen-Image-2.1 illustre ainsi une évolution plus large des modèles visuels. Les premières générations étaient essentiellement jugées sur leur capacité à transformer quelques lignes de texte en une belle image. Les nouveaux modèles doivent désormais comprendre des références, préserver l’identité d’un sujet, modifier uniquement certaines zones, respecter du texte et produire des éléments immédiatement réutilisables dans des outils graphiques.
La transparence native est particulièrement représentative de ce changement. Elle ne rend pas nécessairement une démonstration plus impressionnante, mais elle élimine une étape entière d’un workflow de création.
Même logique pour la prise en charge de dix références ou l’édition locale par masque : l’objectif n’est plus simplement de générer, mais de donner suffisamment de contrôle pour que l’utilisateur puisse construire progressivement un résultat précis.
Qwen-Image-2.1 montre ainsi où se déplace la bataille de l’image générative : après avoir appris à créer des images convaincantes, les modèles doivent maintenant apprendre à respecter les éléments qu’on leur confie. Pour les créateurs, la prochaine avancée décisive pourrait moins venir d’une image encore plus spectaculaire que d’une IA enfin capable de s’intégrer proprement dans tout le processus de création.