
Meta expérimente une approche inhabituelle pour obtenir les données dont ses futurs modèles ont besoin. Avec Muse Spark, son modèle destiné notamment aux agents de code et autres systèmes autonomes, l’entreprise propose une réduction spectaculaire de ses tarifs aux clients qui acceptent de partager leurs prompts et les réponses générées afin d’entraîner de prochaines versions.
L’écart est suffisamment important pour transformer le choix en véritable arbitrage économique. Là où la plupart des fournisseurs présentent le partage des données comme une option de confidentialité, Meta en fait presque une nouvelle classe tarifaire : vos données valent de l’argent, et l’entreprise est prête à le reconnaître directement sur la facture.
Jusqu’à 95 % de réduction en échange des prompts et des sorties
Le principe repose sur deux niveaux de tarification. Dans le cadre standard, un million de tokens en entrée coûte 1,25 dollar, tandis qu’un million de tokens en sortie est facturé 4,25 dollars. Pour les utilisateurs inscrits au programme « contributor », les mêmes volumes tombent respectivement à 0,10 dollar et 0,20 dollar.
La différence est considérable. Selon le type de charge de travail, l’économie moyenne approche les 95 %, ce qui peut changer radicalement le coût d’un prototype, d’un agent automatisé ou d’un déploiement à grande échelle. En contrepartie, Meta peut utiliser les prompts et résultats produits pour améliorer ses futurs modèles.
L’entreprise présente d’ailleurs explicitement cette formule comme un moyen de réduire le coût des expérimentations lorsque l’utilisation des données pour l’entraînement est acceptable.
Meta donne enfin un prix concret aux données d’usage
Cette tarification met en lumière quelque chose que l’industrie de l’IA préfère souvent laisser implicite : les conversations avec les modèles ont une valeur directe. Les prompts ne sont pas seulement des entrées permettant d’obtenir une réponse. Ils montrent comment les utilisateurs travaillent, quels problèmes ils essaient de résoudre, quelles erreurs les modèles commettent et quelles stratégies fonctionnent réellement dans des environnements concrets.
Pour des agents logiciels, ces traces deviennent particulièrement précieuses. Un échange complet peut montrer comment un système explore un dépôt de code, sélectionne des outils, modifie plusieurs fichiers, échoue, corrige son approche puis parvient au résultat attendu. Ce type de séquence fournit beaucoup plus d’informations qu’un simple couple question-réponse.
Avec son modèle tarifaire, Meta reconnaît directement cette valeur. Plutôt que de demander aux utilisateurs de contribuer gratuitement à l’amélioration du produit, l’entreprise réduit massivement le prix du service en échange.
Les agents IA ont particulièrement besoin de traces réelles
La question devient encore plus importante avec les agents. Les modèles conversationnels classiques peuvent être évalués à partir de nombreuses tâches relativement simples : répondre à une question, produire du code, résumer un document ou résoudre un problème mathématique.
Un agent doit gérer des séquences beaucoup plus longues. Il peut devoir naviguer entre plusieurs outils, vérifier des résultats intermédiaires, comprendre l’état d’un environnement et prendre une série de décisions avant d’arriver au résultat final.
Les développeurs ont donc besoin de données montrant non seulement si l’agent a réussi, mais comment il a travaillé. C’est l’une des raisons pour lesquelles les sessions de coding agents sont devenues si importantes pour l’entraînement par renforcement et l’amélioration des modèles.
Lorsque des milliers d’utilisateurs emploient quotidiennement un agent dans des environnements réels, chaque session peut devenir un exemple de comportement réussi, imparfait ou complètement erroné.
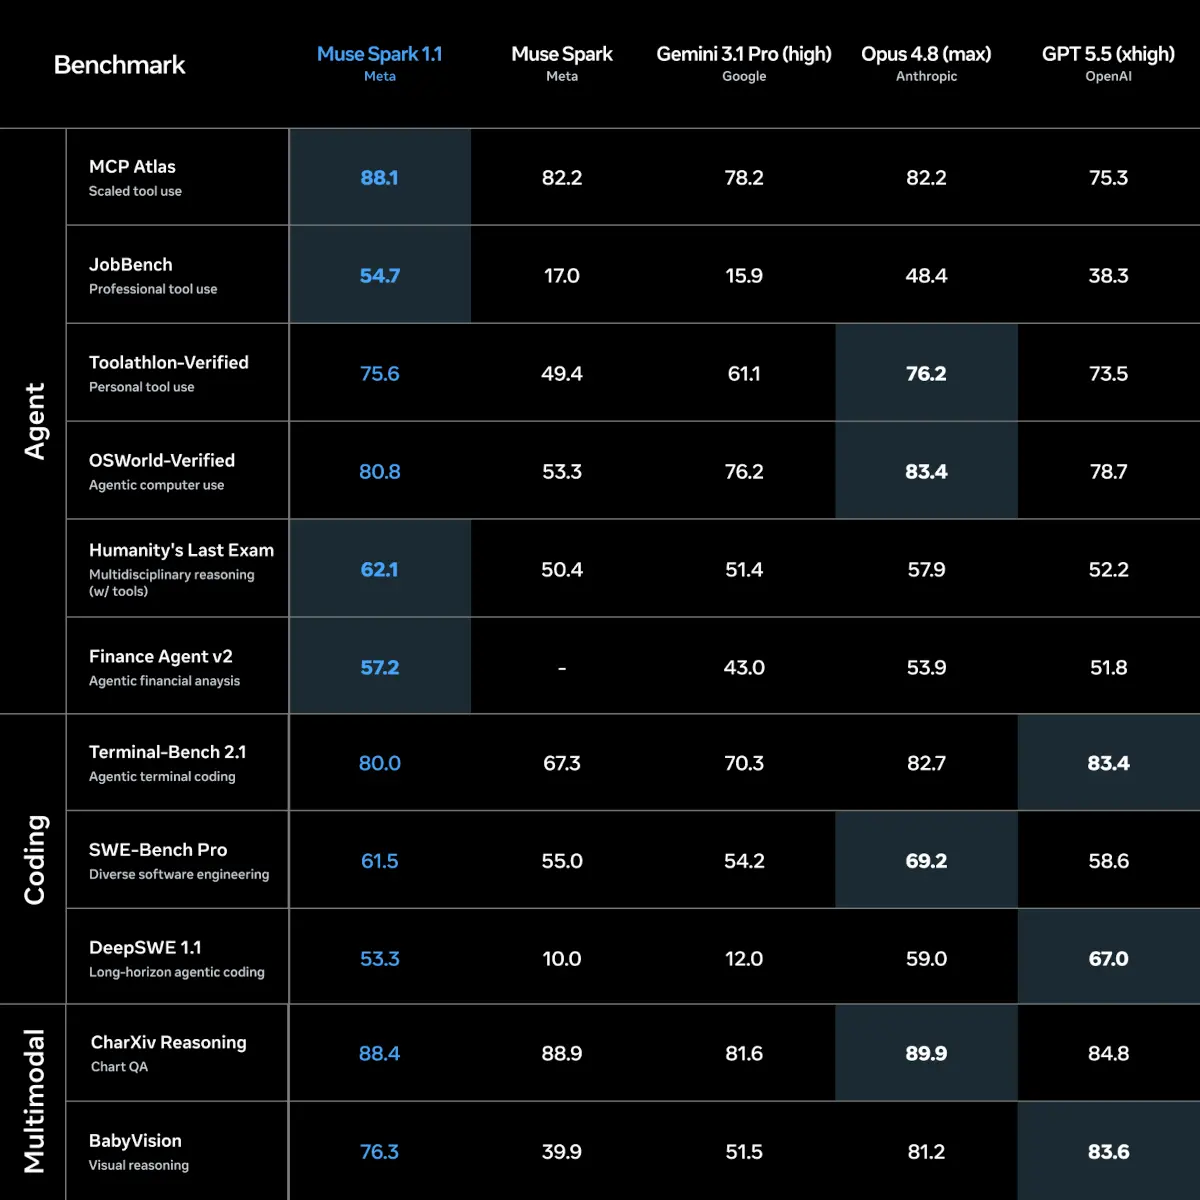
Pour Meta, convaincre davantage d’utilisateurs de partager ces traces pourrait donc accélérer sensiblement le développement de Muse Spark.
Le problème devient plus compliqué hors du développement logiciel
Le code constitue toutefois un cas presque idéal pour les agents. Les actions sont numériques, enregistrables et relativement faciles à évaluer. Un programme compile ou non, un test réussit ou échoue, un fichier est modifié correctement ou pas.
Dans d’autres professions, les signaux sont beaucoup moins évidents. Un agent chargé d’aider un consultant, un juriste, un commercial ou un responsable marketing peut intervenir dans un workflow composé de documents, réunions, emails, outils SaaS et décisions humaines difficiles à quantifier. Il existe alors beaucoup moins de traces exploitables permettant de déterminer automatiquement ce qui constitue une bonne trajectoire.
C’est précisément là que les données issues des utilisateurs peuvent devenir extrêmement précieuses. Les laboratoires d’IA veulent déployer des agents dans un nombre croissant de métiers, mais ils ont besoin d’exemples de ces processus professionnels pour apprendre à les reproduire correctement. La difficulté est que ces données sont souvent beaucoup plus sensibles que du code open source.
Les entreprises restent très réticentes à partager leurs données
Cette tension explique aussi pourquoi les grandes entreprises privilégient généralement des offres professionnelles plus coûteuses.
Comme le souligne le chercheur Arvind Narayanan, les organisations continuent souvent de payer des offres Enterprise facturées à l’usage alors que certaines formules grand public peuvent offrir beaucoup plus de calcul pour un prix apparent inférieur.
La différence ne vient pas uniquement de la puissance du modèle. Les offres professionnelles apportent généralement des garanties sur la rétention des données, la gouvernance informatique, les contrôles administrateurs et l’utilisation des contenus pour l’entraînement.
Pour une entreprise manipulant du code propriétaire, des contrats, des informations clients ou des documents stratégiques, ces garanties peuvent valoir beaucoup plus que la réduction obtenue sur les tokens.
Meta semble avoir parfaitement identifié ce problème. Au lieu d’espérer que les entreprises accepteront simplement de partager leurs données, l’entreprise introduit une incitation financière suffisamment forte pour les amener à examiner plus précisément ce qui peut réellement être partagé.
Un précédent interne montre à quel point Meta cherche des données
Cette stratégie arrive après une autre initiative beaucoup plus controversée. Meta avait lancé plus tôt dans l’année un projet visant à observer certains usages informatiques de ses propres employés afin d’obtenir davantage de données sur les workflows réels. Le programme avait suscité de fortes critiques en interne et avait finalement été suspendu en juin pendant l’examen de questions liées à la sécurité des données.
Le nouvel accord autour de Muse Spark adopte une logique nettement différente. Cette fois, le consentement est explicite et directement associé à une compensation économique.
Ce changement est important, car il permet à Meta d’éviter une partie du malaise créé lorsque la collecte de données semble imposée ou insuffisamment transparente.
Le modèle « contributor » transforme au contraire la relation en transaction : l’utilisateur sait ce qu’il cède et voit immédiatement ce qu’il reçoit en échange.
Les entreprises pourraient devoir mieux classifier leurs propres données
Cette approche pourrait avoir une conséquence intéressante au sein même des organisations. Beaucoup d’entreprises appliquent aujourd’hui des politiques très larges interdisant tout entraînement sur leurs données, même lorsqu’une partie des contenus utilisés n’a rien de réellement confidentiel.
Une réduction de 90 ou 95 % peut inciter les équipes à faire davantage de distinction. Le code d’un produit stratégique restera évidemment protégé. En revanche, certains prototypes, données synthétiques, tâches publiques ou workloads internes non sensibles pourraient éventuellement être exécutés sous le tarif contributor. Cela obligerait les entreprises à mieux classifier l’information.
Paradoxalement, la stratégie de Meta pourrait donc renforcer la gouvernance des données en rendant visible leur valeur économique. Lorsqu’une organisation sait précisément combien elle peut économiser en partageant certaines informations, elle est davantage incitée à déterminer lesquelles sont réellement sensibles.
Le prix devient une nouvelle arme dans la bataille des modèles
Cette politique intervient également dans un contexte de compétition tarifaire croissante entre les grands laboratoires. Les derniers modèles d’Anthropic ont réduit certains coûts liés aux tokens mis en cache, tandis qu’OpenAI a récemment abaissé le prix de plusieurs de ses modèles.
À mesure que les performances convergent sur certaines tâches, le coût devient un critère de différenciation beaucoup plus important.
Meta pousse toutefois cette logique dans une direction différente. Au lieu de réduire uniformément ses tarifs, l’entreprise propose un prix extrêmement bas lorsque l’utilisateur fournit en retour quelque chose dont elle a besoin : des données d’utilisation réelles.
Cette stratégie peut être particulièrement efficace auprès des startups et développeurs qui disposent de peu de données sensibles et cherchent avant tout à minimiser leurs coûts d’infrastructure.
Pour les grandes entreprises, l’arbitrage restera beaucoup plus délicat.
Meta transforme la confidentialité en variable économique
Le plus intéressant dans la politique de Muse Spark n’est finalement pas la réduction elle-même, mais ce qu’elle révèle sur l’économie de l’IA. Pendant plusieurs années, les fournisseurs ont souvent traité les données d’usage comme une ressource annexe, obtenue par défaut ou via des programmes d’amélioration facultatifs.
Meta choisit désormais de les valoriser explicitement. Cette transparence a un mérite : elle montre clairement qu’un prompt professionnel, une trajectoire d’agent ou un résultat corrigé peuvent avoir une valeur pour le développeur du modèle.
Mais elle ouvre aussi une nouvelle question. Si les données permettent d’obtenir 95 % de réduction, alors le prix réel d’un service IA ne se mesure plus uniquement en dollars par million de tokens. Il dépend aussi de la quantité d’informations que l’utilisateur accepte de céder.
Avec Muse Spark, Meta ne se contente donc pas de lancer une guerre des prix : l’entreprise commence à donner un tarif concret à la confidentialité elle-même.