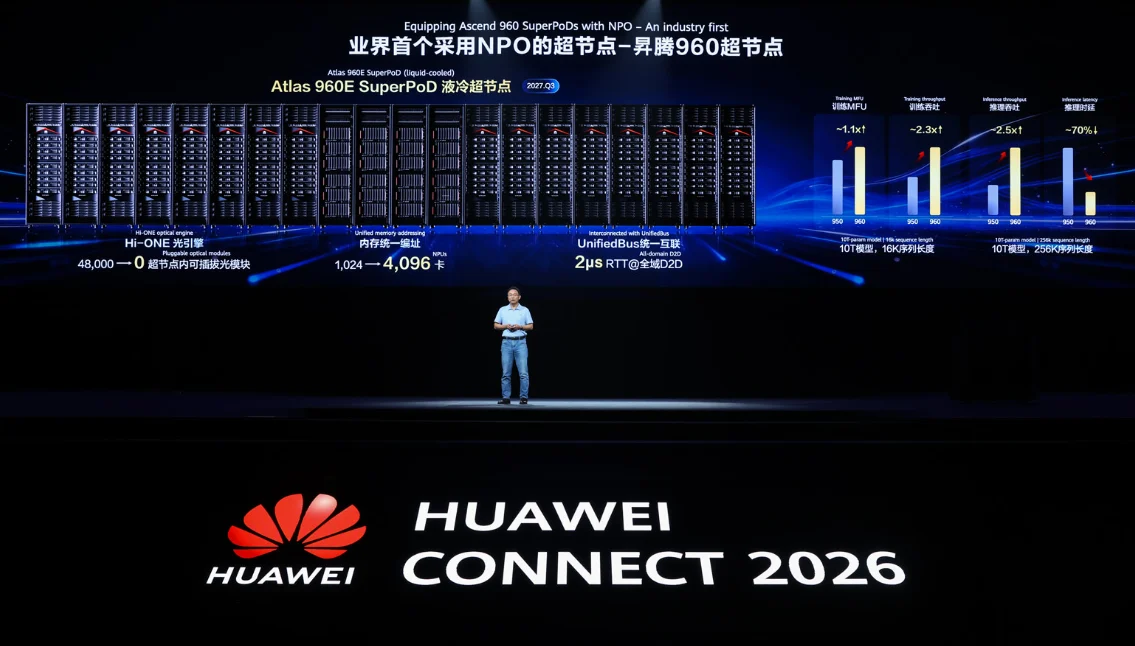

Huawei poursuit la construction de sa propre infrastructure pour l’intelligence artificielle à très grande échelle. À l’occasion du Huawei Connect 2026 à Shanghai, le groupe chinois a dévoilé le Atlas 960E SuperPoD, un système capable de réunir jusqu’à 4 096 accélérateurs Ascend et conçu pour entraîner ou exécuter des modèles approchant les 10 000 milliards de paramètres.
Attendu au troisième trimestre 2027, le Atlas 960E ne mise pas uniquement sur la puissance des puces. Huawei concentre une grande partie de ses efforts sur les interconnexions avec UnifiedBus et surtout sur un nouveau moteur optique Hi-ONE utilisant le Near-Packaged Optics (NPO). L’objectif est clair : à mesure que les clusters IA deviennent gigantesques, déplacer les données entre les accélérateurs devient presque aussi stratégique que leur puissance de calcul individuelle.
Atlas 960E : Huawei prépare l’infrastructure des modèles à 10 000 milliards de paramètres
Présenté le 17 septembre, le Atlas 960E représente la prochaine évolution de l’architecture SuperPoD de Huawei. L’entreprise le présente comme le premier système de cette catégorie reposant sur une architecture optique NPO.
Un seul Atlas 960E peut réunir jusqu’à 4 096 processeurs Ascend au sein d’un ensemble conçu pour se comporter davantage comme une immense machine unifiée que comme une collection de serveurs indépendants. Huawei annonce une puissance maximale de 8 EFLOPS en FP8 et 16 EFLOPS en FP4. Ces niveaux de précision réduite sont particulièrement importants pour les charges d’intelligence artificielle, où ils permettent d’augmenter considérablement le débit de calcul tout en limitant les besoins en mémoire et en énergie.
L’entreprise vise des modèles dont la taille pourrait approcher les 10 000 milliards de paramètres. Il ne s’agit naturellement pas d’annoncer qu’un tel modèle sera systématiquement exécuté sur une seule machine, mais de dimensionner l’infrastructure pour la prochaine génération de charges d’entraînement et d’inférence distribuées.
Le système utilise par ailleurs un refroidissement entièrement liquide ainsi qu’une architecture orthogonale, deux choix directement liés à la densité exceptionnelle de calcul recherchée.
UnifiedBus veut faire fonctionner des milliers de puces comme une seule machine
La puissance théorique ne représente qu’une partie du problème lorsqu’un système rassemble plusieurs milliers d’accélérateurs. Plus le nombre de puces augmente, plus les communications entre elles deviennent critiques. Si un accélérateur passe une part importante de son temps à attendre des données provenant d’un autre nœud, ajouter davantage de processeurs ne produit plus une augmentation proportionnelle des performances.
Huawei s’appuie pour cela sur UnifiedBus, également appelé Lingqu.
Cette technologie repose notamment sur un système d’adressage mémoire unifié destiné à permettre aux différentes ressources de calcul d’accéder plus efficacement aux données. L’objectif consiste à rapprocher le fonctionnement du SuperPoD de celui d’un système cohérent disposant d’un immense ensemble de ressources partagées.
Cette approche devient particulièrement importante avec les modèles IA modernes. L’entraînement d’un modèle de plusieurs milliers de milliards de paramètres nécessite de répartir simultanément les poids, les activations et les opérations entre un très grand nombre d’accélérateurs.
La performance d’un cluster dépend alors autant de sa capacité à déplacer les données que de celle à effectuer des multiplications matricielles. C’est précisément pourquoi Huawei associe UnifiedBus à une nouvelle architecture optique.
Hi-ONE remplace près de 48 000 modules optiques 800G
L’une des innovations centrales de le Atlas 960E est son moteur optique Hi-ONE NPO. Huawei annonce pour chaque unité une capacité de transmission atteignant 7,2 Tbit/s, avec une source lumineuse directement intégrée. Le système complet utilise environ 5 500 moteurs Hi-ONE. Selon le constructeur, cette architecture permet de remplacer approximativement 48 000 modules optiques traditionnels 800G qui auraient autrement été nécessaires pour assurer les communications internes à une telle échelle.
La différence ne concerne pas uniquement l’encombrement.
Huawei affirme que cette conception permet de réduire la consommation électrique de plus de 550 kW. L’entreprise revendique également un doublement du temps de fonctionnement sans panne ainsi qu’une disponibilité globale du système atteignant 99,8 %.
Ces chiffres restent des données communiquées par Huawei et devront être confrontés aux performances observées lorsque l’Atlas 960E sera effectivement déployé. Ils illustrent néanmoins l’importance prise par les interconnexions optiques dans les infrastructures IA.
À plusieurs milliers d’accélérateurs, les dizaines de milliers de connexions nécessaires peuvent représenter une part considérable de la consommation, du coût et des points potentiels de défaillance. Réduire le nombre de modules tout en augmentant la bande passante peut donc améliorer simultanément la densité, l’efficacité énergétique et la fiabilité.
Huawei veut pousser le SuperPoD jusqu’à un million d’accélérateurs Ascend
Le Atlas 960E ne représente qu’un niveau de l’architecture imaginée par Huawei. Plusieurs SuperPoD pourront être reliés entre eux grâce à UnifiedBus et RoCE afin de former des clusters beaucoup plus importants. Huawei indique que son architecture peut interconnecter jusqu’à 512 000 accélérateurs IA. Une topologie multi-rail doit permettre d’aller encore plus loin, avec un Ascend SuperCluster pouvant atteindre un million de processeurs.
À cette échelle, le défi change complètement de nature. Le nombre brut d’accélérateurs devient moins significatif si le réseau ne permet pas de les exploiter efficacement ou si les pannes individuelles perturbent constamment l’ensemble.
La disponibilité annoncée de 99,8 % pour le Atlas 960E prend ainsi une importance particulière. Dans une infrastructure comprenant des centaines de milliers de composants, les défaillances ne constituent plus un événement exceptionnel : elles deviennent une situation que l’architecture doit être capable d’absorber.
Huawei étend d’ailleurs cette logique au calcul généraliste avec son TaiShan 950 SuperPoD amélioré. Celui-ci doit prendre en charge jusqu’à 4 096 nœuds et proposer un pool de mémoire unifiée atteignant 256 To. Le OceanStor M900 complète l’ensemble avec un système de cache clé-valeur à l’échelle du pétaoctet destiné aux charges IA.
Une feuille de route Ascend qui s’étend jusqu’en 2029
Le Atlas 960E est prévu pour le troisième trimestre 2027, mais Huawei prépare plusieurs générations d’accélérateurs autour de cette infrastructure. Le Ascend 960DT est annoncé pour le premier trimestre 2027, tandis que l’Ascend 960PR doit suivre au troisième trimestre de la même année. Huawei prévoit ensuite l’Ascend 970 en 2028 et l’Ascend 980 en 2029.
Cette cadence montre que Huawei ne cherche plus simplement à développer une puce capable de rivaliser avec les accélérateurs étrangers. L’entreprise construit simultanément les processeurs, les interconnexions, les systèmes optiques, les architectures de calcul et les infrastructures de stockage nécessaires pour les exploiter à grande échelle.
L’Atlas 960E est probablement l’une des meilleures illustrations de cette stratégie. Sa proposition ne repose pas sur un accélérateur Ascend isolé capable de surpasser tous ses concurrents. Huawei cherche plutôt à obtenir davantage de performances en faisant travailler ensemble un nombre considérable de puces et en réduisant les goulots d’étranglement entre elles. C’est une logique de compétition au niveau du système, plutôt qu’au seul niveau du silicium.
L’interconnexion devient le véritable champ de bataille de l’IA
La montée en puissance des SuperPoD montre comment l’industrie de l’intelligence artificielle est en train de changer d’échelle. Pendant plusieurs années, l’attention s’est concentrée sur les performances individuelles des GPU et autres accélérateurs. Cette métrique reste essentielle, mais les plus grands modèles nécessitent désormais tellement de processeurs que l’architecture qui les relie devient tout aussi déterminante.
Un cluster de 4 096 accélérateurs mal interconnectés ne peut pas exploiter efficacement sa puissance théorique. À 512 000 ou un million de processeurs, cette problématique devient centrale.
C’est pourquoi Huawei met autant en avant UnifiedBus et Hi-ONE que les 16 EFLOPS de son Atlas 960E. La réduction du nombre de modules optiques, la bande passante de 7,2 Tbit/s et l’adressage mémoire unifié répondent tous au même problème : maintenir les données en mouvement suffisamment rapidement pour que les accélérateurs restent occupés.
L’Atlas 960E n’arrivera toutefois pas avant 2027 et les performances annoncées restent pour l’instant celles du constructeur. Le véritable test viendra lorsque ces systèmes devront démontrer leur efficacité sur de grands entraînements réels, avec leurs contraintes de consommation, de disponibilité et de montée en charge.
Huawei semble néanmoins avoir identifié l’une des prochaines frontières de l’IA : lorsque les modèles deviennent trop grands pour une machine, la puissance ne dépend plus seulement des puces que l’on possède, mais de la capacité à faire fonctionner des milliers — puis potentiellement un million — de ces puces comme si elles n’en formaient qu’une seule.