
Google accélère sur les assistants vocaux avec Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking, deux nouveaux modèles conçus pour mener des conversations naturelles tout en exécutant des tâches complexes en arrière-plan. La seconde version pousse le concept plus loin en combinant parole et raisonnement multi-étapes en temps réel.
L’enjeu dépasse la simple amélioration de Gemini Live. Google veut fournir aux développeurs et aux entreprises les fondations nécessaires pour construire de véritables agents vocaux, capables de voir, parler, utiliser des outils et naviguer entre 97 langues sans interrompre la conversation.
Deux modèles Gemini pensés pour des usages différents
Google décline sa nouvelle génération autour de deux variantes aux priorités distinctes. Gemini 3.8 Live est h conçu pour fonctionner à grande échelle tout en maîtrisant les coûts. Google met en avant sa fluidité conversationnelle, son intelligence générale et sa capacité à exploiter des informations visuelles pendant une conversation.
Gemini 3.8 Live Extended Thinking cible davantage les scénarios nécessitant plusieurs étapes de raisonnement. Le modèle dispose de capacités supplémentaires pour analyser une demande complexe, organiser les actions nécessaires et exécuter des tâches successives tout en maintenant le dialogue avec l’utilisateur.
Cette distinction est importante pour les entreprises. Un assistant chargé de répondre à une question simple n’a pas besoin de mobiliser le même niveau de calcul qu’un agent devant consulter plusieurs systèmes, vérifier des informations et réaliser différentes opérations avant de formuler sa réponse.
Google peut ainsi proposer une architecture où le modèle utilisé dépend de la complexité de la tâche, avec une version optimisée pour le volume et une autre privilégiant davantage le raisonnement.
Gemini peut désormais parler pendant qu’il travaille
L’une des évolutions les plus intéressantes concerne la manière dont les modèles gèrent l’exécution d’outils.
Gemini 3.8 Live peut lancer des appels vers des API ou d’autres outils en arrière-plan tout en poursuivant la conversation. Le modèle peut donc confirmer qu’il a compris une demande, continuer à dialoguer avec l’utilisateur et attendre que les différentes opérations se terminent sans imposer un silence artificiel.
Gemini 3.8 Live Extended Thinking pousse cette logique encore plus loin. Google explique que le modèle peut raisonner et parler simultanément, notamment lorsqu’une tâche nécessite plusieurs étapes.
L’assistant peut utiliser de courtes interventions pour signaler qu’il vérifie une information, puis commenter la progression de son travail pendant que les opérations nécessaires sont exécutées en arrière-plan.
Cela peut sembler être une évolution mineure, mais elle répond à l’un des problèmes fondamentaux des agents vocaux. Lorsqu’un humain demande quelque chose à une personne, il interprète naturellement les silences, les hésitations ou les confirmations. Une IA qui reste muette plusieurs secondes pendant qu’elle utilise un outil donne au contraire facilement l’impression d’avoir cessé de fonctionner.
Le défi sera de trouver le bon équilibre. Une narration permanente des étapes internes pourrait rapidement devenir fatigante, tandis qu’un retour contextuel suffisamment discret peut rendre l’interaction beaucoup plus naturelle.
Jusqu’à 97 langues et une compréhension visuelle en temps réel
Gemini 3.8 Live ne se limite pas à l’audio. Le modèle peut également traiter des informations visuelles presque en temps réel afin de les intégrer directement dans une conversation. Cette capacité permet d’imaginer un assistant auquel l’utilisateur montre un objet, un document ou son environnement tout en lui posant des questions oralement. La caméra devient alors une source de contexte supplémentaire plutôt qu’un simple moyen de prendre une photographie.
Google annonce également la prise en charge de 97 langues, avec détection automatique et possibilité de passer de l’une à l’autre pendant une même conversation. Cette gestion dynamique pourrait être particulièrement intéressante pour la traduction, les environnements professionnels internationaux ou les conversations multilingues.
Ces fonctions rapprochent progressivement Gemini d’un assistant multimodal permanent. Au lieu de fonctionner selon une succession de requêtes textuelles indépendantes, le modèle doit maintenir un contexte continu composé de parole, d’images, d’actions et de résultats provenant d’outils externes.
Google étend parallèlement ces interactions vocales à plusieurs de ses services. Les nouveaux modèles doivent alimenter Gemini dans l’application dédiée, mais également certaines expériences dans Search et Google Workspace.
Google revendique de solides performances pour Gemini 3.8 Live Extended Thinking
Google accompagne cette annonce de plusieurs résultats obtenus par Gemini 3.8 Live Extended Thinking sur des benchmarks consacrés aux agents vocaux.
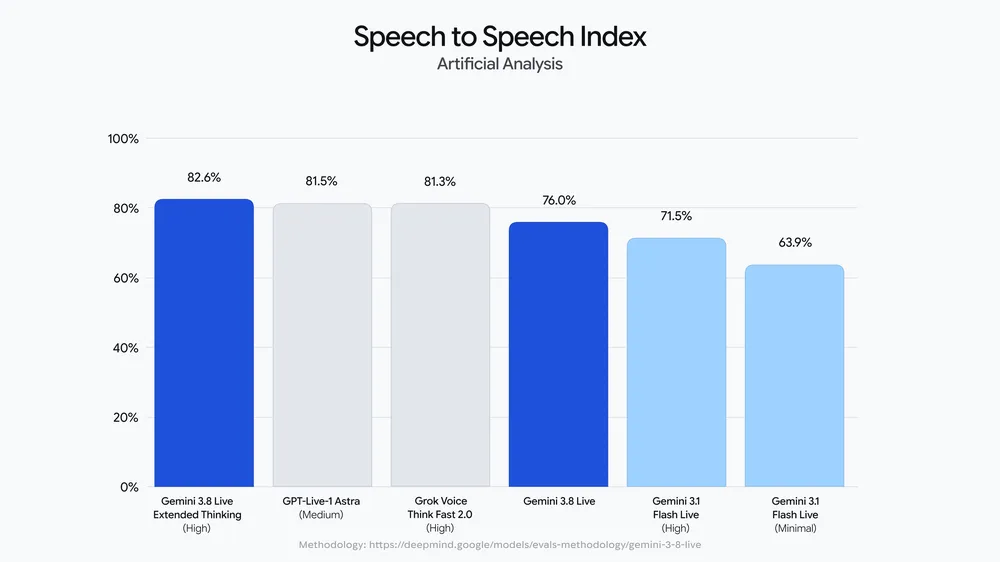
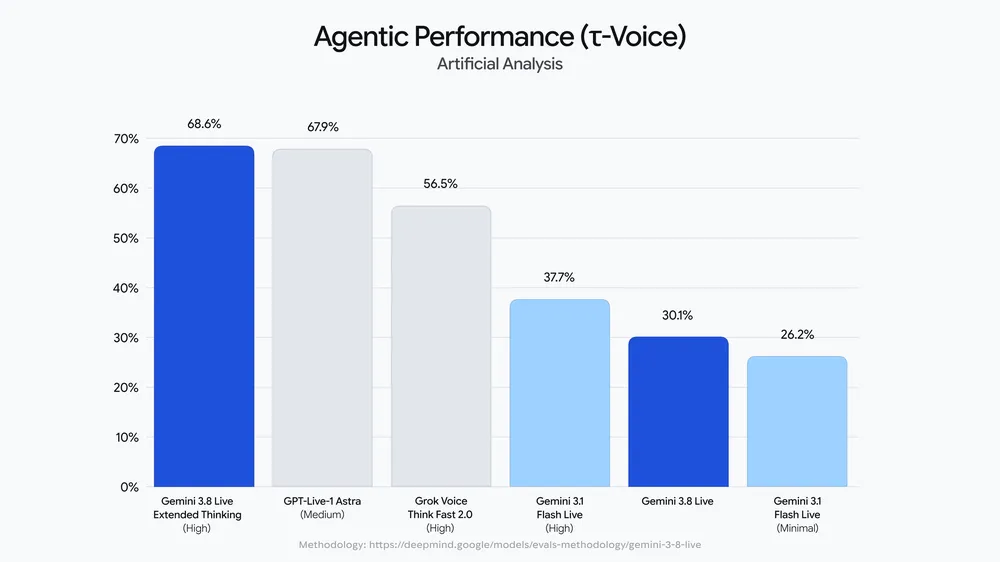
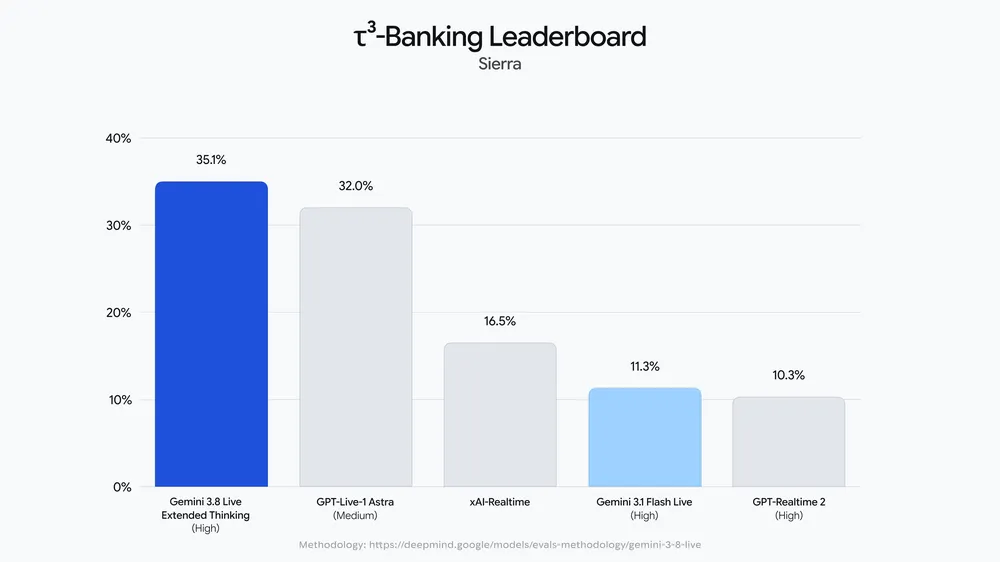
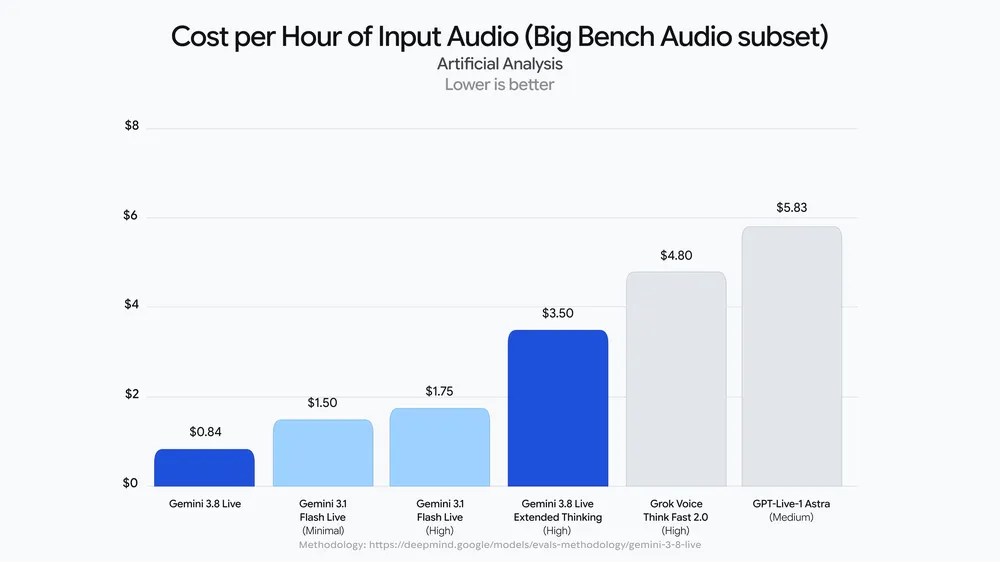
Le modèle atteint 82,6 points sur le Speech to Speech Quality Index d’Artificial Analysis, un résultat qui le placerait en première position du classement cité par Google. Il obtient également 68,6 % sur τ-Voice pour l’exécution de tâches agentiques, 35,1 % sur la déclinaison bancaire de τ-Voice utilisée par Sierra et 97,7 % sur Big Bench Audio.
Gemini 3.8 Live se classe de son côté deuxième dans le Speech Agent Arena selon les résultats mis en avant par l’entreprise.
Google cite également les évaluations réalisées avec EVA-Bench de ServiceNow, consacré aux agents vocaux. L’entreprise estime que ses modèles améliorent le compromis entre précision dans les workflows complexes et qualité de la conversation.
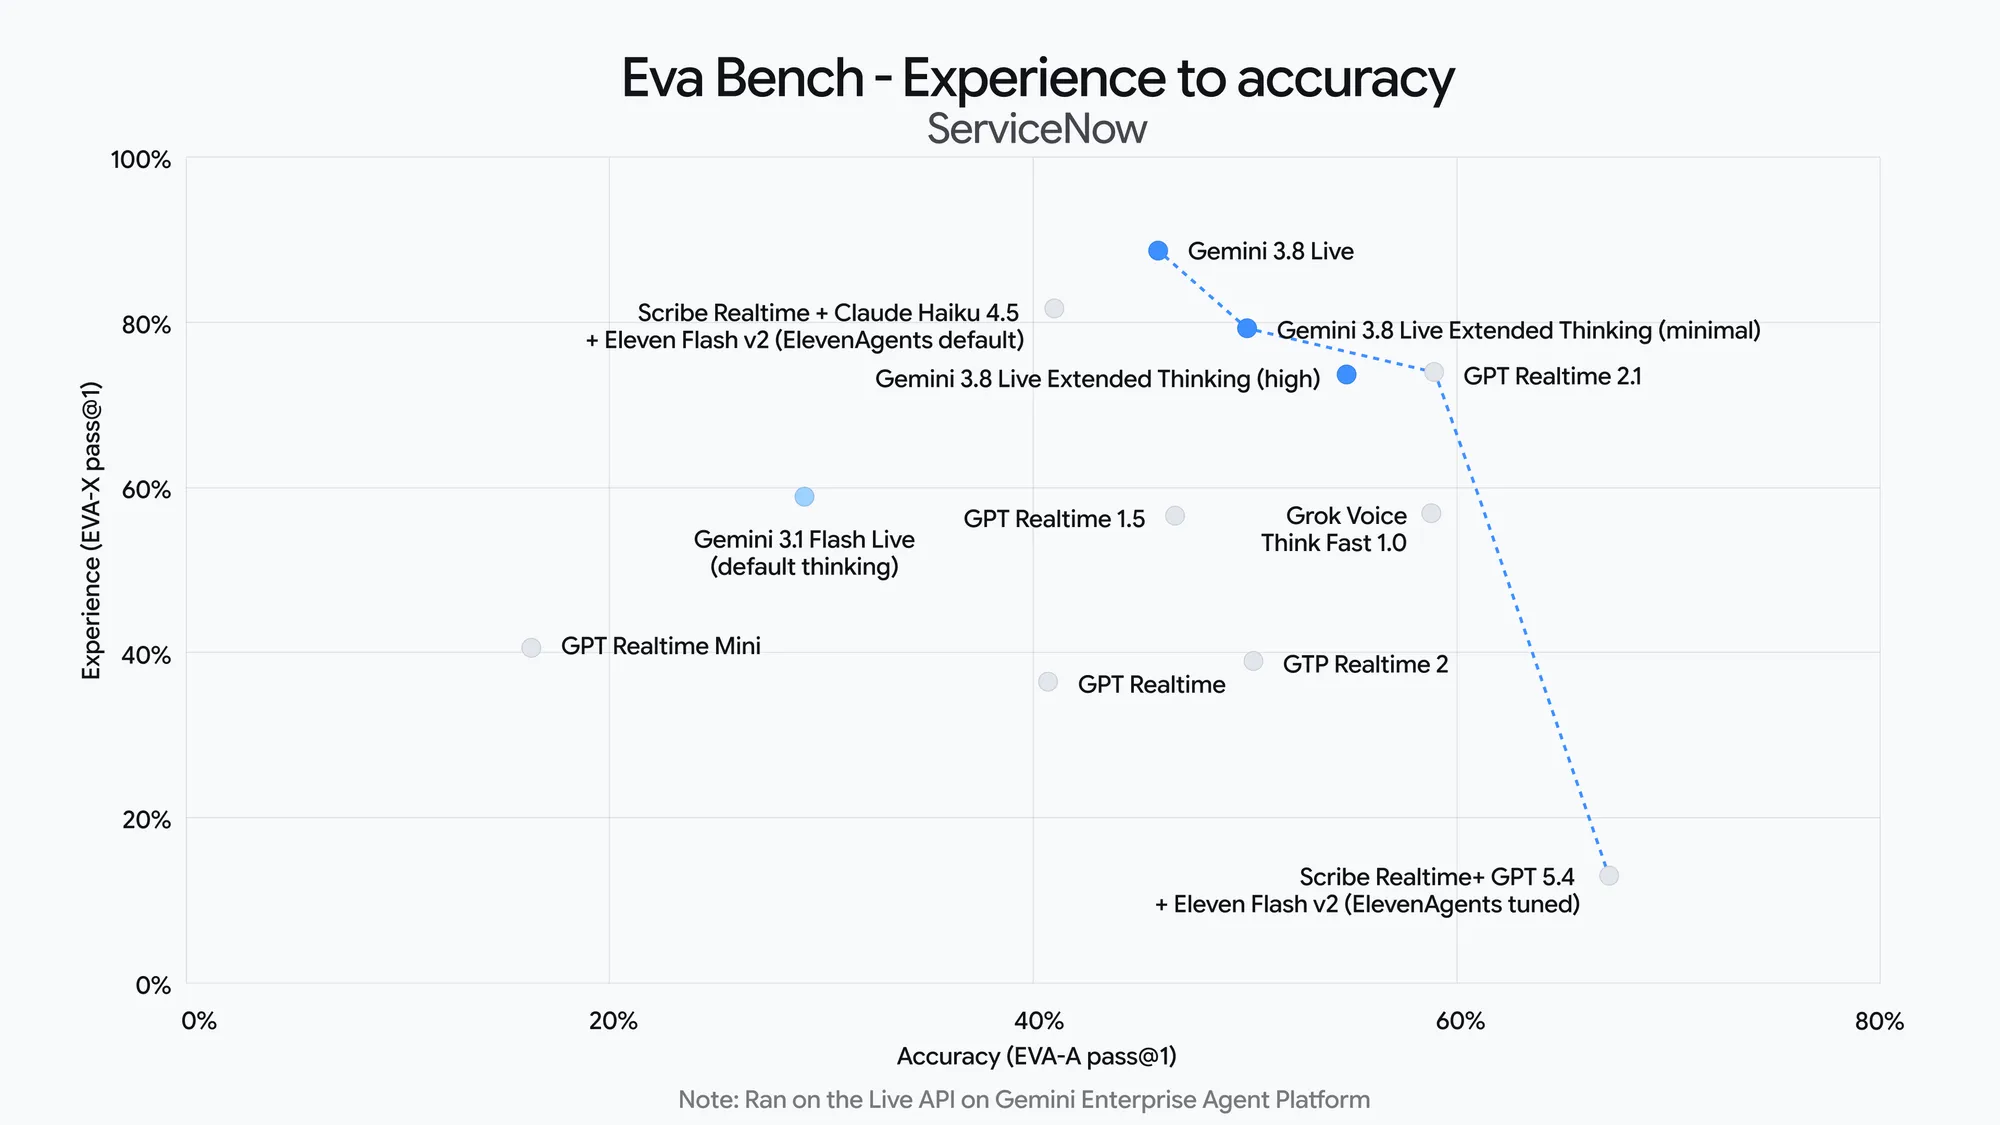
Ces résultats restent à replacer dans leur contexte : il s’agit de benchmarks sélectionnés et communiqués par Google, et les performances réelles dépendront fortement des applications, des outils connectés et des conditions d’utilisation. Pour un agent vocal, quelques centaines de millisecondes de latence supplémentaires ou une mauvaise gestion d’une interruption peuvent parfois être plus perceptibles qu’une différence de score sur un test synthétique.
Google prépare surtout une plateforme pour les agents vocaux
L’annonce prend une dimension plus importante avec la Gemini Live API. Google ne cherche pas uniquement à améliorer son propre assistant. L’entreprise veut permettre à d’autres sociétés de construire des expériences vocales à partir des mêmes modèles.
L’écosystème annoncé comprend notamment Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel et Vision Agents. Ces plateformes peuvent prendre en charge une partie de l’infrastructure complexe nécessaire au streaming audio et vidéo en temps réel, laissant les développeurs se concentrer davantage sur la logique et l’expérience utilisateur.
Google travaille également avec Salesforce, Genspark et Lumeris, qui expérimentent notamment la latence, la fluidité conversationnelle et les capacités d’appel d’outils des nouveaux modèles.
Cette stratégie montre où se situe probablement la véritable bataille de l’IA vocale. Il ne suffit plus de proposer une voix réaliste capable de répondre à une question. Les entreprises cherchent désormais des agents susceptibles de consulter un dossier client, déclencher une opération, remplir un formulaire ou coordonner plusieurs services pendant une conversation.
Le modèle vocal devient alors l’interface d’un système beaucoup plus vaste.
SynthID doit permettre d’identifier les voix générées par Google
La généralisation de voix synthétiques toujours plus naturelles pose parallèlement un problème évident d’authenticité. Google indique que tous les contenus audio générés par ses produits d’IA intègrent SynthID. Ce filigrane imperceptible est incorporé directement dans le signal audio afin de permettre l’identification ultérieure d’un contenu produit par intelligence artificielle.
L’objectif est notamment de limiter les risques liés à la désinformation et à l’utilisation de voix synthétiques hors contexte. Google accompagne également ses nouveaux modèles d’une model card détaillant ses travaux autour de la sécurité et de l’utilisation responsable.
SynthID ne résout évidemment pas à lui seul la question des deepfakes audio. Son efficacité dépend notamment de la capacité des plateformes et des outils de vérification à détecter le marquage, ainsi que de sa résistance aux différentes transformations appliquées au fichier.
Son intégration systématique montre néanmoins que la provenance des contenus devient progressivement une composante technique des modèles génératifs, et non plus seulement une politique appliquée après leur déploiement.
Gemini 3.8 Live se déploie dans l’écosystème Google
Les deux modèles suivent des calendriers de disponibilité différents selon les usages. Gemini 3.8 Live est disponible pour les développeurs via la Gemini API et Google AI Studio. Il arrive également en préversion privée dans Gemini Enterprise, avec une intégration prévue dans Gemini Enterprise for Customer Experience. Pour le grand public, le modèle est utilisé dans Search Live.
Gemini 3.8 Live Extended Thinking est lui aussi accessible via la Gemini API et Google AI Studio. Les entreprises peuvent l’expérimenter en préversion privée dans Gemini Enterprise, avant son arrivée prévue dans Customer Experience et auprès des clients professionnels de Google Workspace.
Pour les particuliers, Extended Thinking est proposé dans Gemini Live. Google l’étend également à Workspace, notamment dans Docs pour les abonnés Google AI Pro et Ultra, ainsi que dans Gmail et Keep pour les abonnés Google AI concernés.
Cette distribution montre que Google ne considère plus la voix comme une simple modalité supplémentaire de Gemini. Elle devient progressivement une interface commune entre Search, Workspace, les applications grand public et les futurs agents développés par des entreprises tierces.
Avec Gemini 3.8 Live, la prochaine étape de l’assistant vocal n’est donc pas simplement de parler avec une voix plus humaine. Elle consiste à continuer la conversation pendant que l’IA raisonne, observe et agit — jusqu’à faire disparaître progressivement la frontière entre dialogue et exécution.